Autor: ciberkaos

  • Proyecto Loot Figures — Parte 1: implantación en XAMPP y Ubuntu Server

    Proyecto Loot Figures — Parte 1: implantación en XAMPP y Ubuntu Server

    1. Presentación del proyecto

    En esta actividad vamos a implantar Loot Figures, una tienda web de figuras de plástico inspiradas en personajes de videojuegos.

    La aplicación ya está desarrollada. Nuestro trabajo consistirá en examinar sus archivos, preparar los entornos necesarios, configurar la base de datos y conseguir que funcione en dos instalaciones diferentes:

    1. En nuestro ordenador, utilizando XAMPP.
    2. En la máquina virtual Ubuntu Server que hemos preparado en clase.

    Además de conseguir que la tienda se abra en el navegador, tendremos que comprobar sus funciones y documentar el procedimiento.

    Implantar una aplicación no consiste únicamente en copiar archivos. También debemos identificar sus requisitos, configurar los servicios, preparar la base de datos, ajustar permisos y comprobar que todo funciona correctamente.


    2. Objetivos de aprendizaje

    Al terminar esta primera parte, deberás ser capaz de:

    • Identificar los archivos y las carpetas de una aplicación PHP.
    • Abrir un proyecto completo en VS Code o PhpStorm.
    • Reconocer la función de los modelos, los DAO y los archivos que reciben datos.
    • Diferenciar el código PHP del código que ejecuta el navegador.
    • Preparar un entorno con Apache, PHP y MySQL o MariaDB.
    • Crear una base de datos e importar su estructura.
    • Configurar la conexión entre PHP y la base de datos.
    • Ejecutar un script de carga de datos.
    • Configurar Apache para servir la carpeta pública del proyecto.
    • Implantar la misma aplicación en Windows y Ubuntu Server.
    • Comprobar su funcionamiento y resolver incidencias.
    • Elaborar documentación técnica que permita repetir la instalación.

    3. Material necesario

    Para realizar la actividad necesitarás:

    • El archivo del proyecto: loot-figures-php-clase.zip.
    • Un ordenador con XAMPP.
    • VS Code o PhpStorm.
    • Un navegador web.
    • La máquina virtual Ubuntu Server utilizada en clase.
    • Un usuario de Ubuntu con permisos para ejecutar sudo.
    • Conexión entre tu ordenador y la máquina virtual.

    La aplicación utiliza PHP 8.x, una base de datos MySQL o MariaDB y las extensiones PHP necesarias para trabajar con mysqli, sesiones y archivos.

    En esta primera parte no utilizaremos Docker. Vamos a preparar los servicios directamente para comprender qué necesita la aplicación.

    4. Resultado que debes conseguir

    Al finalizar, tendrás dos instalaciones independientes:

    EntornoAplicaciónBase de datosAcceso
    Ordenador con XAMPPCopia local del proyectoBase de datos de XAMPPhttp://localhost:8080
    Máquina virtual Ubuntu ServerCopia del proyecto en el servidorBase de datos de Ubuntuhttp://IP_DEL_SERVIDOR:8080

    Cada instalación tendrá su propia base de datos.

    Los cambios realizados en una instalación no aparecerán automáticamente en la otra.

    Utilizaremos el puerto 8080 para la tienda. De esta forma, podemos conservar las páginas o servicios que ya estén utilizando el puerto 80.


    Bloque A. Examinar el proyecto antes de instalarlo

    5. Descargar y descomprimir los archivos

    Descarga el ZIP proporcionado por el profesor y descomprímelo.

    La carpeta principal del proyecto se llama:

    loot-figures-clase

    Comprueba que dentro aparecen, entre otras, estas carpetas:

    app
    config
    database
    docs
    public
    scripts

    No comiences modificando archivos. Primero vamos a identificar qué contiene el proyecto.

    6. Abrir el proyecto en VS Code o PhpStorm

    Opción A: VS Code

    1. Abre VS Code.
    2. Selecciona Archivo → Abrir carpeta.
    3. Elige la carpeta principal loot-figures-clase.
    4. Comprueba que aparecen todas las carpetas del proyecto en el explorador lateral.
    5. Abre el archivo README.md.

    Opción B: PhpStorm

    1. Abre PhpStorm.
    2. Selecciona Open / Abrir.
    3. Elige la carpeta principal loot-figures-clase.
    4. Espera a que termine de analizar el proyecto.
    5. Abre el archivo README.md.

    Debes abrir la carpeta completa, no únicamente un archivo PHP ni solo la carpeta public.

    El editor nos permite consultar y modificar el código. Para ejecutar la aplicación necesitaremos un servidor PHP.

    7. Reconocer las carpetas del proyecto

    Examina la estructura y completa una tabla como esta en tu documentación:

    Carpeta o archivo¿Para qué sirve?
    app/modelosClases que representan clientes, productos, pedidos y mensajes
    app/daoClases que realizan las consultas a la base de datos
    app/Conexion.phpCódigo que abre la conexión con MySQL mediante mysqli
    configConfiguración de la aplicación
    database/schema.sqlInstrucciones SQL para crear las tablas
    publicArchivos que debe servir Apache al navegador
    public/apiArchivos PHP que reciben peticiones y devuelven datos
    public/partialsPartes comunes: cabecera, navegación y pie
    public/assetsJavaScript, CSS, logo e imágenes
    public/uploadsImágenes subidas desde la administración
    scripts/seed.phpScript que introduce los datos de ejemplo
    docsDocumentación del proyecto

    Preguntas que debes responder

    1. ¿Qué diferencia hay entre app/modelos y app/dao?
    2. ¿Qué archivo contiene la configuración de la base de datos?
    3. ¿Qué carpeta debe publicar Apache?
    4. ¿Por qué la configuración y los scripts de instalación no deben quedar dentro del directorio público?
    5. ¿Qué diferencia hay entre un archivo PHP y un archivo JavaScript?
    6. ¿Qué función tienen header.php, nav.php y footer.php?

    8. Seguir una operación sencilla

    Abre estos archivos:

    public/api/contacto.php
    app/modelos/Mensaje.php
    app/dao/MensajeDAO.php

    Localiza el recorrido de los datos:

    1. Se reciben los datos del formulario.
    2. Se validan.
    3. Se crea un objeto Mensaje.
    4. Se crea el DAO.
    5. El DAO inserta el mensaje en la base de datos.
    6. PHP devuelve una respuesta JSON.

    Identifica estas instrucciones:

    $mensaje = new Mensaje(0, $nombre, $email, $texto);
    
    $dao = new MensajeDAO($conexion);
    
    $dao->insertar($mensaje);

    No es necesario comprender todavía todo el proyecto. En esta fase debes poder explicar qué responsabilidad tiene cada archivo.

    Evidencia: incluye una captura del proyecto abierto en el editor y una explicación breve de este recorrido.


    Bloque B. Implantación local con XAMPP

    9. Preparar XAMPP

    Si todavía no tienes XAMPP, descárgalo desde su web oficial:

    Descargar XAMPP

    Las instrucciones siguientes utilizan una instalación de Windows situada en:

    C:\xampp

    Si tu instalación está en otra ubicación, adapta las rutas.

    Abre el panel de control de XAMPP e inicia:

    • Apache.
    • MySQL.

    Aunque el panel muestre el nombre MySQL, XAMPP puede incluir MariaDB como motor de base de datos.

    Comprueba estas direcciones:

    http://localhost
    http://localhost/phpmyadmin

    phpMyAdmin nos permitirá gestionar la base de datos de esta instalación. En la configuración básica de XAMPP se accede a él desde el propio equipo. apachefriends.org

    Evidencia: captura del panel con Apache y MySQL iniciados.

    10. Colocar el proyecto

    Crea esta carpeta:

    C:\proyectos

    Coloca dentro el proyecto descomprimido:

    C:\proyectos\loot-figures-clase

    Comprueba que existe:

    C:\proyectos\loot-figures-clase\public\index.php

    La carpeta del proyecto estará fuera de htdocs. Configuraremos Apache para que publique únicamente su carpeta public.

    Después, abre esta ubicación definitiva en VS Code o PhpStorm.

    11. Configurar Apache para la tienda

    11.1. Revisar la carga de VirtualHosts

    Abre este archivo:

    C:\xampp\apache\conf\httpd.conf

    Busca la línea:

    Include conf/extra/httpd-vhosts.conf

    Si aparece comentada con #, elimina ese carácter.

    Guarda el archivo.

    11.2. Añadir la configuración

    Abre:

    C:\xampp\apache\conf\extra\httpd-vhosts.conf

    Añade al final:

    Listen 8080
    
    <VirtualHost *:8080>
        ServerName localhost
    
        DocumentRoot "C:/proyectos/loot-figures-clase/public"
    
        <Directory "C:/proyectos/loot-figures-clase/public">
            Options -Indexes
            AllowOverride All
            Require local
        </Directory>
    </VirtualHost>

    Importante: si ya existe una instrucción Listen 8080 en la configuración de Apache, no la añadas otra vez.

    En la configuración de Apache hemos escrito las rutas con /.

    ¿Qué significa esta configuración?

    InstrucciónFunción
    Listen 8080Apache escucha también en el puerto 8080
    VirtualHost *:8080Define el sitio que responderá en ese puerto
    DocumentRootIndica la carpeta pública de la aplicación
    AllowOverride AllPermite aplicar las instrucciones de .htaccess
    Require localPermite el acceso desde el propio ordenador

    Detén y vuelve a iniciar Apache desde XAMPP.

    Si no arranca, revisa los mensajes y registros del servicio antes de continuar.

    12. Crear la base de datos

    Abre:

    http://localhost/phpmyadmin

    Selecciona la pestaña SQL y ejecuta:

    CREATE DATABASE loot_figures
    CHARACTER SET utf8mb4
    COLLATE utf8mb4_unicode_ci;
    
    CREATE USER 'loot_app'@'localhost'
    IDENTIFIED BY 'CambiaEstaClaveBD!';
    
    GRANT SELECT, INSERT, UPDATE, DELETE
    ON loot_figures.*
    TO 'loot_app'@'localhost';

    Hemos creado:

    • La base de datos loot_figures.
    • El usuario loot_app.
    • Los permisos necesarios para las operaciones de la tienda.

    La aplicación utilizará este usuario, no la cuenta root.

    Si la base o el usuario ya existen por un intento anterior, revisa lo que has creado antes de repetir las instrucciones. No elimines bases de datos para resolver un error sin comprobar su contenido.

    13. Importar las tablas

    En phpMyAdmin:

    1. Selecciona la base de datos loot_figures.
    2. Abre la pestaña Importar.
    3. Selecciona el archivo:
    C:\proyectos\loot-figures-clase\database\schema.sql
    1. Ejecuta la importación.
    2. Comprueba que aparecen estas tablas:
    users
    products
    orders
    order_items
    messages
    login_attempts

    La importación debe realizarse con la cuenta de administración de la base de datos, porque crea las tablas.

    No vuelvas a importar el esquema sobre una instalación que ya tiene sus tablas.

    Evidencia: captura de la base de datos con las tablas creadas.

    14. Crear el archivo de configuración

    Dentro de config, copia:

    config.example.php

    y llama a la copia:

    config.php

    Puedes hacerlo desde el editor o el explorador de archivos.

    Edita config.php y utiliza estos valores:

    <?php
    
    return [
        'db' => [
            'host' => 'localhost',
            'port' => 3306,
            'name' => 'loot_figures',
            'user' => 'loot_app',
            'password' => 'CambiaEstaClaveBD!'
        ],
    
        'secure_cookie' => false,
        'debug' => false
    ];

    Si tu servicio de base de datos utiliza otro puerto, debes cambiar el valor port.

    En esta práctica trabajamos con HTTP local, por eso secure_cookie permanece en false.

    No copies config.docker.php: esa configuración corresponde a otro entorno.

    15. Comprobar PHP y cargar los datos de ejemplo

    Abre una terminal de PowerShell.

    Comprueba el PHP de XAMPP:

    & "C:\xampp\php\php.exe" -v

    Después, sitúate en el proyecto:

    Set-Location "C:\proyectos\loot-figures-clase"

    Ejecuta:

    & "C:\xampp\php\php.exe" scripts/seed.php

    El script creará los usuarios y productos de demostración.

    Si aparece un error, comprueba:

    • Que MySQL está iniciado.
    • Que existe config/config.php.
    • Que la contraseña y el puerto son correctos.
    • Que has importado las tablas.

    El archivo seed.php se ejecuta desde la terminal. No tienes que abrirlo mediante una URL.

    16. Abrir la tienda en localhost

    Abre:

    http://localhost:8080

    La tienda debería mostrar la home, el logo, las imágenes y los productos.

    No abras index.php haciendo doble clic. Tampoco utilices Live Server para ejecutar esta aplicación PHP. Debes acceder mediante Apache.

    Cuentas de demostración

    RolCorreoContraseña
    Administradoradmin@loot.localAdminDemo!2026
    Clientecliente@loot.localClienteDemo!2026

    Estas cuentas utilizan direcciones ficticias. No necesitas disponer de esos correos.

    17. Comprobar el funcionamiento local

    Realiza estas pruebas:

    Zona pública

    1. Abre la home.
    2. Accede al catálogo.
    3. Busca una figura.
    4. Filtra por rareza.
    5. Cambia el orden de los productos.
    6. Abre el detalle de una figura.

    Registro y cuenta

    1. Crea una cuenta con datos ficticios.
    2. Cierra sesión.
    3. Vuelve a entrar.
    4. Accede a tu perfil.
    5. Cambia el teléfono y comprueba que se guarda.

    Carrito y compra

    1. Entra como cliente.
    2. Añade una figura al carrito.
    3. Cambia la cantidad.
    4. Añade otra figura.
    5. Elimina una línea.
    6. Introduce una dirección ficticia.
    7. Confirma el pedido.
    8. Comprueba que aparece en el historial.

    La compra es una simulación y no realiza ningún cobro.

    Administración

    1. Entra como administrador.
    2. Accede al listado de productos.
    3. Modifica el nombre, precio o stock de una figura.
    4. Comprueba el resultado en el catálogo.
    5. Crea un usuario de prueba.
    6. Modifica sus datos.
    7. Cambia su contraseña.
    8. Comprueba que puede iniciar sesión con la nueva contraseña.
    9. Sube una fotografía a un producto.

    Contacto

    1. Envía un mensaje desde la página de contacto.
    2. Entra como administrador.
    3. Comprueba que el mensaje aparece en el panel.

    El mensaje se guarda en la base de datos. No se envía un correo electrónico.

    18. Observar una petición JSON

    Abre las herramientas de desarrollo del navegador y selecciona la pestaña Red / Network.

    Recarga el catálogo y localiza la petición a:

    api/listar_productos.php

    Examina su respuesta.

    Responde:

    1. ¿Qué información contiene el JSON?
    2. ¿Qué campos identifican el nombre y el precio del producto?
    3. ¿El navegador recibe el código fuente PHP?
    4. ¿Qué archivo JavaScript utiliza esos datos para construir las tarjetas?

    Después, visita:

    http://localhost:8080/ejemplo_clase.php

    Este formulario permite observar un envío clásico por POST.

    Utiliza otra cuenta ficticia para probarlo. Después del envío verás la respuesta JSON directamente en el navegador.

    Explica la diferencia entre este formulario y el registro habitual de la tienda.


    Bloque C. Implantación en Ubuntu Server

    19. Preparar la máquina virtual

    Utiliza la máquina virtual creada en clase.

    Antes de comenzar:

    1. Comprueba que puedes iniciar sesión.
    2. Identifica tu usuario.
    3. Comprueba que puedes ejecutar sudo.
    4. Anota la versión de Ubuntu.
    5. Comprueba la dirección IP.
    6. Realiza una instantánea si el programa de virtualización lo permite.

    Ejecuta:

    whoami
    cat /etc/os-release
    ip -br a

    También puedes consultar:

    hostname -I

    En los siguientes ejemplos utilizaremos:

    192.168.1.50

    Es una IP de ejemplo. Debes sustituirla por la dirección real de tu servidor.

    20. Comprobar la comunicación con la máquina virtual

    Desde tu ordenador, intenta acceder por SSH si ya lo configuraste en clase:

    ssh alumno@192.168.1.50

    Sustituye alumno por tu usuario real.

    Si la máquina utiliza NAT

    Puede ser necesario configurar una redirección de puertos en el programa de virtualización.

    Por ejemplo:

    Puerto del ordenadorPuerto de UbuntuUso
    222222SSH
    80818080Tienda

    Con esa configuración, SSH se utilizaría así:

    ssh -p 2222 alumno@127.0.0.1

    Y la tienda de Ubuntu se abriría desde el ordenador mediante:

    http://localhost:8081

    Si utilizas una red en la que el ordenador puede acceder directamente a la IP de Ubuntu, no necesitas esas redirecciones.

    Documenta el modo de red que estás utilizando.

    21. Instalar los servicios necesarios

    En Ubuntu Server ejecuta:

    sudo apt update

    Después:

    sudo apt install apache2 mysql-server php libapache2-mod-php php-mysql php-cli unzip

    Apache atenderá las peticiones web; PHP ejecutará el código del servidor; MySQL almacenará los datos. La documentación de Ubuntu recoge la instalación de Apache y de PHP con su módulo para Apache. Ubuntu Server documentation

    Si algunos paquetes ya estaban instalados, revisa el resultado del comando: no es necesario reinstalarlos manualmente.

    Activa los servicios:

    sudo systemctl enable --now apache2
    sudo systemctl enable --now mysql

    Comprueba su estado:

    systemctl status apache2 --no-pager
    systemctl status mysql --no-pager

    Ambos deben aparecer activos.

    Evidencia: captura de los servicios funcionando.

    22. Comprobar la versión y las extensiones de PHP

    Ejecuta:

    php -v

    Después:

    php -m

    Comprueba que aparecen:

    mysqli
    mysqlnd
    fileinfo
    session

    Anota la versión de PHP de Ubuntu y compárala con la de XAMPP.

    23. Transferir el proyecto al servidor

    Para esta instalación, utiliza el ZIP original entregado por el profesor. Crearemos una base de datos nueva en Ubuntu.

    Puedes transferir el archivo mediante SFTP o con scp.

    Ejemplo, ejecutado desde tu ordenador y desde la carpeta donde está el ZIP:

    scp loot-figures-php-clase.zip alumno@192.168.1.50:~/

    Si utilizas la redirección SSH del ejemplo anterior:

    scp -P 2222 loot-figures-php-clase.zip alumno@127.0.0.1:~/

    Observa que scp utiliza -P mayúscula para indicar el puerto.

    En Ubuntu comprueba que ha llegado:

    ls -lh ~/loot-figures-php-clase.zip

    Descomprime:

    cd ~
    unzip loot-figures-php-clase.zip

    Comprueba:

    ls ~/loot-figures-clase

    Mueve el proyecto:

    sudo mv ~/loot-figures-clase /var/www/

    La ubicación final será:

    /var/www/loot-figures-clase

    Si ya existe una carpeta con ese nombre por un intento anterior, revisa su contenido antes de repetir el movimiento.

    24. Configurar Apache en Ubuntu

    24.1. Añadir el puerto

    Abre:

    sudo nano /etc/apache2/ports.conf

    Añade:

    Listen 8080

    Conserva las instrucciones existentes y no dupliques Listen 8080 si ya aparece.

    24.2. Crear el sitio

    Ejecuta:

    sudo nano /etc/apache2/sites-available/loot-figures.conf

    Introduce:

    <VirtualHost *:8080>
        DocumentRoot /var/www/loot-figures-clase/public
    
        <Directory /var/www/loot-figures-clase/public>
            Options -Indexes
            AllowOverride All
            Require all granted
        </Directory>
    
        ErrorLog ${APACHE_LOG_DIR}/loot-figures-error.log
        CustomLog ${APACHE_LOG_DIR}/loot-figures-access.log combined
    </VirtualHost>

    Guarda el archivo.

    Activa el sitio:

    sudo a2ensite loot-figures.conf

    Comprueba la sintaxis:

    sudo apache2ctl configtest

    Si aparece:

    Syntax OK

    reinicia Apache:

    sudo systemctl restart apache2

    No desactives los sitios anteriores de clase: esta tienda utiliza otro puerto.

    25. Crear la base de datos en Ubuntu

    Accede a MySQL:

    sudo mysql

    La instalación de MySQL mediante los paquetes de Ubuntu permite administrar el servicio y crear cuentas para las aplicaciones. Ubuntu Server documentation

    Ejecuta:

    CREATE DATABASE loot_figures
    CHARACTER SET utf8mb4
    COLLATE utf8mb4_unicode_ci;
    
    CREATE USER 'loot_app'@'localhost'
    IDENTIFIED BY 'CambiaEstaClaveBD!';
    
    GRANT SELECT, INSERT, UPDATE, DELETE
    ON loot_figures.*
    TO 'loot_app'@'localhost';

    Sal:

    EXIT;

    Importa las tablas:

    sudo mysql loot_figures < /var/www/loot-figures-clase/database/schema.sql

    Comprueba el resultado:

    sudo mysql -e "SHOW TABLES FROM loot_figures;"

    Debes encontrar las mismas tablas que en XAMPP.

    26. Configurar la conexión de la aplicación

    Copia la plantilla:

    sudo cp /var/www/loot-figures-clase/config/config.example.php /var/www/loot-figures-clase/config/config.php

    Edita:

    sudo nano /var/www/loot-figures-clase/config/config.php

    Utiliza:

    <?php
    
    return [
        'db' => [
            'host' => 'localhost',
            'port' => 3306,
            'name' => 'loot_figures',
            'user' => 'loot_app',
            'password' => 'CambiaEstaClaveBD!'
        ],
    
        'secure_cookie' => false,
        'debug' => false
    ];

    La base de datos está dentro de la propia máquina Ubuntu, por eso la aplicación utiliza localhost como servidor de base de datos.

    No debes poner la IP del ordenador Windows en esta configuración.

    27. Preparar propietarios y permisos

    Apache necesita leer los archivos del proyecto. Además, debe poder escribir en la carpeta donde se guardan las imágenes subidas.

    Configura el propietario y el grupo:

    sudo chown -R root:www-data /var/www/loot-figures-clase

    Configura los directorios:

    sudo find /var/www/loot-figures-clase -type d -exec chmod 750 {} \;

    Configura los archivos:

    sudo find /var/www/loot-figures-clase -type f -exec chmod 640 {} \;

    Permite que Apache gestione las imágenes subidas:

    sudo chown -R www-data:www-data /var/www/loot-figures-clase/public/uploads

    Comprueba:

    ls -ld /var/www/loot-figures-clase/public/uploads
    ls -l /var/www/loot-figures-clase/config/config.php

    Preguntas

    1. ¿Qué representa el usuario www-data?
    2. ¿Por qué Apache necesita permiso de escritura en uploads?
    3. ¿Por qué no necesita escribir en todos los archivos PHP?
    4. ¿Qué diferencia hay entre los permisos de un archivo y los de un directorio?

    No utilices chmod 777 para resolver problemas de permisos. Debes identificar qué usuario necesita acceso y qué operación debe realizar.

    28. Cargar los datos de ejemplo

    Ejecuta el script utilizando el usuario que puede leer los archivos del proyecto:

    sudo -u www-data php /var/www/loot-figures-clase/scripts/seed.php

    Comprueba los productos:

    sudo mysql -e "SELECT id, name, stock FROM loot_figures.products;"

    Comprueba los usuarios sin mostrar los hashes de contraseña:

    sudo mysql -e "SELECT id, name, email, role FROM loot_figures.users;"

    Evidencia: captura de los datos creados.

    29. Comprobar el acceso web

    Desde tu ordenador abre:

    http://192.168.1.50:8080

    Sustituye la IP por la del servidor.

    Si utilizas la redirección NAT propuesta, abre:

    http://localhost:8081

    Si no puedes acceder

    Comprueba el estado de Apache:

    systemctl status apache2 --no-pager

    Comprueba los puertos:

    sudo ss -lntp

    Revisa el cortafuegos:

    sudo ufw status

    Si UFW está activo, permite el puerto de la tienda:

    sudo ufw allow 8080/tcp

    No es necesario activar ni desactivar el cortafuegos para realizar esta comprobación.

    Consulta el registro de errores del sitio:

    sudo tail -n 50 /var/log/apache2/loot-figures-error.log

    Importante: escribir localhost en el navegador de tu ordenador apunta a tu ordenador. No apunta a Ubuntu, salvo que hayas configurado una redirección de puertos.

    30. Repetir las pruebas funcionales

    Realiza en Ubuntu las mismas pruebas que hiciste en XAMPP:

    • Navegación pública.
    • Catálogo y filtros.
    • Registro.
    • Login y cierre de sesión.
    • Edición del perfil.
    • Carrito y pedido.
    • Historial.
    • Administración de productos.
    • Administración de clientes.
    • Cambio de contraseña.
    • Subida de una imagen.
    • Envío y consulta de un mensaje.

    Comprueba especialmente la subida de imágenes: permite verificar que los permisos de uploads están preparados correctamente.

    31. Comprobar qué está publicando Apache

    Intenta abrir:

    http://IP_DEL_SERVIDOR:8080/config/config.php
    http://IP_DEL_SERVIDOR:8080/database/schema.sql
    http://IP_DEL_SERVIDOR:8080/scripts/seed.php

    Estas direcciones no deben permitir acceder a esos archivos, porque están fuera de la carpeta pública.

    En cambio, debe funcionar:

    http://IP_DEL_SERVIDOR:8080/api/listar_productos.php

    Esta dirección devolverá los productos en JSON.

    Explica por qué unas rutas son accesibles y otras no.


    Bloque D. Comparación, documentación y entrega

    32. Comparar las dos instalaciones

    Completa esta tabla con los datos reales de tu trabajo:

    AspectoXAMPPUbuntu Server
    Sistema operativo
    Versión de PHP
    Motor y versión de base de datos
    Ubicación del proyecto
    Carpeta pública
    Archivo de configuración del sitio Apache
    Dirección de acceso
    Puerto web
    Usuario de la base de datos
    Gestión de permisos de uploads
    Ubicación de los registros de errores

    Responde también:

    1. ¿Qué pasos son iguales en los dos entornos?
    2. ¿Qué pasos cambian?
    3. ¿Qué tareas facilita XAMPP?
    4. ¿Qué servicios has tenido que preparar en Ubuntu?
    5. ¿Por qué el editor no sustituye al servidor web?
    6. ¿Dónde se ejecuta PHP?
    7. ¿Dónde se ejecuta JavaScript?
    8. ¿Por qué necesitas copiar archivos y preparar también la base de datos?

    33. Registrar las pruebas

    Incluye una tabla de comprobación para cada instalación:

    PruebaResultado esperadoResultado obtenidoEvidencia
    Abrir la homeSe muestran diseño e imágenes
    Consultar catálogoSe muestran los productos
    Registrar clienteSe crea la cuenta
    Iniciar sesiónSe accede a la cuenta
    Crear pedidoSe guarda y aparece en el historial
    Editar productoEl cambio aparece en el catálogo
    Cambiar contraseñaFunciona la nueva contraseña
    Subir imagenSe guarda y se muestra
    Enviar contactoEl administrador puede leerlo

    No marques una prueba como correcta sin realizarla.

    34. Documentar incidencias

    Si encuentras un problema, registra:

    • Qué estabas intentando hacer.
    • El mensaje de error.
    • Qué comprobaste.
    • La causa que identificaste.
    • La solución aplicada.
    • Cómo verificaste que funcionaba.

    Si no encuentras incidencias, indica las comprobaciones preventivas que has realizado: configuración, servicios, puertos, permisos y conexión a la base de datos.

    35. Documentación que debes entregar

    Prepara un README.md con estas secciones:

    1. Título, autor y objetivo.
    2. Descripción de la aplicación.
    3. Requisitos.
    4. Estructura del proyecto.
    5. Instalación en XAMPP.
    6. Instalación en Ubuntu Server.
    7. Configuración de Apache y base de datos.
    8. Pruebas funcionales.
    9. Incidencias y soluciones.
    10. Comparación de los entornos.
    11. Conclusiones personales.

    Guarda las capturas en una carpeta:

    capturas

    Puedes insertarlas así:

    ![Panel de XAMPP con los servicios iniciados](capturas/xampp-servicios.png)

    Los comandos deben aparecer en bloques de código:

    ```bash
    sudo systemctl status apache2 --no-pager
    ```

    La documentación debe explicar tu instalación real, con tus rutas, tu IP, tus versiones y tus resultados.

    No entregues únicamente una copia de este enunciado.

    36. Entrega final

    Entrega un ZIP con:

    • README.md.
    • La carpeta capturas.
    • Los fragmentos de configuración necesarios para comprender tu instalación, con las contraseñas sustituidas por un marcador.

    Por ejemplo:

    'password' => 'CONTRASEÑA_OCULTA'

    No es necesario incluir los discos de la máquina virtual ni una copia completa de XAMPP.

    Conserva las dos instalaciones funcionando para poder demostrarlas en clase.

    37. Comprobación final antes de entregar

    • La aplicación funciona en XAMPP.
    • La aplicación funciona en Ubuntu Server.
    • Has comprobado las funciones de cliente y administrador.
    • La subida de imágenes funciona en ambos entornos.
    • Apache sirve únicamente la carpeta public.
    • Has identificado los modelos, DAO y archivos de operaciones.
    • Has observado una respuesta JSON.
    • La documentación contiene pasos, comandos y evidencias.
    • Las capturas se visualizan correctamente en el README.
    • Puedes explicar qué has configurado y por qué.

    La actividad se considerará completada cuando puedas mostrar las dos instalaciones y explicar el recorrido de una petición desde el navegador hasta la base de datos.
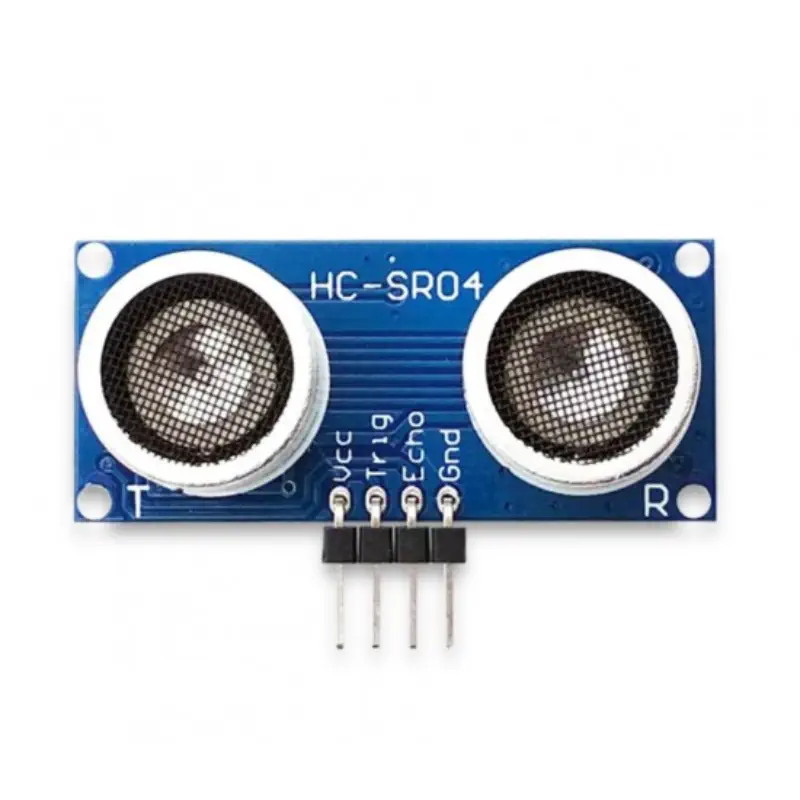
  • Proyecto Arduino: del sensor al coche robot Parte 1

    Proyecto Arduino: del sensor al coche robot Parte 1

    Presentación del proyecto

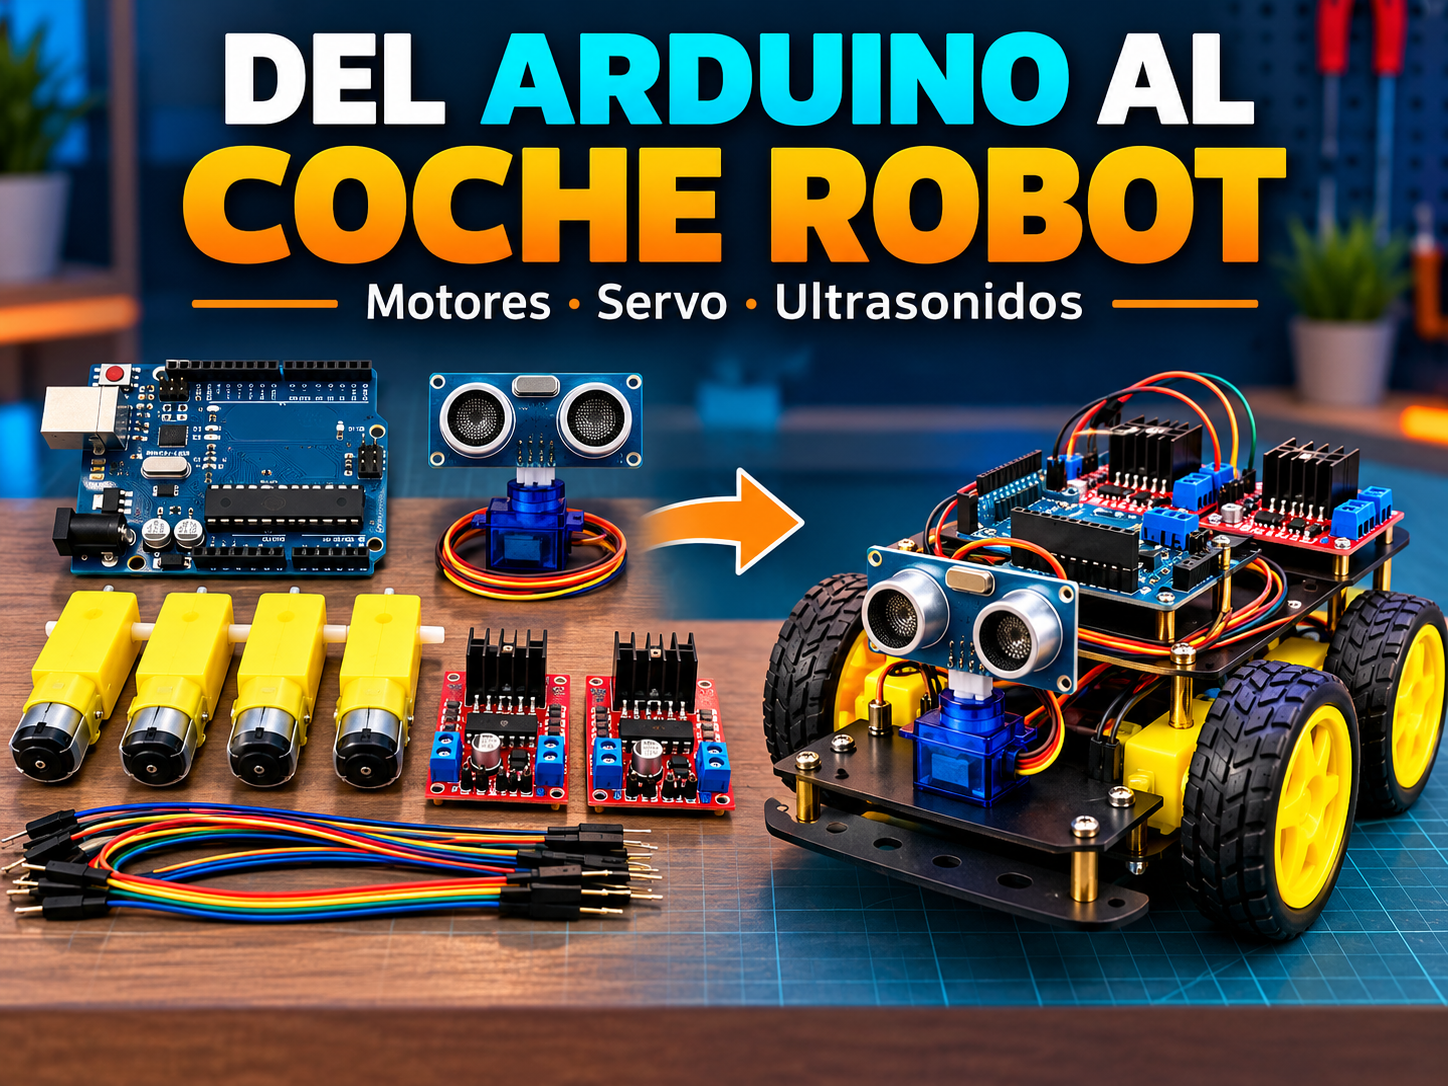
    En este proyecto aprenderás a utilizar los componentes que más adelante formarán parte de un coche robot de cuatro motores.

    Antes de construir el coche completo, trabajaremos por etapas para comprender qué hace cada componente, cómo se conecta y cómo se controla desde un programa.

    El proyecto se divide en dos partes:

    ParteQué vamos a trabajarResultado
    Parte 1. Medir y observar el entornoSensor de ultrasonidos, servomotor y combinación de ambosUn escáner que mide distancias en distintas direcciones
    Parte 2. Controlar el movimientoMotores DC, controlador L293D y combinación con el sensorUn montaje de banco que detiene los motores ante un obstáculo

    En la primera parte no conectaremos motores DC ni el controlador L293D. El servomotor se utilizará para orientar el sensor.

    El coche completo será una fase posterior. En estas dos partes nos centraremos en comprender y comprobar sus componentes.

    Objetivos generales

    Al finalizar el proyecto deberás ser capaz de:

    • Identificar los cables y conexiones de cada componente.
    • Distinguir entre un sensor y un actuador.
    • Medir distancias con un HC-SR04.
    • Colocar un servo en diferentes posiciones.
    • Combinar el servo y el sensor para observar distintas direcciones.
    • Controlar el sentido y la velocidad de motores DC mediante un L293D.
    • Utilizar una lectura del sensor para tomar una decisión.
    • Documentar los montajes y explicar los resultados.

    Forma de trabajo

    En cada práctica seguirás este proceso:

    1. Comprender: lee qué hace el componente y para qué sirve.
    2. Predecir: escribe qué esperas que ocurra.
    3. Montar: realiza las conexiones con la alimentación desconectada.
    4. Programar: introduce el código y súbelo al Arduino.
    5. Comprobar: observa el resultado y registra las pruebas.
    6. Modificar: cambia una parte del programa y explica su efecto.

    No basta con conseguir que el montaje funcione. Debes poder explicar por qué funciona.


    Parte 1. Medir y observar el entorno

    Material necesario

    • Arduino Uno R3 y cable USB.
    • Sensor de ultrasonidos HC-SR04.
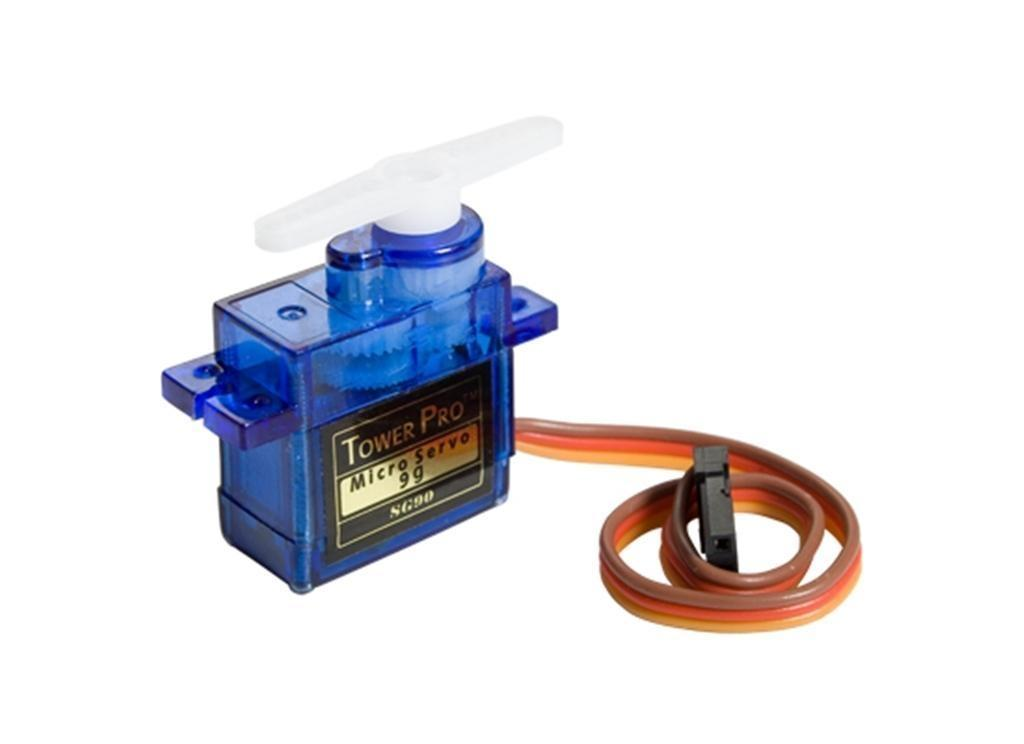
    • Servomotor de posición SG90 o similar.
    • Fuente regulada de 5 V adecuada para el servo.
    • Cables y protoboard.
    • Regla o cinta métrica.
    • Una caja o superficie plana para realizar las mediciones.
    • Un soporte ligero para colocar el sensor sobre el servo.

    Preparación del entorno

    Antes de comenzar:

    1. Abre Arduino IDE.
    2. Selecciona la placa Arduino Uno.
    3. Selecciona el puerto al que está conectado el Arduino.
    4. Crea un programa diferente para cada práctica.
    5. Guarda los programas con estos nombres:
    01_ultrasonidos
    02_servo
    03_escaner

    Mapa de conexiones de esta parte

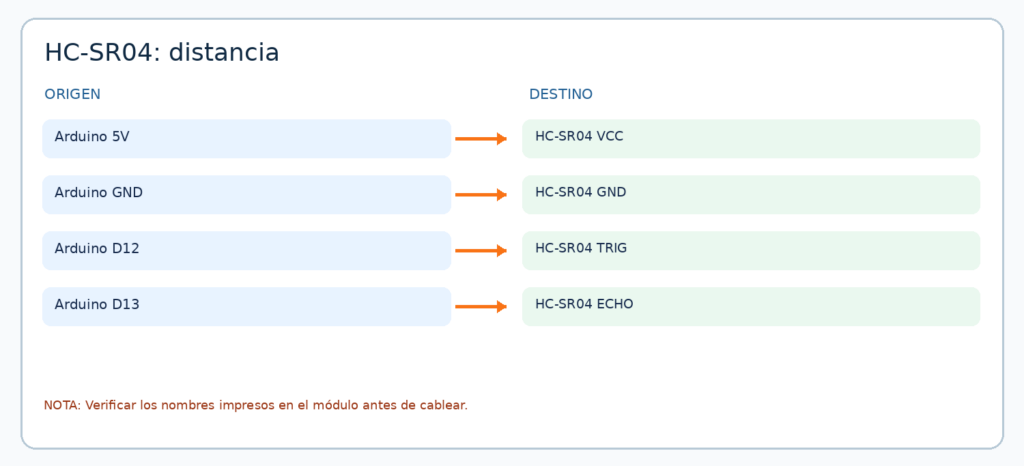
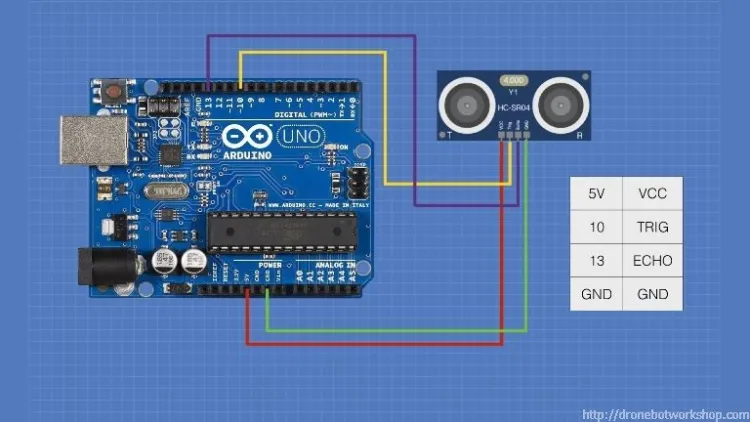
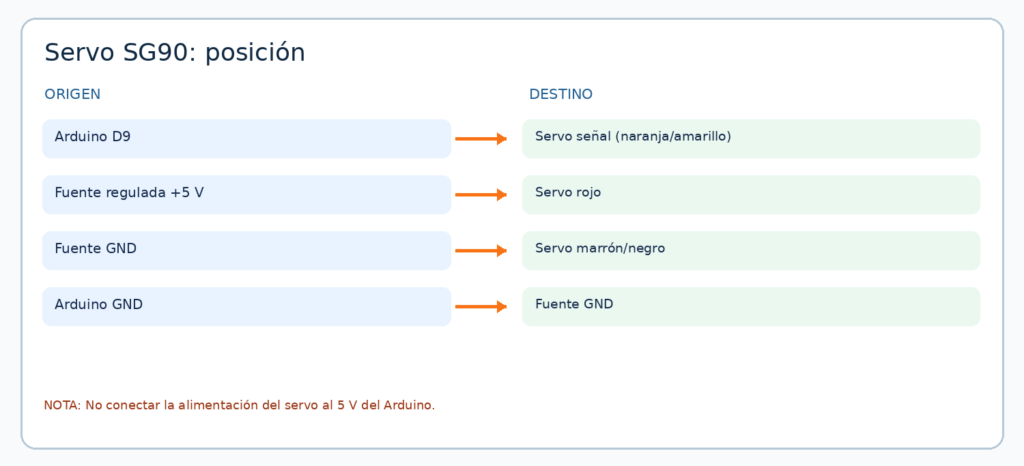
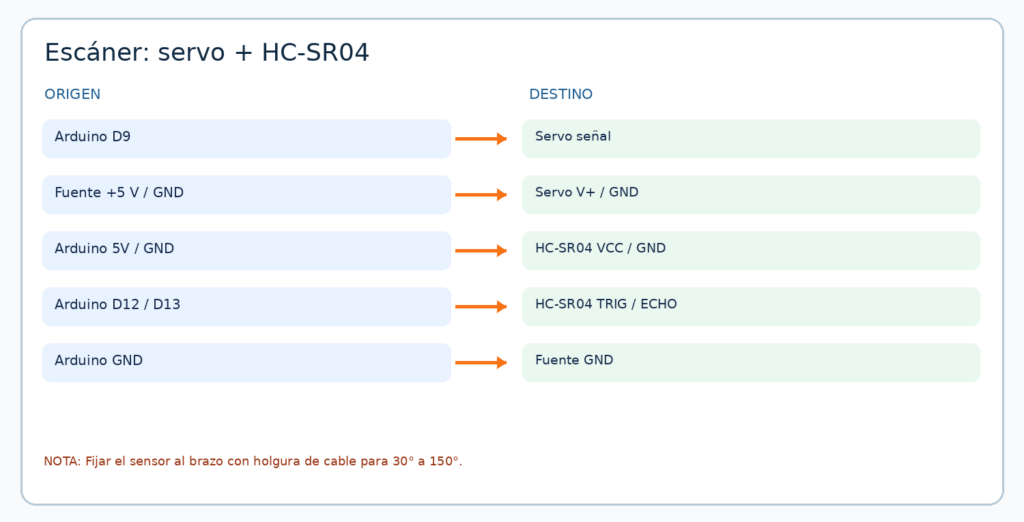
    ComponenteConexión al Arduino
    HC-SR04: VCC5V
    HC-SR04: GNDGND
    HC-SR04: TRIGD12
    HC-SR04: ECHOD13
    Señal del servoD9
    Alimentación del servoFuente externa regulada de 5 V
    GND de la fuente del servoUnido al GND del Arduino

    Práctica 1. Medir distancias con ultrasonidos

    Qué vamos a aprender

    El HC-SR04 permite medir la distancia hasta un objeto.

    Para hacerlo:

    1. El Arduino envía una orden por el pin TRIG.
    2. El sensor emite una señal ultrasónica.
    3. La señal rebota en el objeto.
    4. El sensor comunica por ECHO el tiempo asociado al recorrido.

    Como el sonido viaja hasta el objeto y vuelve, debemos dividir el recorrido entre dos.

    Conexiones

    Pin del HC-SR04Arduino Uno
    VCC5V
    GNDGND
    TRIGD12
    ECHOD13

    Comprueba los nombres impresos en el sensor antes de conectar los cables.

    Montaje paso a paso

    1. Desconecta el cable USB del Arduino.
    2. Conecta VCC a 5V.
    3. Conecta GND a GND.
    4. Conecta TRIG a D12.
    5. Conecta ECHO a D13.
    6. Coloca el sensor de forma que sus dos cápsulas apunten hacia la zona que quieres medir.
    7. Revisa las conexiones antes de conectar el USB.

    Programa

    const byte TRIG = 12;
    const byte ECHO = 13;
    
    float medirCm() {
      // Preparar el disparo.
      digitalWrite(TRIG, LOW);
      delayMicroseconds(2);
    
      // Enviar el pulso de disparo.
      digitalWrite(TRIG, HIGH);
      delayMicroseconds(10);
      digitalWrite(TRIG, LOW);
    
      // Esperar el eco, con un límite de tiempo.
      unsigned long tiempo = pulseIn(ECHO, HIGH, 30000UL);
    
      // Un resultado de cero significa que no llegó el eco.
      if (tiempo == 0) {
        return -1.0;
      }
    
      // Convertir el tiempo en distancia.
      return tiempo * 0.0343 / 2.0;
    }
    
    void setup() {
      pinMode(TRIG, OUTPUT);
      pinMode(ECHO, INPUT);
    
      Serial.begin(9600);
    }
    
    void loop() {
      float distancia = medirCm();
    
      if (distancia < 0) {
        Serial.println("Sin eco");
      } else {
        Serial.print("Distancia: ");
        Serial.print(distancia, 1);
        Serial.println(" cm");
      }
    
      delay(100);
    }

    Cómo comprobarlo

    1. Sube el programa.
    2. Abre el Monitor serie a 9600 baudios.
    3. Coloca una caja plana aproximadamente a 10 cm.
    4. Mide la distancia real con una regla.
    5. Repite a 20 y 40 cm.
    6. Inclina la caja y observa si cambia la lectura.
    7. Retira el objeto y observa qué sucede.

    Tabla de resultados

    Distancia medida con reglaLectura del sensorDiferencia
    10 cm
    20 cm
    40 cm

    Resultado esperado

    La distancia mostrada cambia al mover el objeto.

    Cuando no se recibe el eco dentro del tiempo de espera, aparece «Sin eco». Esto no significa que el objeto esté a cero centímetros.

    Modificación obligatoria

    Modifica el programa para que, además de la distancia, muestre:

    • «Objeto cercano» cuando la distancia sea de 20 cm o menos.
    • «Objeto alejado» cuando supere los 20 cm.
    • «Sin eco» cuando no exista una lectura.

    Preguntas

    1. ¿Qué función tiene TRIG?
    2. ¿Qué función tiene ECHO?
    3. ¿Por qué dividimos entre dos?
    4. ¿Por qué una superficie inclinada puede afectar a la lectura?
    5. ¿Por qué no debemos interpretar «Sin eco» como cero centímetros?

    Práctica 2. Controlar la posición de un servo

    Qué vamos a aprender

    Un servo de posición permite mover su eje hasta un ángulo determinado.

    Lo utilizaremos para orientar el sensor de ultrasonidos hacia diferentes direcciones.

    Este servo recibe una orden de posición. Su funcionamiento es distinto al de los motores DC que harán girar las ruedas.

    Conexiones

    Cable del servoConexión
    Señal, normalmente naranja o amarilloD9 del Arduino
    RojoPositivo de la fuente regulada de 5 V
    Marrón o negroGND de la fuente
    GND de la fuenteGND del Arduino

    Comprueba los colores y las características de tu modelo.

    La masa de la fuente y la del Arduino deben estar unidas.

    Montaje paso a paso

    1. Desconecta todas las alimentaciones.
    2. Conecta la señal del servo a D9.
    3. Conecta los cables de alimentación del servo a su fuente.
    4. Une el GND de la fuente con el GND del Arduino.
    5. Coloca el servo sobre una superficie estable.
    6. Revisa las conexiones.
    7. Conecta el Arduino y sube el programa.

    Programa

    #include <Servo.h>
    
    Servo giro;
    const byte PIN_SERVO = 9;
    
    void setup() {
      giro.attach(PIN_SERVO);
    
      // Comenzar en la posición central.
      giro.write(90);
      delay(1000);
    }
    
    void loop() {
      giro.write(30);
      delay(1000);
    
      giro.write(90);
      delay(1000);
    
      giro.write(150);
      delay(1000);
    }

    Cómo comprobarlo

    1. Observa el movimiento entre las tres posiciones.
    2. Comprueba que el brazo no choque con ningún objeto.
    3. No fuerces el eje con la mano.
    4. Cambia las posiciones a 45°, 90° y 135°.
    5. Cambia los tiempos de espera y observa la diferencia.

    Tabla de resultados

    Ángulo solicitadoPosición observadaObservaciones
    30°
    90°
    150°

    Resultado esperado

    El servo se coloca sucesivamente en las posiciones indicadas.

    Los ángulos del programa son órdenes de posición; la posición física exacta depende del servo y de cómo se haya colocado su brazo.

    Modificación obligatoria

    Crea una secuencia que:

    1. Comience a 90°.
    2. Se mueva a 45°.
    3. Regrese a 90°.
    4. Se mueva a 135°.
    5. Regrese a 90°.

    Espera un segundo entre posiciones.

    Preguntas

    1. ¿Para qué sirve el cable de señal?
    2. ¿Qué hace attach()?
    3. ¿Qué hace write()?
    4. ¿Por qué unimos las masas?
    5. ¿Qué diferencia existe entre un servo de posición y un motor DC de una rueda?

    Práctica 3. Construir un escáner de distancias

    Qué vamos a aprender

    Combinaremos los dos montajes anteriores.

    El servo orientará el HC-SR04 hacia distintas posiciones y el Arduino realizará una medición en cada una.

    El resultado será un pequeño escáner del entorno.

    Conexiones

    Mantén las conexiones de las prácticas anteriores:

    ElementoConexión
    HC-SR04 VCC5V del Arduino
    HC-SR04 GNDGND del Arduino
    HC-SR04 TRIGD12
    HC-SR04 ECHOD13
    Señal del servoD9
    Alimentación del servoFuente externa regulada de 5 V
    GND de la fuenteGND del Arduino

    Montaje paso a paso

    1. Lleva el servo a 90° con un programa de prueba.
    2. Desconecta las alimentaciones.
    3. Fija el sensor sobre el brazo del servo mediante un soporte ligero.
    4. Deja holgura en los cables del sensor.
    5. Comprueba que puede moverse entre 30° y 150° sin tirar de los cables.
    6. Combina las conexiones.
    7. Sube el programa.

    Programa

    #include <Servo.h>
    
    Servo giro;
    
    const byte PIN_SERVO = 9;
    const byte TRIG = 12;
    const byte ECHO = 13;
    
    float medirCm() {
      digitalWrite(TRIG, LOW);
      delayMicroseconds(2);
    
      digitalWrite(TRIG, HIGH);
      delayMicroseconds(10);
      digitalWrite(TRIG, LOW);
    
      unsigned long tiempo = pulseIn(ECHO, HIGH, 30000UL);
    
      if (tiempo == 0) {
        return -1.0;
      }
    
      return tiempo * 0.0343 / 2.0;
    }
    
    void setup() {
      pinMode(TRIG, OUTPUT);
      pinMode(ECHO, INPUT);
    
      Serial.begin(9600);
    
      giro.attach(PIN_SERVO);
      giro.write(90);
      delay(600);
    }
    
    void loop() {
      const byte angulos[] = {30, 90, 150, 90};
    
      for (byte i = 0; i < 4; i++) {
        giro.write(angulos[i]);
    
        // Esperar a que termine el movimiento antes de medir.
        delay(500);
    
        float distancia = medirCm();
    
        Serial.print("Angulo: ");
        Serial.print(angulos[i]);
        Serial.print(" grados | ");
    
        if (distancia < 0) {
          Serial.println("Sin eco");
        } else {
          Serial.print(distancia, 1);
          Serial.println(" cm");
        }
    
        delay(100);
      }
    }

    Cómo comprobarlo

    1. Abre el Monitor serie a 9600 baudios.
    2. Coloca objetos en distintas direcciones.
    3. Observa la distancia asociada a cada ángulo.
    4. Anota qué ángulo corresponde físicamente a izquierda, centro y derecha en tu montaje.
    5. Cambia la posición de los objetos y repite.

    Tabla de resultados

    ÁnguloDirección físicaDistanciaLectura válida
    30°
    90°
    150°

    Resultado esperado

    El sensor se orienta hacia varias posiciones y muestra una distancia asociada a cada una.

    Modificación obligatoria

    Modifica el programa para guardar las lecturas de las tres posiciones y mostrar cuál tiene mayor distancia entre las lecturas válidas.

    Si ninguna lectura es válida, debe mostrar:

    No se puede determinar la dirección más despejada.

    Preguntas

    1. ¿Por qué esperamos después de mover el servo?
    2. ¿Por qué debemos relacionar cada distancia con su ángulo?
    3. ¿Podemos considerar que una dirección sin eco está necesariamente libre?
    4. ¿Cómo podría utilizar esta información el futuro coche?

    Entrega de la parte 1

    Entrega una carpeta comprimida con:

    parte_1/
    ├── README.md
    ├── imagenes/
    ├── 01_ultrasonidos/
    ├── 02_servo/
    └── 03_escaner/

    En el README.md incluye:

    • Explicación de las tres prácticas.
    • Fotografías y conexiones.
    • Tablas de resultados.
    • Respuestas a las preguntas.
    • Modificaciones realizadas.
    • Una conclusión sobre cómo funciona el escáner.
  • Taller de PHP: completa el código

    Taller de PHP: completa el código

    Indicaciones para el alumnado

    Copia cada bloque en un archivo con el nombre indicado. La estructura HTML ya está preparada. Escribe PHP en los lugares marcados con TODO; no cambies los nombres de los campos del formulario. Usa $_POST para leer los datos y htmlspecialchars() al mostrarlos en HTML. Prueba también qué ocurre si envías campos vacíos. Puedes consultar la documentación y usar IA, pero debes poder explicar cada línea que añadas.

    Ejercicio 1 — Recibir y mostrar un nombre (01_saludo.php)

    Objetivo: detectar el envío, leer un campo y mostrar una respuesta segura. Al abrir la página por primera vez no debe aparecer un saludo; si se envía un nombre vacío debe aparecer un aviso.

    <?php
    $nombre = '';
    $mensaje = '';
    
    // TODO 1: Comprueba que la petición utiliza el método POST.
    // Dentro de esa condición, lee $_POST['nombre'].
    // Elimina los espacios al principio y al final con trim().
    // Si falta el campo, utiliza una cadena vacía como valor inicial.
    
    // TODO 2: Si $nombre está vacío, guarda en $mensaje:
    // "Escribe tu nombre". Si no, crea un saludo usando $nombre.
    // No introduzcas HTML escrito por el usuario sin escapar.
    ?>
    <!doctype html>
    <html lang="es">
    <head>
        <meta charset="UTF-8">
        <title>Ejercicio 1: saludo</title>
    </head>
    <body>
        <h1>Saludo</h1>
        <form method="post" action="">
            <label for="nombre">Nombre:</label>
            <input id="nombre" name="nombre" type="text">
            <button type="submit">Enviar</button>
        </form>
    
        <?php // TODO 3: Muestra $mensaje dentro de un párrafo SOLO si contiene texto.
              // Escapa el contenido al imprimirlo en HTML. ?>
    </body>
    </html>

    Pruebas: Ana → saludo; → aviso; <script>alert(1)</script> → se ve como texto, sin ejecutarse.

    Ejercicio 2 — Validar edad y conservar los datos (02_edad.php)

    Objetivo: recoger dos campos, mostrar errores y conservar el nombre y la edad cuando el formulario se envía. Edad válida: entero de 0 a 120. El formulario también debe funcionar al abrirse sin enviar datos.

    <?php
    $nombre = '';
    $edad = '';
    $errores = [];
    $resultado = '';
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee nombre y edad de $_POST con ?? ''.
        // Aplica trim() a ambas cadenas.
    
        // TODO 2: Si el nombre está vacío, añade un mensaje a $errores.
        // Valida la edad como entero entre 0 y 120.
        // Pista: filter_var($edad, FILTER_VALIDATE_INT,
        //     ['options' => ['min_range' => 0, 'max_range' => 120]])
        // puede devolver 0, que es una edad válida: compara con === false.
    
        // TODO 3: Solo si $errores está vacío, crea $resultado:
        // "NOMBRE tiene EDAD años" (con los valores enviados).
    }
    ?>
    <!doctype html>
    <html lang="es">
    <head><meta charset="UTF-8"><title>Ejercicio 2: edad</title></head>
    <body>
        <h1>Registro sencillo</h1>
        <form method="post" action="">
            <label>Nombre:
                <input name="nombre" value="<?= htmlspecialchars($nombre, ENT_QUOTES, 'UTF-8') ?>">
            </label>
            <label>Edad:
                <input name="edad" value="<?= htmlspecialchars($edad, ENT_QUOTES, 'UTF-8') ?>">
            </label>
            <button type="submit">Comprobar</button>
        </form>
    
        <?php // TODO 4: Recorre $errores y muestra cada uno en un <p>.
              // Muestra $resultado si no está vacío.
              // Escapa cualquier dato mostrado en HTML. ?>
    </body>
    </html>

    Pruebas: edad 0 válida; 17 válida; -1, 121, 3.5, abc y campo vacío → error.

    Ejercicio 3 — Elegir un curso (03_curso.php)

    Objetivo: trabajar con un <select>, una lista de opciones admitidas y un resumen. Evita aceptar un valor enviado manualmente que no figure entre los cursos.

    <?php
    $cursos = [
        'php' => 'PHP',
        'linux' => 'Linux',
        'redes' => 'Redes'
    ];
    $nombre = '';
    $curso = '';
    $mensaje = '';
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee y recorta nombre y curso desde $_POST.
        // Usa ?? '' para los campos que puedan faltar.
    
        // TODO 2: Comprueba que el nombre no está vacío y que la clave
        // $curso existe en $cursos (array_key_exists()).
        // Si algún dato falla, guarda un mensaje de error.
        // Si ambos son válidos, guarda un resumen con el nombre
        // del alumno y el nombre legible del curso.
    }
    ?>
    <!doctype html>
    <html lang="es">
    <head><meta charset="UTF-8"><title>Ejercicio 3: curso</title></head>
    <body>
        <h1>Inscripción</h1>
        <form method="post" action="">
            <label>Nombre:
                <input name="nombre" value="<?= htmlspecialchars($nombre, ENT_QUOTES, 'UTF-8') ?>">
            </label>
            <label>Curso:
                <select name="curso">
                    <option value="">Selecciona uno</option>
                    <?php foreach ($cursos as $codigo => $etiqueta): ?>
                        <option value="<?= htmlspecialchars($codigo, ENT_QUOTES, 'UTF-8') ?>"
                            <?= $curso === $codigo ? 'selected' : '' ?>>
                            <?= htmlspecialchars($etiqueta, ENT_QUOTES, 'UTF-8') ?>
                        </option>
                    <?php endforeach; ?>
                </select>
            </label>
            <button type="submit">Inscribirse</button>
        </form>
        <?php // TODO 3: Muestra $mensaje si contiene texto. Escápalo. ?>
    </body>
    </html>

    Pruebas: el curso elegido permanece seleccionado después de enviar; sin nombre o sin curso aparece error; un valor de curso inexistente se rechaza.

    Ejercicio 4 — Casillas y cálculo de total (04_pedido.php)

    Objetivo: leer varias casillas con el mismo nombre, validar los códigos recibidos y sumar los precios. Si no se marca ninguna casilla, el pedido se rechaza.

    <?php
    $productos = [
        'teclado' => ['nombre' => 'Teclado', 'precio' => 25],
        'raton' => ['nombre' => 'Ratón', 'precio' => 15],
        'alfombrilla' => ['nombre' => 'Alfombrilla', 'precio' => 10]
    ];
    $seleccion = [];
    $error = '';
    $total = null;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Obtén $_POST['productos'] ?? [].
        // Verifica que es un array; si no, guarda un error.
    
        // TODO 2: Si es un array, comprueba que se marcó al menos
        // un producto y que TODOS sus códigos existen en $productos.
        // Para validar cada código, puedes usar is_string() y
        // array_key_exists(). Si hay uno incorrecto, muestra error.
    
        // TODO 3: Solo si no hay errores, suma el precio de cada
        // producto elegido y guarda el resultado en $total.
        // Pista: comienza $total en 0 antes de sumar.
    }
    ?>
    <!doctype html>
    <html lang="es">
    <head><meta charset="UTF-8"><title>Ejercicio 4: pedido</title></head>
    <body>
        <h1>Pedido de material</h1>
        <form method="post" action="">
            <?php foreach ($productos as $codigo => $datos): ?>
                <label>
                    <input type="checkbox" name="productos[]"
                        value="<?= htmlspecialchars($codigo, ENT_QUOTES, 'UTF-8') ?>"
                        <?= in_array($codigo, $seleccion, true) ? 'checked' : '' ?>>
                    <?= htmlspecialchars($datos['nombre'], ENT_QUOTES, 'UTF-8') ?>:
                    <?= $datos['precio'] ?> €
                </label><br>
            <?php endforeach; ?>
            <button type="submit">Calcular</button>
        </form>
    
        <?php // TODO 4: Muestra $error si existe o, si el pedido
              // es válido, muestra "Total: ... €".
              // Recuerda que $total puede valer 0; usa !== null. ?>
    </body>
    </html>

    Pruebas: teclado + ratón → 40 €; todos → 50 €; ninguno → error. Prueba también qué ocurre si se envía manualmente un código de producto desconocido.

    Qué explicar en la entrega

    Para cada ejercicio, escribe dos o tres frases: qué datos recibe el servidor, qué validación aplicaste y qué comportamiento observaste en las pruebas. No entregues solo una captura del código.


    Ejercicio 5 — Buscar en una lista con GET (05_busqueda.php)

    Objetivo: entender los parámetros de la URL. Muestra solo las asignaturas cuyo nombre contiene el texto buscado, sin distinguir mayúsculas y minúsculas.

    <?php
    $asignaturas = ['Fundamentos de Hardware', 'Redes', 'Sistemas Operativos', 'PHP', 'Seguridad'];
    $busqueda = '';
    $coincidencias = [];
    $buscado = isset($_GET['q']);
    
    if ($buscado) {
        // TODO 1: Lee $_GET['q'] con ?? '' y quita espacios con trim().
        // Si no está vacío, recorre $asignaturas y añade a $coincidencias
        // las que contengan el texto; pista: stripos() !== false.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Buscar asignatura</title></head>
    <body>
    <h1>Buscar asignaturas</h1>
    <form method="get" action="">
        <input name="q" value="<?= htmlspecialchars($busqueda, ENT_QUOTES, 'UTF-8') ?>">
        <button type="submit">Buscar</button>
    </form>
    <?php if ($buscado): ?>
        <?php // TODO 2: Si la búsqueda está vacía, pide que se escriba algo.
              // Si no hay coincidencias, muestra "Sin resultados".
              // Si las hay, imprímelas en una lista <ul>, escapando cada nombre. ?>
    <?php endif; ?>
    </body></html>

    Pruebas: busca red, PHP, xxx y una cadena vacía. Observa cómo cambia la URL.

    Ejercicio 6 — Calculadora de dos números (06_calculadora.php)

    Objetivo: validar valores numéricos y elegir una operación sin aceptar operaciones desconocidas. Muestra los errores y el resultado solamente tras enviar el formulario.

    <?php
    $a = '';
    $b = '';
    $operacion = 'sumar';
    $error = '';
    $resultado = null;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee a, b y operacion usando $_POST y ?? ''.
        // Comprueba con is_numeric() que a y b son números.
        // Comprueba que operacion es "sumar", "restar" o "dividir".
    
        // TODO 2: Si la operación es dividir y b vale 0, guarda un error.
        // Si todo es válido, calcula y guarda $resultado.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Calculadora</title></head>
    <body>
    <h1>Calculadora</h1>
    <form method="post" action="">
        <input name="a" value="<?= htmlspecialchars((string) $a, ENT_QUOTES, 'UTF-8') ?>">
        <select name="operacion">
            <option value="sumar" <?= $operacion === 'sumar' ? 'selected' : '' ?>>Sumar</option>
            <option value="restar" <?= $operacion === 'restar' ? 'selected' : '' ?>>Restar</option>
            <option value="dividir" <?= $operacion === 'dividir' ? 'selected' : '' ?>>Dividir</option>
        </select>
        <input name="b" value="<?= htmlspecialchars((string) $b, ENT_QUOTES, 'UTF-8') ?>">
        <button type="submit">Calcular</button>
    </form>
    <?php // TODO 3: Muestra $error si existe; en otro caso, muestra
          // $resultado si es distinto de null. El resultado puede ser 0. ?>
    </body></html>

    Pruebas: 8 / 2 → 4; 5 - 5 → 0; 8 / 0 → error; hola + 2 → error.

    Ejercicio 7 — Opción de entrega con radio (07_entrega.php)

    Objetivo: leer un botón de opción, validar que pertenece a los valores admitidos y conservar la selección.

    <?php
    $formas = ['recogida' => 'Recogida en tienda', 'envio' => 'Envío a domicilio'];
    $seleccion = '';
    $mensaje = '';
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee $_POST['entrega'] ?? ''.
        // Comprueba con array_key_exists() que es una clave de $formas.
        // Si no lo es, guarda un error; si lo es, crea el mensaje
        // "Forma de entrega: ..." con la etiqueta correspondiente.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Entrega</title></head>
    <body>
    <h1>Elige la entrega</h1>
    <form method="post" action="">
        <?php foreach ($formas as $codigo => $texto): ?>
            <label>
                <input type="radio" name="entrega"
                    value="<?= htmlspecialchars($codigo, ENT_QUOTES, 'UTF-8') ?>"
                    <?= $seleccion === $codigo ? 'checked' : '' ?>>
                <?= htmlspecialchars($texto, ENT_QUOTES, 'UTF-8') ?>
            </label>
        <?php endforeach; ?>
        <button type="submit">Confirmar</button>
    </form>
    <?php // TODO 2: Muestra $mensaje, si existe, en un párrafo escapado. ?>
    </body></html>

    Pruebas: ninguna opción → error; una opción → mensaje y opción conservada; valor desconocido enviado manualmente → error.

    Ejercicio 8 — Etiquetas con varias casillas (08_etiquetas.php)

    Objetivo: recibir un array de opciones, comprobar sus valores y mostrar las etiquetas elegidas en una lista.

    <?php
    $opciones = ['php' => 'PHP', 'sql' => 'SQL', 'html' => 'HTML', 'linux' => 'Linux'];
    $elegidas = [];
    $error = '';
    $validas = false;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee $_POST['etiquetas'] ?? [].
        // Si no es un array, deja $elegidas vacío y guarda un error.
        // Si es un array, cópialo a $elegidas.
    
        // TODO 2: Exige al menos una etiqueta. Recorre $elegidas y
        // comprueba que cada elemento es string y clave de $opciones.
        // Si todo está bien, establece $validas en true.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Etiquetas</title></head>
    <body>
    <h1>Tecnologías que conoces</h1>
    <form method="post" action="">
        <?php foreach ($opciones as $codigo => $etiqueta): ?>
            <label>
                <input type="checkbox" name="etiquetas[]"
                    value="<?= htmlspecialchars($codigo, ENT_QUOTES, 'UTF-8') ?>"
                    <?= in_array($codigo, $elegidas, true) ? 'checked' : '' ?>>
                <?= htmlspecialchars($etiqueta, ENT_QUOTES, 'UTF-8') ?>
            </label>
        <?php endforeach; ?>
        <button type="submit">Enviar</button>
    </form>
    <?php // TODO 3: Si hay $error, muéstralo. Si $validas es true,
          // crea una lista <ul> con los nombres de $opciones elegidas.
          // Escapa los textos al imprimirlos. ?>
    </body></html>

    Pruebas: ninguna, una y varias opciones; un código que no existe debe producir error.

    Ejercicio 9 — Comentario con límite de longitud (09_comentario.php)

    Objetivo: procesar un <textarea> y contar caracteres. Un comentario válido tiene entre 10 y 300 caracteres tras quitar espacios en los extremos.

    <?php
    $comentario = '';
    $error = '';
    $guardado = false;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee $_POST['comentario'] ?? '' y usa trim().
        // Calcula su longitud con mb_strlen() si está disponible.
        // Si no lo está, utiliza strlen() e indica al profesor
        // que esta alternativa cuenta bytes en textos UTF-8.
    
        // TODO 2: Si la longitud queda fuera de 10..300, guarda
        // un error. Si es válida, establece $guardado en true.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Comentario</title></head>
    <body>
    <h1>Deja un comentario</h1>
    <form method="post" action="">
        <label for="comentario">Comentario:</label><br>
        <textarea id="comentario" name="comentario" rows="5" cols="45"><?= htmlspecialchars($comentario, ENT_QUOTES, 'UTF-8') ?></textarea><br>
        <button type="submit">Enviar</button>
    </form>
    <?php // TODO 3: Muestra el error o, si $guardado es true,
          // muestra el comentario dentro de un <p>.
          // Escapa antes de imprimir y utiliza nl2br() si quieres
          // conservar los saltos de línea visualmente. ?>
    </body></html>

    Pruebas: 9, 10, 300 y 301 caracteres; añade un salto de línea y texto con <b>.

    Ejercicio 10 — Comprobar una dirección de correo (10_correo.php)

    Objetivo: validar un correo sin enviarlo ni guardarlo. Muestra también el nombre del dominio tras la @ cuando sea válido.

    <?php
    $correo = '';
    $error = '';
    $dominio = '';
    $valido = false;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee y recorta $_POST['correo'] ?? ''.
        // Valida con filter_var($correo, FILTER_VALIDATE_EMAIL).
        // Si falla, establece $error.
    
        // TODO 2: Si es válido, separa el correo por '@' con explode()
        // y guarda el dominio en $dominio. Activa $valido.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Correo</title></head>
    <body>
    <h1>Comprobar correo</h1>
    <form method="post" action="">
        <input name="correo" type="text"
            value="<?= htmlspecialchars($correo, ENT_QUOTES, 'UTF-8') ?>">
        <button type="submit">Comprobar</button>
    </form>
    <?php // TODO 3: Muestra $error o "Correo válido. Dominio: ...".
          // Escapa el dominio antes de mostrarlo. ?>
    </body></html>

    Pruebas: vacío, ana, ana@ejemplo.test y un correo con espacios alrededor.

    Ejercicio 11 — Precio con descuento mediante función (11_descuento.php)

    Objetivo: crear una función propia y llamarla desde el procesamiento del formulario. Porcentaje admitido: de 0 a 100.

    <?php
    // TODO 1: Crea la función aplicarDescuento(float $precio, float $porcentaje): float.
    // Debe devolver el precio después de restarle el porcentaje indicado.
    
    $precio = '';
    $porcentaje = '';
    $error = '';
    $precioFinal = null;
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 2: Lee precio y porcentaje desde $_POST con ?? ''.
        // Verifica que ambos son numéricos. Precio no puede ser negativo;
        // porcentaje debe estar entre 0 y 100.
        // Si hay un dato incorrecto, guarda un mensaje en $error.
    
        // TODO 3: Cuando los datos sean válidos, convierte a float,
        // llama a aplicarDescuento() y guarda $precioFinal.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Descuento</title></head>
    <body>
    <h1>Calcular descuento</h1>
    <form method="post" action="">
        <label>Precio: <input name="precio" value="<?= htmlspecialchars((string) $precio, ENT_QUOTES, 'UTF-8') ?>"></label>
        <label>Descuento (%): <input name="porcentaje" value="<?= htmlspecialchars((string) $porcentaje, ENT_QUOTES, 'UTF-8') ?>"></label>
        <button type="submit">Calcular</button>
    </form>
    <?php // TODO 4: Muestra el error o el precio final con
          // number_format($precioFinal, 2, ',', '.') cuando no sea null. ?>
    </body></html>

    Pruebas: 100 y 20 → 80,00; 100 y 100 → 0,00; descuento 101 o precio negativo → error.

    Ejercicio 12 — Guardar una nota en un archivo (12_notas.php)

    Objetivo: añadir notas a un archivo de texto y volver a leerlas. Usa una nota por línea y evita que los saltos de línea del formulario creen entradas adicionales.

    <?php
    $ruta = __DIR__ . '/notas.txt';
    $nota = '';
    $mensaje = '';
    $contenido = '';
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Lee $_POST['nota'] ?? '' y aplica trim().
        // Rechaza el texto vacío. Sustituye \r y \n por espacios
        // antes de guardar, para mantener una nota por línea.
    
        // TODO 2: Añade la nota al archivo con file_put_contents(),
        // FILE_APPEND y LOCK_EX; añade PHP_EOL al final.
        // Comprueba el resultado con === false. Si falla, muestra error;
        // si funciona, muestra "Nota guardada".
    }
    
    // TODO 3: Si notas.txt existe, lee su contenido con file_get_contents().
    // Si la lectura falla, muestra un error y deja $contenido vacío.
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Notas</title></head>
    <body>
    <h1>Bloc de notas</h1>
    <form method="post" action="">
        <label>Nota: <input name="nota" value="<?= htmlspecialchars($nota, ENT_QUOTES, 'UTF-8') ?>"></label>
        <button type="submit">Guardar</button>
    </form>
    <?php // TODO 4: Muestra $mensaje y $contenido con HTML escapado.
          // Para que los saltos del archivo se vean, puedes usar nl2br()
          // DESPUÉS de htmlspecialchars(). ?>
    </body></html>

    Pruebas: guarda dos notas, recarga la página y verifica que siguen ahí; envía una nota vacía. El directorio donde está 12_notas.php debe permitir la escritura del archivo notas.txt.

    Ejercicio 13 — Contar visitas con sesión (13_sesion.php)

    Objetivo: usar $_SESSION para mantener un contador entre peticiones y reiniciarlo desde un formulario.

    <?php
    session_start(); // Debe ejecutarse antes de enviar HTML.
    
    // TODO 1: Si no existe $_SESSION['visitas'], inicialízala en 0.
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 2: Si $_POST['accion'] ?? '' es "reiniciar",
        // pon $_SESSION['visitas'] a 0.
    } else {
        // TODO 3: Incrementa el contador en cada carga GET.
    }
    
    $visitas = $_SESSION['visitas'] ?? 0;
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Sesión</title></head>
    <body>
    <h1>Contador de visitas</h1>
    <p>Visitas: <?= (int) $visitas ?></p>
    <form method="post" action="">
        <input type="hidden" name="accion" value="reiniciar">
        <button type="submit">Reiniciar</button>
    </form>
    </body></html>

    Pruebas: recarga tres veces, reinicia y vuelve a recargar. Explica qué cuenta el ejercicio: cargas GET dentro de la misma sesión, no usuarios distintos.

    Ejercicio 14 — Subir una imagen con $_FILES (14_subida.php)

    Objetivo: recibir un fichero de un formulario, revisar el error de subida y guardarlo de forma segura. Solo se admiten imágenes JPEG o PNG de 2 MB como máximo. Este ejercicio requiere que PHP pueda crear la carpeta subidas junto al archivo.

    <?php
    $mensaje = '';
    $nombreGuardado = '';
    $directorio = __DIR__ . '/subidas';
    
    if ($_SERVER['REQUEST_METHOD'] === 'POST') {
        // TODO 1: Comprueba que existe $_FILES['imagen'] y que
        // $_FILES['imagen']['error'] === UPLOAD_ERR_OK.
        // Si falta el archivo o PHP informa de otro error, guarda
        // un mensaje de error y no intentes moverlo.
    
        // TODO 2: Si no hubo error, comprueba que 'size' es mayor
        // que 0 y no supera 2 * 1024 * 1024 bytes.
        // Obtén la ruta temporal desde $_FILES['imagen']['tmp_name'].
        // NO confíes en $_FILES['imagen']['type'] ni en la extensión
        // original: detecta el MIME real con
        // (new finfo(FILEINFO_MIME_TYPE))->file($rutaTemporal).
        // Acepta solo image/jpeg e image/png.
    
        // TODO 3: Si el archivo es válido, crea $directorio con
        // mkdir($directorio, 0755, true) cuando no exista.
        // Comprueba también que la carpeta existe antes de mover.
        // Genera un nombre nuevo con bin2hex(random_bytes(16)):
        // añade '.jpg' para JPEG o '.png' para PNG.
        // NO uses el nombre original enviado por el navegador.
    
        // TODO 4: Mueve el fichero con move_uploaded_file()
        // a $directorio . '/' . $nombreGuardado.
        // Comprueba si devuelve true. Guarda en $mensaje
        // "Imagen subida" si va bien o un error si falla.
    }
    ?>
    <!doctype html>
    <html lang="es"><head><meta charset="UTF-8"><title>Subida de imagen</title></head>
    <body>
    <h1>Subir imagen</h1>
    <form method="post" action="" enctype="multipart/form-data">
        <label for="imagen">Selecciona una imagen JPEG o PNG:</label>
        <input id="imagen" name="imagen" type="file" accept="image/jpeg,image/png">
        <button type="submit">Subir</button>
    </form>
    <?php // TODO 5: Muestra $mensaje, escapándolo.
          // Si $nombreGuardado no está vacío Y la subida funcionó,
          // muestra el nombre nuevo del archivo también escapado.
          // No crees una URL pública de las imágenes en este ejercicio. ?>
    </body></html>

    Pruebas: sube JPEG, PNG, TXT, imagen mayor de 2 MB y formulario sin archivo. Comprueba los nombres nuevos en subidas. El atributo accept ayuda al navegador, pero la validación verdadera debe hacerse en PHP.

    Criterios comunes de corrección para los diez ejercicios

    • El archivo abre sin errores de sintaxis y la primera carga no produce avisos por índices inexistentes.
    • El resultado esperado aparece únicamente cuando se envían datos adecuados.
    • Los datos que llegan del formulario se validan y los textos mostrados en HTML se escapan.
    • El alumno entrega el código completado y evidencia de al menos dos pruebas por ejercicio, incluyendo un error de entrada.
  • Operación Faro — primera investigación con Kali Linux

    Operación Faro — primera investigación con Kali Linux

    El Centro Faro estrena una pequeña web de avisos. El equipo de seguridad sospecha que se ha publicado un documento interno y que alguien ha cambiado la página de inicio.

    Tu misión consiste en crear un pequeño laboratorio en Kali Linux, investigarlo, guardar pruebas y corregir los problemas encontrados. Todos los archivos y datos de esta práctica son ficticios.

    Duración: dos sesiones de 60–75 minutos.
    Modalidad: individual o en pareja.
    Entrega: carpeta del proyecto comprimida en ZIP, con un README.md y las evidencias solicitadas.

    Qué aprenderás

    • Descubrir un servicio con Nmap.
    • Examinar respuestas HTTP con curl.
    • Observar tu propio tráfico con Wireshark.
    • Comprobar cambios en archivos mediante SHA-256.
    • Documentar un hallazgo y verificar su corrección.

    Reglas del laboratorio

    Todas las pruebas de red se realizan exclusivamente contra 127.0.0.1 en tu propio Kali. No sustituyas esta dirección por la IP de un compañero, de la red del centro o de una web pública.

    Cuando se indique «terminal 2», abre otra pestaña o ventana. Mantén abierta la terminal del servidor hasta que se te indique detenerlo.


    Fase 0. Preparar el laboratorio

    Paso 1. Identifica tu sistema

    cat /etc/os-release | head -n 5
    whoami
    pwd

    Anota en tu README.md qué sistema utilizas y cuál es tu nombre de usuario.

    Paso 2. Comprueba las herramientas

    command -v python3
    command -v nmap
    command -v curl
    command -v wireshark
    command -v sha256sum

    Si falta nmap, curl o wireshark, instala la herramienta que necesites. Por ejemplo:

    sudo apt update
    sudo apt install nmap curl wireshark

    Si falta python3 o sha256sum, consulta con el profesor antes de continuar.

    Paso 3. Crea las carpetas

    mkdir -p ~/operacion-faro/{publico,evidencias,privado}
    cd ~/operacion-faro

    Importante: ejecuta los siguientes comandos desde ~/operacion-faro, salvo que se indique otra cosa.

    Paso 4. Crea la página web pública

    Copia el bloque completo, incluidas las dos líneas que contienen EOF:

    cat > publico/index.html <<'EOF'
    <!doctype html>
    <html lang="es">
    <meta charset="utf-8">
    <title>Centro Faro</title>
    <h1>Centro Faro</h1>
    <p>Avisos públicos del centro.</p>
    EOF

    Paso 5. Crea un documento interno ficticio

    Por error, este archivo quedará dentro de la carpeta publicada:

    cat > publico/inventario_interno.txt <<'EOF'
    CENTRO FARO - INVENTARIO FICTICIO
    Equipo: faro-lab-01
    Responsable: Equipo de pruebas
    Sala: Laboratorio A
    Nota: estos datos han sido inventados para esta práctica.
    EOF

    Comprueba los archivos:

    ls -l publico

    Evidencia 0: indica en el README.md para qué crees que sirven Nmap, curl, Wireshark y sha256sum.


    Misión 1. Descubrir la puerta abierta

    Paso 1. Arranca el servidor

    En la terminal 1, dentro de ~/operacion-faro, ejecuta:

    python3 -m http.server 8765 --bind 127.0.0.1 --directory publico

    Deja abierta esa terminal. El servidor debe indicar que escucha en 127.0.0.1, puerto 8765.

    Paso 2. Abre otra terminal

    En la terminal 2, entra en el proyecto:

    cd ~/operacion-faro

    Comprueba que puedes leer la página:

    curl http://127.0.0.1:8765/

    Resultado esperado: aparece el HTML de «Centro Faro».

    Paso 3. Examina los puertos

    nmap -sT -p 8765,8766 127.0.0.1 | tee evidencias/puertos.txt

    Resultado esperado: el puerto 8765 aparece como open. El 8766 normalmente aparecerá como closed; si está abierto, puede estar utilizándolo otro programa.

    Responde en el README.md:

    • ¿Qué significa que el puerto 8765 esté abierto?
    • ¿Qué programa lo está utilizando?
    • ¿Qué representa la dirección 127.0.0.1?

    Evidencia 1: archivo evidencias/puertos.txt y una captura del resultado.


    Misión 2. Encontrar un archivo publicado por error

    Paso 1. Consulta las cabeceras HTTP

    curl -I http://127.0.0.1:8765/

    Localiza el código de estado y el campo Content-Type.

    Paso 2. Solicita el documento interno

    curl -i http://127.0.0.1:8765/inventario_interno.txt | tee evidencias/exposicion.txt

    Resultado esperado: 200 OK y el contenido del inventario ficticio.

    El código 200 indica que el servidor ha entregado el archivo. No significa que publicarlo haya sido una buena decisión.

    Paso 3. Busca la causa

    ls -l publico/inventario_interno.txt

    Observa que el documento está dentro de publico, la carpeta desde la que sirve archivos el servidor.

    Escribe en el README.md una explicación con este esquema:

    Hallazgo → prueba → posible consecuencia → corrección propuesta.

    Evidencia 2: archivo evidencias/exposicion.txt y tu explicación. Guarda esta prueba antes de corregir el problema.


    Misión 3. Observar una petición con Wireshark

    Vas a capturar tu propia comunicación local, entre Kali y el servidor que acabas de iniciar.

    Paso 1. Abre Wireshark

    Ábrelo desde el menú de Kali o ejecuta wireshark en otra terminal. Selecciona la interfaz lo o Loopback e inicia la captura.

    Si no tienes permiso para capturar, comunica el mensaje al profesor. No cambies los permisos del sistema por tu cuenta.

    Paso 2. Genera una petición

    En la terminal 2, ejecuta:

    curl http://127.0.0.1:8765/index.html

    Paso 3. Filtra la captura

    Detén la captura. En el campo de filtro de visualización de Wireshark escribe:

    tcp.port == 8765

    Localiza la petición GET /index.html y la respuesta 200 OK. Si aparecen demasiados paquetes, prueba también este filtro:

    http

    Guarda la captura como evidencias/trafico-local.pcapng y haz una captura de pantalla donde se vean la petición y la respuesta. Antes de entregarla, comprueba que contiene únicamente el tráfico de esta prueba.

    Responde en el README.md:

    • ¿Qué archivo se pidió?
    • ¿Qué respondió el servidor?
    • ¿Por qué puedes leer el nombre del archivo solicitado en esta comunicación HTTP?

    Evidencia 3: archivo .pcapng, captura de pantalla y respuestas.


    Misión 4. Detectar un cambio en la web

    Una huella SHA-256 permite comprobar si los bytes de un archivo siguen siendo los mismos.

    Paso 1. Guarda una copia y calcula la huella

    En la terminal 2, ejecuta:

    cd ~/operacion-faro
    cp publico/index.html privado/index_original.html
    sha256sum publico/index.html | tee evidencias/huella_original.txt
    sha256sum publico/index.html > comprobacion.sha256
    sha256sum -c comprobacion.sha256

    Resultado esperado: publico/index.html: OK.

    Paso 2. Simula una modificación

    printf '\n<!-- Cambio de prueba realizado en clase -->\n' >> publico/index.html
    sha256sum -c comprobacion.sha256 | tee evidencias/comprobacion_cambio.txt

    Resultado esperado: FAILED. El archivo ya no coincide con la huella guardada.

    Importante: una huella diferente demuestra que el contenido cambió. Por sí sola no indica quién lo cambió ni demuestra que hubiera un ataque.

    Paso 3. Restaura y vuelve a comprobar

    cp privado/index_original.html publico/index.html
    sha256sum -c comprobacion.sha256 | tee evidencias/comprobacion_restaurada.txt

    Resultado esperado: OK.

    Evidencia 4: los archivos huella_original.txt, comprobacion_cambio.txt y comprobacion_restaurada.txt. Explica brevemente qué ha demostrado cada comprobación.


    Misión 5. Corregir el problema y verificarlo

    Paso 1. Retira el documento de la carpeta pública

    mv publico/inventario_interno.txt privado/inventario_interno.txt

    Conservamos el archivo como parte del ejercicio, pero ya no está en la carpeta que publica el servidor.

    Paso 2. Repite la petición original

    curl -i http://127.0.0.1:8765/inventario_interno.txt | tee evidencias/despues_correccion.txt

    Resultado esperado: 404 File not found. La ruta ya no entrega el documento.

    Paso 3. Comprueba que la web sigue funcionando

    curl -I http://127.0.0.1:8765/index.html
    sha256sum -c comprobacion.sha256

    Resultado esperado: 200 OK para la página y OK para la huella.

    Paso 4. Detén el servidor

    Vuelve a la terminal 1 y pulsa Ctrl+C. En la terminal 2 comprueba el estado del puerto:

    nmap -sT -p 8765 127.0.0.1 | tee evidencias/puerto_cerrado.txt

    Resultado esperado: closed, siempre que ningún otro programa haya empezado a utilizar el puerto.

    Evidencia 5: archivos despues_correccion.txt y puerto_cerrado.txt. Explica cómo verificaste la corrección.


    Entrega

    Comprime y entrega la carpeta operacion-faro con esta estructura:

    operacion-faro/
    ├── README.md
    ├── comprobacion.sha256
    ├── publico/
    │   └── index.html
    ├── privado/
    │   ├── index_original.html
    │   └── inventario_interno.txt
    └── evidencias/
        ├── puertos.txt
        ├── exposicion.txt
        ├── trafico-local.pcapng
        ├── huella_original.txt
        ├── comprobacion_cambio.txt
        ├── comprobacion_restaurada.txt
        ├── despues_correccion.txt
        ├── puerto_cerrado.txt
        └── capturas_de_pantalla...

    En el README.md, organiza tu trabajo en estos apartados:

    1. Entorno y herramientas utilizadas.
    2. Servicio y puerto descubierto.
    3. Archivo publicado por error.
    4. Tráfico observado en Wireshark.
    5. Comprobación de integridad.
    6. Corrección y verificación.
    7. Tres cosas que has aprendido y una duda que te queda.

    Si alguna herramienta falla, documenta el comando, el error y lo que intentaste. Una incidencia bien explicada también forma parte del trabajo.

    Referencias para el profesor

  • OSINT: qué revela un documento Word

    OSINT: qué revela un documento Word

    Archivo entregado por el profesor: comunicado_faro_norte.docx. Es un caso ficticio preparado para esta práctica. No difundas una lista de respuestas antes de que todos los grupos terminen.

    Situación

    El equipo de comunicación de una empresa ficticia, Faro Norte, va a publicar un documento Word. Antes de hacerlo, quiere saber qué información podría descubrir cualquier persona que descargue el archivo. Actuarás como analista y elaborarás un informe breve con pruebas y recomendaciones.

    Trabaja únicamente con el documento de la práctica o con archivos propios autorizados. No publiques nombres reales, rutas personales ni documentos de terceros en servicios de análisis en línea.

    Objetivos

    • Distinguir el contenido visible, las propiedades internas del documento y los datos del sistema de archivos.
    • Extraer propiedades con una interfaz gráfica y con ExifTool.
    • Inspeccionar las partes internas de un DOCX sin modificar el original.
    • Explicar qué conclusiones están demostradas y cuáles son solo hipótesis.
    • Comprobar qué información permanece tras preparar una copia para publicación.

    Material

    • Un equipo con Microsoft Word o LibreOffice Writer y acceso a terminal.
    • ExifTool instalado. Comprueba con exiftool -ver. Si no está disponible, realiza los pasos de Word/LibreOffice y la inspección del DOCX; deja constancia de ello.
    • El archivo comunicado_faro_norte.docx, facilitado junto a este enunciado. El documento y las identidades que figuran en él son ficticios.

    Fase 1. Preparar el archivo y leer lo visible (10 minutos)

    1. Descarga comunicado_faro_norte.docx. Conserva este archivo sin abrirlo en un editor que guarde automáticamente.
    2. Duplica el archivo y llama a la copia comunicado_faro_norte_copia.docx. Analiza la copia; conserva el archivo entregado para poder comparar al final. Si usas una aplicación con guardado automático, desactívalo para este caso o trabaja siempre sobre otra copia.
    3. Abre la copia en Word o LibreOffice y anota únicamente lo que cualquiera puede ver al leer el documento: título, lugar, fecha, actividades y correo de contacto. Cierra sin guardar.
    4. Explica por qué los datos visibles no equivalen a los metadatos. Formula dos preguntas que crees que el documento podría responder sin que la información aparezca en la página.

    Evidencia 1: captura del comunicado y tabla con cinco datos visibles. Todos los nombres y lugares pertenecen al caso ficticio.

    Fase 2. Observar antes de extraer (5 minutos)

    1. Apunta el nombre, tamaño y extensión de la copia.
    2. Anota la fecha de modificación que muestra el explorador de archivos.
    3. Abre el documento y localiza su panel de propiedades: Archivo → Información → Propiedades en Word, o Archivo → Propiedades en LibreOffice. Registra los campos que aparezcan.
    4. Responde: ¿la fecha que muestra el sistema operativo pertenece necesariamente al contenido original? Justifica tu respuesta pensando en la copia que acabas de hacer.

    Evidencia 2: tabla con las propiedades visibles y su procedencia (explorador o editor).

    Fase 3. Leer metadatos con ExifTool (10 minutos)

    Abre una terminal en la carpeta del archivo. Ejecuta:

    exiftool -a -G1 -s comunicado_faro_norte_copia.docx

    En Windows PowerShell, si ExifTool no está en PATH, usa la ruta del ejecutable y del archivo entre comillas:

    & "C:\ruta\a\exiftool.exe" -a -G1 -s "C:\ruta\al\comunicado_faro_norte_copia.docx"

    Anota, solo si existen, Creator, LastModifiedBy, Title, Subject, Keywords, CreateDate, ModifyDate, RevisionNumber, Company, Manager, FileSize, FileType y FileModifyDate. Los nombres exactos pueden variar. No inventes campos ausentes. El prefijo entre corchetes indica el grupo de cada dato.

    Evidencia 3: captura o salida copiada del comando y una tabla:

    CampoValor encontradoGrupo / fuente¿Dato introducido, generado o incierto?

    Pregunta: compara las fechas internas con FileModifyDate. ¿Por qué podrían diferir?

    Fase 4. Examinar el interior del DOCX (15 minutos)

    Un DOCX es un paquete de archivos. Inspecciona una copia adicional sin sobrescribir el documento de trabajo.

    Opción gráfica, válida para Windows, macOS y Linux: duplica el .docx, cambia la extensión de esa copia a .zip y ábrela con un descompresor. Si el sistema pregunta si deseas cambiar la extensión, acepta. Abre estos archivos como texto (no ejecutes ningún contenido):

    • docProps/core.xml: propiedades principales, como creador, título y fechas, si están presentes.
    • docProps/app.xml: propiedades de aplicación, como el programa o estadísticas, cuando existen.
    • word/document.xml: texto del documento en formato XML; su lectura puede resultar incómoda porque el texto está dividido en elementos.

    Opción terminal en Linux/macOS:

    unzip -l comunicado_faro_norte_copia.docx
    unzip -p comunicado_faro_norte_copia.docx docProps/core.xml
    unzip -p comunicado_faro_norte_copia.docx docProps/app.xml

    En Windows puedes usar la opción gráfica; no necesitas instalar comandos adicionales.

    Evidencia 4: nombres de al menos cinco entradas del paquete y dos valores concretos encontrados en core.xml o app.xml. Si un archivo no existe, registra esa ausencia.

    Preguntas: ¿qué datos de ExifTool puedes localizar también en XML? ¿Qué datos proceden del sistema de archivos y no están en esos XML? Localiza también, si aparecen, propiedades que apunten a un proyecto o a personas que no se mencionan en el texto visible. ¿Encuentras alguna información que no se vea al leer el comunicado?

    Fase 5. Construir un informe OSINT (15 minutos)

    Rellena esta tabla. Usa «No consta» si un dato no aparece; «Hipótesis» si depende de una interpretación.

    AfirmaciónEvidencia exacta y ubicaciónGrado de confianzaPosible explicación alternativa
    El documento contiene un título interno
    Una persona concreta lo redactó
    Se editó después de crearlo
    Se utilizó un programa determinado

    Después responde en 100–150 palabras: ¿qué podría aprender un tercero que solo recibiese este DOCX? ¿Qué afirmaciones no puedes demostrar con los metadatos? Recuerda que el campo «Autor» puede configurarse manualmente o conservarse de una plantilla y no identifica necesariamente a quien escribió el texto.

    Fase 6. Reducir exposición y volver a comprobar (10–15 minutos)

    1. Conserva intacto el original. Crea comunicado_faro_norte_publicacion.docx.
    2. En Word, si está disponible, utiliza Archivo → Información → Comprobar si hay problemas → Inspeccionar documento; revisa las categorías ofrecidas y elimina de la copia las propiedades personales que decidas retirar. En LibreOffice, revisa Archivo → Propiedades y las opciones de eliminación de información personal al guardar disponibles en tu versión. Anota exactamente qué hiciste.
    3. Repite el comando de la fase 3 para la copia de publicación. Vuelve a examinar docProps/core.xml en esa copia.
    4. Compara antes y después. No des por hecho que todos los campos desaparecieron. Verifica también que el contenido que se pretende publicar sigue presente.
    Campo o contenidoAntesDespués¿Permanece?
    Autor
    Último editor
    Fechas internas
    Título
    Texto visible

    Conclusión: redacta tres medidas concretas que recomendarías antes de publicar documentos de tu centro o empresa.

    Ampliación opcional: formato DOC antiguo

    Si el profesor proporciona un .doc autorizado, repite solo las fases 2, 3 y 5. El formato .doc es binario: no intentes abrirlo como ZIP ni esperes encontrar docProps/core.xml. Compara qué propiedades puede recuperar ExifTool en cada formato y describe los límites de la comparación.

    Entrega

    Sube un ZIP con:

    1. README.md con objetivo, entorno utilizado, pasos realizados, tablas completadas, respuestas y conclusión.
    2. evidencias/ con capturas o salidas de terminal legibles, sin información personal real.
    3. El DOCX ficticio entregado y la copia preparada para publicación. No incluyas otros archivos personales.

    El README debe permitir que otra persona repita la práctica. Identifica cada captura en el texto. No se evaluará encontrar un número determinado de metadatos: algunos dependen del editor, la configuración y cómo se creó el archivo.

  • PRIMEROS PASOS CON ARDUINO Y WOKWI

    PRIMEROS PASOS CON ARDUINO Y WOKWI

    1. Presentación

    En este proyecto aprenderás los fundamentos de Arduino utilizando Wokwi, un simulador electrónico que funciona directamente desde el navegador. Durante la primera parte no necesitarás instalar Arduino IDE ni disponer de una placa física.

    Realizarás varios ejercicios guiados y resueltos. Deberás reproducirlos, comprobar su funcionamiento, introducir pequeñas modificaciones y documentar el trabajo realizado.

    En la última parte trasladarás uno de los circuitos a un Arduino real.

    No basta con copiar el código. Debes montar cada circuito, ejecutarlo, observar qué sucede y explicar con tus palabras cómo funciona.


    2. Objetivos

    Al terminar el proyecto serás capaz de:

    • Crear y guardar proyectos en Wokwi.
    • Reconocer las partes principales de una placa Arduino Uno.
    • Comprender la función de setup() y loop().
    • Configurar pines digitales como entradas o salidas.
    • Encender y apagar LED.
    • Utilizar pausas con delay().
    • Enviar información al monitor serie.
    • Leer el estado de un pulsador.
    • Construir un circuito sencillo en una protoboard.
    • Documentar una práctica técnica en formato Markdown.

    3. Herramientas necesarias

    Parte simulada

    • Ordenador con navegador web.
    • Cuenta de Wokwi.
    • Acceso a https://wokwi.com/.
    • Editor de Markdown utilizado en clase.

    Parte física final

    • Arduino Uno o placa compatible.
    • Cable USB.
    • Protoboard.
    • Un LED rojo, uno amarillo y uno verde.
    • Tres resistencias de 220 Ω o 330 Ω.
    • Un pulsador.
    • Cables de conexión.
    • Un equipo preparado por el profesor con Arduino IDE o Arduino Cloud Agent.

    4. Normas de trabajo

    Para cada ejercicio debes:

    1. Crear o duplicar un proyecto en Wokwi.
    2. Montar el circuito indicado.
    3. Copiar y ejecutar el código proporcionado.
    4. Abrir el monitor serie cuando se solicite.
    5. Comprobar el resultado.
    6. Realizar la modificación propuesta.
    7. Guardar el enlace del proyecto.
    8. Añadir a la documentación una captura y una explicación personal.

    En la documentación no se aceptarán explicaciones como «funciona bien» o «enciende el LED». Debes indicar qué elementos intervienen, qué instrucciones se ejecutan y cuál es el resultado observado.


    Parte I. Ejercicios guiados y resueltos en Wokwi

    Ejercicio 1. Hola, Arduino: uso del monitor serie

    Objetivo

    Aprender a enviar mensajes desde Arduino al ordenador mediante la comunicación serie.

    Componentes

    • Arduino Uno.

    No es necesario añadir componentes externos.

    Esquema visual

    En este ejercicio no existe cableado externo: la salida se observa en el monitor serie.

    flowchart LR
        A["Arduino Uno"] -->|"USB / comunicación serie a 9600 baudios"| M["Monitor serie de Wokwi"]
        M --> R["Mensajes y resultados"]

    Preparación en Wokwi

    1. Entra en https://wokwi.com/.
    2. Selecciona Start from Scratch.
    3. Elige Arduino Uno.
    4. Abre el archivo sketch.ino.
    5. Sustituye su contenido por el siguiente código.

    Código resuelto

    void setup() {
      Serial.begin(9600);
      Serial.println("Arduino iniciado correctamente");
    }
    
    void loop() {
      Serial.println("El programa sigue funcionando");
      delay(1000);
    }

    Explicación

    • Serial.begin(9600) inicia la comunicación serie a 9600 bits por segundo.
    • Serial.println() envía un texto y añade un salto de línea.
    • El mensaje incluido en setup() aparece una sola vez.
    • El mensaje incluido en loop() se repite cada segundo.
    • delay(1000) detiene el programa durante 1000 milisegundos.

    Comprobación

    Inicia la simulación. La consola o monitor serie debería mostrar:

    Arduino iniciado correctamente
    El programa sigue funcionando
    El programa sigue funcionando
    El programa sigue funcionando

    Modificación obligatoria

    Modifica el programa para que:

    • Muestre tu nombre al comenzar.
    • Muestre el texto Han pasado dos segundos cada dos segundos.

    Documentación

    Incluye una captura del monitor serie y explica por qué el primer mensaje aparece una sola vez y el segundo se repite.


    Ejercicio 2. LED integrado intermitente

    Objetivo

    Controlar una salida digital utilizando el LED integrado de Arduino Uno.

    Componentes

    • Arduino Uno.
    • LED integrado de la placa, conectado internamente al pin 13.

    Esquema visual

    flowchart LR
        A["Arduino Uno"] --> P["Pin digital 13"]
        P --> L["LED integrado L"]
        A -.->|"USB"| M["Monitor serie"]

    El LED marcado como L ya está montado en la placa. No debes añadir cables ni componentes.

    Código resuelto

    const int LED = 13;
    
    void setup() {
      pinMode(LED, OUTPUT);
      Serial.begin(9600);
      Serial.println("Prueba del LED iniciada");
    }
    
    void loop() {
      digitalWrite(LED, HIGH);
      Serial.println("LED encendido");
      delay(1000);
    
      digitalWrite(LED, LOW);
      Serial.println("LED apagado");
      delay(1000);
    }

    Explicación

    • const int LED = 13 asigna un nombre al número del pin.
    • pinMode(LED, OUTPUT) configura el pin como salida.
    • digitalWrite(LED, HIGH) activa el pin y enciende el LED.
    • digitalWrite(LED, LOW) desactiva el pin y apaga el LED.
    • Los mensajes permiten relacionar el estado físico del LED con la ejecución del programa.

    Modificación obligatoria

    Consigue que el LED:

    1. Permanezca encendido durante dos segundos.
    2. Permanezca apagado durante medio segundo.
    3. Muestre los estados correspondientes en el monitor serie.

    Preguntas

    1. ¿Para qué sirve pinMode()?
    2. ¿Qué diferencia hay entre HIGH y LOW?
    3. ¿Cuántas veces se ejecuta setup()?
    4. ¿Cuántas veces se ejecuta loop()?

    Ejercicio 3. Conexión de un LED externo

    Objetivo

    Aprender a conectar un LED externo y una resistencia a Arduino.

    Componentes

    • Arduino Uno.
    • Un LED rojo.
    • Una resistencia de 220 Ω o 330 Ω.
    • Cables.

    Conexiones

    ElementoConexión
    Pin 8 de ArduinoResistencia
    ResistenciaPata larga del LED, ánodo
    Pata corta del LED, cátodoGND

    La resistencia limita la corriente que atraviesa el LED y ayuda a evitar que se dañe.

    Esquema visual

    flowchart LR
        D8["Arduino D8"] --> R["Resistencia 220–330 Ω"]
        R --> A["Ánodo + · pata larga"]
        A --> L["LED rojo"]
        L --> C["Cátodo − · pata corta"]
        C --> G["Arduino GND"]
        USB["Conexión USB"] -.-> M["Monitor serie"]

    Recorrido de la corriente: D8 → resistencia → ánodo del LED → cátodo → GND.

    Código resuelto

    const int LED_ROJO = 8;
    int numeroParpadeo = 0;
    
    void setup() {
      pinMode(LED_ROJO, OUTPUT);
      Serial.begin(9600);
      Serial.println("LED externo preparado");
    }
    
    void loop() {
      numeroParpadeo++;
    
      digitalWrite(LED_ROJO, HIGH);
      Serial.print("Parpadeo numero: ");
      Serial.println(numeroParpadeo);
      delay(500);
    
      digitalWrite(LED_ROJO, LOW);
      delay(500);
    }

    Explicación

    Serial.print() escribe sin realizar un salto de línea. A continuación, Serial.println(numeroParpadeo) muestra el valor y termina la línea. De esta manera, texto y número aparecen juntos.

    Resultado esperado

    LED externo preparado
    Parpadeo numero: 1
    Parpadeo numero: 2
    Parpadeo numero: 3

    Modificación obligatoria

    Conecta el LED al pin 7, adapta el programa y haz que parpadee cada 250 milisegundos.

    Preguntas

    1. ¿Por qué se utiliza una resistencia?
    2. ¿Qué ocurriría si cambias el montaje al pin 7 pero no modificas el código?
    3. ¿Para qué sirve la variable numeroParpadeo?

    Ejercicio 4. Semáforo sencillo

    Objetivo

    Controlar varias salidas digitales y crear una secuencia.

    Componentes

    • Arduino Uno.
    • Un LED rojo.
    • Un LED amarillo.
    • Un LED verde.
    • Tres resistencias de 220 Ω o 330 Ω.

    Conexiones

    LEDPin de ArduinoConexión restante
    Rojo10Resistencia y GND
    Amarillo9Resistencia y GND
    Verde8Resistencia y GND

    Cada LED debe disponer de su propia resistencia.

    Esquema visual

    Los tres puntos GND representan la misma conexión de tierra de Arduino. Puedes unir los tres cátodos a la línea negativa de la protoboard y conectar esa línea a un pin GND de la placa.

    flowchart LR
        D10["D10"] --> RR["Resistencia"] --> LR["LED rojo"] --> G1["GND"]
        D9["D9"] --> RA["Resistencia"] --> LA["LED amarillo"] --> G2["GND"]
        D8["D8"] --> RV["Resistencia"] --> LV["LED verde"] --> G3["GND"]

    Código resuelto

    const int LED_ROJO = 10;
    const int LED_AMARILLO = 9;
    const int LED_VERDE = 8;
    
    void setup() {
      pinMode(LED_ROJO, OUTPUT);
      pinMode(LED_AMARILLO, OUTPUT);
      pinMode(LED_VERDE, OUTPUT);
    
      Serial.begin(9600);
      Serial.println("Semaforo iniciado");
    }
    
    void loop() {
      digitalWrite(LED_ROJO, HIGH);
      digitalWrite(LED_AMARILLO, LOW);
      digitalWrite(LED_VERDE, LOW);
      Serial.println("ROJO: detenerse");
      delay(3000);
    
      digitalWrite(LED_ROJO, LOW);
      digitalWrite(LED_VERDE, HIGH);
      Serial.println("VERDE: avanzar");
      delay(3000);
    
      digitalWrite(LED_VERDE, LOW);
      digitalWrite(LED_AMARILLO, HIGH);
      Serial.println("AMARILLO: precaucion");
      delay(1000);
    }

    Comprobación

    Observa que solamente debe permanecer encendido un LED en cada momento. Comprueba que el monitor serie muestra el mismo estado que representa el circuito.

    Modificación obligatoria

    Cambia los tiempos para que:

    • El rojo dure cuatro segundos.
    • El verde dure cinco segundos.
    • El amarillo dure dos segundos.

    Añade antes de cada cambio el mensaje Cambiando estado del semaforo.

    Preguntas

    1. ¿Por qué se declaran tres constantes diferentes?
    2. ¿Qué LED se enciende después del rojo?
    3. ¿Cuánto dura una secuencia completa tras realizar la modificación?
    4. ¿Por qué conviene mostrar el estado en el monitor serie?

    Ejercicio 5. Pulsador y monitor serie

    Objetivo

    Leer una entrada digital y mostrar su estado en el monitor serie.

    Componentes

    • Arduino Uno.
    • Un pulsador.
    • Un LED.
    • Una resistencia para el LED.

    Conexiones

    ElementoConexión
    Una patilla del pulsadorPin 2
    Patilla opuesta del pulsadorGND
    Pin 8Resistencia y ánodo del LED
    Cátodo del LEDGND

    Se utilizará la resistencia interna de Arduino mediante INPUT_PULLUP. Por ello, el pulsador tendrá lógica invertida:

    • Sin pulsar: HIGH.
    • Pulsado: LOW.

    Esquema visual

    flowchart LR
        D2["Arduino D2 · INPUT_PULLUP"] --> B["Pulsador"] --> G1["GND"]
        D8["Arduino D8 · OUTPUT"] --> R["Resistencia 220–330 Ω"]
        R --> A["Ánodo + del LED"] --> L["LED"] --> C["Cátodo −"] --> G2["GND"]

    El pulsador se conecta entre D2 y GND. No necesita una resistencia externa porque el programa activa la resistencia interna con INPUT_PULLUP.

    Código resuelto

    const int PULSADOR = 2;
    const int LED = 8;
    
    void setup() {
      pinMode(PULSADOR, INPUT_PULLUP);
      pinMode(LED, OUTPUT);
    
      Serial.begin(9600);
      Serial.println("Sistema preparado");
    }
    
    void loop() {
      int estadoPulsador = digitalRead(PULSADOR);
    
      if (estadoPulsador == LOW) {
        digitalWrite(LED, HIGH);
        Serial.println("Pulsador presionado - LED encendido");
      } else {
        digitalWrite(LED, LOW);
        Serial.println("Pulsador libre - LED apagado");
      }
    
      delay(200);
    }

    Explicación

    • INPUT_PULLUP configura el pin como entrada y activa una resistencia interna.
    • digitalRead() lee el estado del pin.
    • La estructura if permite tomar una decisión.
    • Cuando se pulsa, el estado leído es LOW y el LED se enciende.

    Modificación obligatoria

    Modifica únicamente los textos para que el monitor serie muestre:

    • ALARMA ACTIVADA al pulsar.
    • Sistema en espera al soltar.

    Después cambia el LED del pin 8 al pin 6, tanto en el circuito como en el programa.

    Preguntas

    1. ¿Qué valor devuelve el pulsador cuando está presionado?
    2. ¿Por qué en este montaje se considera pulsado cuando devuelve LOW?
    3. ¿Qué estructura del código permite decidir si el LED se enciende?

    Parte II. Implementación final en Arduino real

    Reto final: semáforo físico con diagnóstico serie

    En esta parte trasladarás el ejercicio 4 a un Arduino real. Es el único ejercicio del proyecto que debe implementarse físicamente.

    Esquema de referencia para el montaje físico

       
    flowchart LR
        D10["D10"] --> R1["220–330 Ω"] --> RO["LED rojo"] --> G["Línea GND de la protoboard"]
        D9["D9"] --> R2["220–330 Ω"] --> AM["LED amarillo"] --> G
        D8["D8"] --> R3["220–330 Ω"] --> VE["LED verde"] --> G
        G --> AG["Arduino GND"]
        AU["Arduino Uno"] -.->|"USB"| PC["Arduino IDE y monitor serie"]

    Antes de conectar el USB, comprueba que la pata larga de cada LED queda orientada hacia su resistencia y la pata corta hacia GND.

    Trabajo que debes realizar

    1. Recupera tu proyecto del semáforo en Wokwi.
    2. Comprueba que la simulación funciona correctamente.
    3. Reúne los componentes necesarios.
    4. Desconecta la placa del USB mientras realizas el montaje.
    5. Conecta los tres LED, cada uno con su propia resistencia.
    6. Revisa la polaridad de los LED.
    7. Solicita al profesor la revisión del circuito antes de alimentarlo.
    8. Conecta Arduino al ordenador.
    9. Abre el código con la herramienta indicada por el profesor.
    10. Selecciona la placa y el puerto correspondientes.
    11. Carga el programa.
    12. Abre el monitor serie a 9600 baudios.
    13. Comprueba que los LED y los mensajes siguen la misma secuencia.

    Requisitos mínimos

    • Los tres LED deben funcionar.
    • Nunca deben encenderse los tres a la vez.
    • Cada LED debe utilizar una resistencia.
    • El monitor serie debe indicar el estado actual.
    • El montaje físico debe corresponder con los pines declarados en el código.

    Pequeña adaptación obligatoria

    En el Arduino real, cambia la secuencia para que:

    • Rojo: 5 segundos.
    • Verde: 4 segundos.
    • Amarillo: 2 segundos.

    El monitor serie deberá mostrar también la duración de cada estado, por ejemplo:

    ROJO: detenerse durante 5 segundos
    VERDE: avanzar durante 4 segundos
    AMARILLO: precaucion durante 2 segundos

    Evidencias necesarias

    • Fotografía general del montaje real.
    • Fotografía donde puedan reconocerse los pines utilizados.
    • Captura del monitor serie.
    • Código final.
    • Explicación de las diferencias encontradas entre Wokwi y el montaje físico.
    • Breve descripción de cualquier error y de cómo se solucionó.

    Seguridad y buenas prácticas

    • No cambies conexiones con la placa alimentada.
    • No conectes un LED directamente sin resistencia.
    • Comprueba la polaridad antes de encender.
    • No fuerces los conectores.
    • Si el circuito se calienta o se comporta de forma extraña, desconecta el USB y avisa al profesor.

    Parte III. Documentación y entrega

    Formato de entrega

    La documentación se entregará en un archivo llamado:

    README.md

    Se redactará en Markdown con el editor utilizado en clase. Además del archivo, se entregará una carpeta img que contenga las capturas y fotografías.

    La estructura recomendada es:

    proyecto-arduino/
    ├── README.md
    └── img/
        ├── ejercicio1-monitor-serie.png
        ├── ejercicio2-led-integrado.png
        ├── ejercicio3-led-externo.png
        ├── ejercicio4-semaforo.png
        ├── ejercicio5-pulsador.png
        └── semaforo-real.jpg

    Estructura obligatoria del README

    # Proyecto de iniciación a Arduino
    
    ## Datos del alumno
    
    - Nombre:
    - Grupo:
    - Fecha:
    
    ## Introducción
    
    Explicación breve del objetivo del proyecto.
    
    ## Ejercicio 1. Monitor serie
    
    ### Montaje y funcionamiento
    
    Explicación personal.
    
    ### Código
    
    ```cpp
    // Código utilizado
    ```
    
    ### Resultado
    
    ![Monitor serie](img/ejercicio1-monitor-serie.png)
    
    ### Modificación realizada
    
    Explicación y resultado.
    
    ### Respuestas
    
    Respuestas a las preguntas del ejercicio.
    
    ## Ejercicio 2. LED integrado
    
    Repetir la misma organización.
    
    ## Ejercicio 3. LED externo
    
    Repetir la misma organización.
    
    ## Ejercicio 4. Semáforo
    
    Repetir la misma organización.
    
    ## Ejercicio 5. Pulsador
    
    Repetir la misma organización.
    
    ## Implementación en Arduino real
    
    Descripción, código, fotografías y problemas encontrados.
    
    ## Conclusiones
    
    Qué has aprendido y qué parte te ha resultado más difícil.
    
    ## Enlaces a los proyectos de Wokwi
    
    - Ejercicio 1:
    - Ejercicio 2:
    - Ejercicio 3:
    - Ejercicio 4:
    - Ejercicio 5:

    Para evitar problemas al incluir bloques de código dentro del README, utiliza tres acentos graves antes y después del código y escribe cpp junto a los tres primeros.

    Requisitos de la documentación

    El README.md debe contener:

    • Portada o título.
    • Datos del alumno.
    • Índice.
    • Explicación de cada ejercicio con palabras propias.
    • Código correctamente presentado en bloques cpp.
    • Una captura de cada simulación.
    • Capturas del monitor serie.
    • Enlaces a los proyectos de Wokwi.
    • Respuestas a todas las preguntas.
    • Evidencias del montaje real.
    • Problemas encontrados y soluciones aplicadas.
    • Conclusión personal.

    Penalizaciones

    • No entregar enlaces funcionales de Wokwi.
    • No incluir las capturas solicitadas.
    • Presentar código sin explicar su funcionamiento.
    • Copiar explicaciones de otras personas o generadas automáticamente sin revisarlas.
    • Conectar físicamente LED sin resistencia.
    • Entregar un documento distinto de README.md sin autorización.

    6. Lista de comprobación antes de entregar

    • He completado los cinco ejercicios de Wokwi.
    • He realizado todas las modificaciones obligatorias.
    • He probado el monitor serie.
    • He respondido las preguntas con mis palabras.
    • Los enlaces de Wokwi se pueden abrir.
    • He construido y probado el semáforo real.
    • He incluido el código en bloques Markdown.
    • Las imágenes se encuentran dentro de la carpeta img.
    • Todas las imágenes aparecen correctamente en el README.md.
    • He escrito una conclusión personal.
    • El archivo principal se llama exactamente README.md.

    7. Ampliación voluntaria

    Si terminas antes, modifica el semáforo de Wokwi para que el LED amarillo parpadee tres veces antes de encenderse el rojo. El monitor serie deberá informar de cada parpadeo.

    Documenta la ampliación indicando qué instrucciones has añadido y por qué.

  • OSINT: Operación Atlas

    OSINT: Operación Atlas

    Reconocimiento pasivo de dominios desde terminal

    Documentación de apoyo: Reconocimiento de dominios por terminal y scripting


    1. Introducción

    Una organización ficticia llamada Atlas Digital está revisando la información que su infraestructura publica en Internet. Durante los últimos años ha creado páginas web, aplicaciones, servicios de correo y entornos de pruebas, pero no dispone de un inventario actualizado.

    El equipo de seguridad necesita conocer su superficie externa visible mediante fuentes públicas antes de realizar una auditoría más profunda.

    Tu misión será actuar como analista OSINT. Utilizarás la terminal de Linux para descubrir subdominios, resolver direcciones IP, consultar información pública sobre esas direcciones y automatizar parte del proceso mediante un script en Bash.

    El objetivo no consiste únicamente en ejecutar comandos. Tendrás que interpretar, relacionar y documentar los resultados.


    2. Objetivos de aprendizaje

    Al finalizar el reto deberás ser capaz de:

    • Explicar qué es el reconocimiento OSINT pasivo.
    • Utilizar herramientas desde una terminal Linux.
    • Enumerar subdominios con Amass y Subfinder.
    • guardar, ordenar, combinar y filtrar resultados.
    • Resolver nombres de dominio y obtener sus direcciones IP.
    • Consultar información WHOIS y datos aproximados de geolocalización.
    • Procesar respuestas JSON con curl y jq.
    • Crear un script Bash sencillo para automatizar el análisis.
    • Diferenciar entre un dato, una evidencia y una conclusión.
    • Elaborar un informe técnico reproducible.

    3. Normas y alcance autorizado

    Esta actividad es exclusivamente de reconocimiento pasivo.

    Está permitido

    • Consultar fuentes públicas.
    • Utilizar Amass en modo -passive.
    • Utilizar Subfinder con sus fuentes OSINT.
    • Resolver registros DNS.
    • Consultar WHOIS y servicios públicos de información de IP.
    • Trabajar únicamente con el dominio indicado por el profesor.

    No está permitido

    • Escanear puertos con Nmap u otras herramientas.
    • Buscar vulnerabilidades o ejecutar exploits.
    • Realizar fuerza bruta de subdominios, directorios o credenciales.
    • Acceder a paneles, cuentas o zonas privadas.
    • Enviar tráfico masivo o intentar evadir límites.
    • Investigar dominios distintos de los autorizados.

    Encontrar un servicio visible no autoriza a entrar en él. Si descubres algo que parezca sensible, registra únicamente el nombre y comunícalo al profesor.


    4. Material necesario

    • Ubuntu, Debian, Kali Linux o una máquina virtual Linux.
    • Conexión a Internet.
    • Un dominio autorizado por el profesor.
    • Terminal y editor de texto.
    • Herramientas: amass, subfinder, dnsutils, whois, curl, jq y, opcionalmente, geoip-bin.

    El profesor proporcionará el objetivo:

    DOMINIO_AUTORIZADO=____________________________

    No sustituyas esta variable por el dominio de una empresa elegida al azar.


    5. Preparación del entorno

    Paso 1. Crear la estructura de trabajo

    mkdir -p operacion-atlas/{capturas,resultados,script}
    cd operacion-atlas

    Comprueba la estructura:

    find . -maxdepth 2 -type d

    Paso 2. Instalar las herramientas

    En una distribución basada en Ubuntu o Debian:

    sudo apt update
    sudo apt install amass dnsutils whois curl jq geoip-bin

    Si Subfinder no está disponible en los repositorios de tu distribución, sigue la opción de instalación explicada en la documentación del curso. Por ejemplo, si tienes Snap:

    sudo snap install subfinder

    Paso 3. Comprobar la instalación

    amass version
    subfinder -version
    host -V
    whois --version
    curl --version
    jq --version

    Evidencia 1: incluye una captura o salida de terminal que demuestre que las herramientas están disponibles. Si alguna no se puede instalar, explica el problema y continúa con las que funcionen.


    6. Fase 1: reconocimiento inicial

    Antes de ejecutar herramientas, completa una pequeña ficha:

    CampoRespuesta
    Dominio autorizado
    Fecha y hora de inicio
    Sistema operativo
    Hipótesis inicial
    ¿Qué información esperas encontrar?

    Formula al menos dos hipótesis. Por ejemplo:

    • El dominio puede utilizar varios subdominios para separar servicios.
    • Parte de la infraestructura puede estar alojada en un proveedor cloud.

    No importa si después resultan incorrectas: deberán contrastarse con evidencias.


    7. Fase 2: enumeración pasiva con Amass

    Paso 1. Ejecutar Amass en modo pasivo

    Sustituye dominio-autorizado.example por el objetivo indicado por el profesor:

    amass enum -passive -d dominio-autorizado.example \
      -o resultados/amass.txt

    El parámetro -passive es obligatorio en este reto.

    Paso 2. Revisar los resultados

    cat resultados/amass.txt

    Cuenta los resultados:

    wc -l resultados/amass.txt

    Ordénalos y elimina duplicados:

    sort -u resultados/amass.txt -o resultados/amass_limpio.txt

    Paso 3. Interpretar

    Responde:

    1. ¿Cuántos subdominios distintos encontró Amass?
    2. ¿Qué nombres parecen corresponder a servicios web, correo, API, desarrollo o administración?
    3. ¿Un nombre como dev, test o staging demuestra que existe un entorno vulnerable? Justifica la respuesta.
    4. ¿Por qué el resultado de una fuente OSINT puede estar desactualizado?

    Evidencia 2: incluye el comando, el número de resultados y una selección razonada de hasta diez subdominios. No llenes el informe con capturas repetitivas.


    8. Fase 3: enumeración con Subfinder

    Paso 1. Ejecutar la segunda herramienta

    subfinder -d dominio-autorizado.example \
      -o resultados/subfinder.txt

    Paso 2. Limpiar la salida

    sort -u resultados/subfinder.txt -o resultados/subfinder_limpio.txt

    Paso 3. Comparar las herramientas

    Subdominios encontrados por ambas:

    comm -12 resultados/amass_limpio.txt resultados/subfinder_limpio.txt \
      > resultados/coincidencias.txt

    Encontrados solamente por Amass:

    comm -23 resultados/amass_limpio.txt resultados/subfinder_limpio.txt \
      > resultados/solo_amass.txt

    Encontrados solamente por Subfinder:

    comm -13 resultados/amass_limpio.txt resultados/subfinder_limpio.txt \
      > resultados/solo_subfinder.txt

    Combina todos los resultados:

    sort -u resultados/amass_limpio.txt resultados/subfinder_limpio.txt \
      > resultados/subdominios_finales.txt

    Obtén los recuentos:

    wc -l resultados/amass_limpio.txt \
          resultados/subfinder_limpio.txt \
          resultados/coincidencias.txt \
          resultados/subdominios_finales.txt

    Completa la tabla:

    ResultadoCantidad
    Amass
    Subfinder
    Coincidencias
    Total único

    Preguntas:

    1. ¿Qué herramienta ha encontrado más resultados?
    2. ¿Por qué dos herramientas OSINT pueden devolver resultados diferentes?
    3. ¿Por qué una coincidencia entre ambas fuentes aumenta la confianza, pero no confirma por sí sola que el servicio esté activo?

    Evidencia 3: tabla comparativa y explicación de las diferencias.


    9. Fase 4: resolución DNS

    Ahora comprobarás qué nombres de la lista pueden resolverse actualmente.

    Paso 1. Probar manualmente un subdominio

    host subdominio.dominio-autorizado.example

    También puedes consultar registros concretos:

    dig +short A subdominio.dominio-autorizado.example
    dig +short AAAA subdominio.dominio-autorizado.example
    dig +short CNAME subdominio.dominio-autorizado.example

    Paso 2. Automatizar la resolución de la lista

    while IFS= read -r subdominio; do
      echo "### $subdominio"
      host "$subdominio"
    done < resultados/subdominios_finales.txt \
      | tee resultados/resolucion_dns.txt

    Paso 3. Crear una lista única de IPv4

    while IFS= read -r subdominio; do
      dig +short A "$subdominio"
    done < resultados/subdominios_finales.txt \
      | grep -E '^[0-9]+(\.[0-9]+){3}$' \
      | sort -u \
      > resultados/ips.txt

    Revisa el resultado:

    cat resultados/ips.txt
    wc -l resultados/ips.txt

    Paso 4. Analizar

    Responde:

    1. ¿Todos los nombres encontrados mediante OSINT resuelven actualmente?
    2. ¿Hay varios subdominios que apunten a la misma IP?
    3. ¿Has encontrado registros CNAME?
    4. ¿Qué puede significar que varios servicios compartan dirección IP?
    5. ¿Qué diferencia existe entre no resolver un nombre y demostrar que nunca existió?

    Evidencia 4: presenta una tabla con una muestra de entre cinco y diez resultados.

    SubdominioTipo de registroIP o destino¿Resuelve?Observación

    10. Fase 5: contexto de las direcciones IP

    Selecciona un máximo de cinco IP públicas distintas. No es necesario consultar todas si la lista es muy grande.

    Paso 1. Consulta WHOIS

    whois DIRECCION_IP

    Busca datos como:

    • Organización o propietario del rango.
    • ASN, si aparece.
    • País de registro.
    • Rango o bloque de red.
    • Contactos de abuso, sin utilizarlos ni recopilar datos innecesarios.

    El país registrado en WHOIS no tiene por qué coincidir con la ubicación física exacta del servidor.

    Paso 2. Consulta GeoIP local

    geoiplookup DIRECCION_IP

    Paso 3. Consulta una API desde terminal

    curl -s "https://ipinfo.io/DIRECCION_IP/json" | jq

    Extrae solamente algunos campos:

    curl -s "https://ipinfo.io/DIRECCION_IP/json" \
      | jq '{ip, city, region, country, org, loc}'

    Respeta los límites del servicio: una consulta por cada IP seleccionada es suficiente.

    Paso 4. Correlacionar

    Completa la tabla:

    IPSubdominios asociadosOrganización/ASNPaís aproximadoPosible proveedorConfianza
    Alta/Media/Baja

    Responde:

    1. ¿Parece infraestructura propia, alojamiento compartido, CDN o proveedor cloud?
    2. ¿Coinciden WHOIS, GeoIP y la API?
    3. ¿Qué campos son hechos observados y cuáles son inferencias?
    4. ¿Por qué no debemos presentar una geolocalización de IP como una ubicación exacta?

    Evidencia 5: tabla completada y una conclusión prudente sobre la infraestructura.


    11. Fase 6: construir el script atlas.sh

    Debes crear un script que automatice el proceso básico.

    Requisitos mínimos

    El script deberá:

    1. Recibir un dominio como argumento.
    2. Comprobar que se ha indicado dicho argumento.
    3. Crear un directorio de resultados.
    4. Ejecutar Amass en modo pasivo.
    5. Ejecutar Subfinder.
    6. Combinar y eliminar duplicados.
    7. Resolver las direcciones IPv4.
    8. Guardar los resultados en archivos.
    9. Mostrar un resumen final.

    Plantilla orientativa

    Guárdala como script/atlas.sh y completa las partes marcadas:

    #!/usr/bin/env bash
    
    set -u
    
    if [ "$#" -ne 1 ]; then
      echo "Uso: $0 dominio-autorizado.example"
      exit 1
    fi
    
    DOMINIO="$1"
    FECHA="$(date +%Y%m%d_%H%M%S)"
    SALIDA="resultados_${DOMINIO}_${FECHA}"
    
    mkdir -p "$SALIDA"
    
    echo "[+] Iniciando reconocimiento pasivo de: $DOMINIO"
    
    # 1. Comprobar que las herramientas necesarias existen.
    # PISTA: command -v nombre_herramienta
    
    # 2. Ejecutar Amass exclusivamente en modo pasivo.
    
    # 3. Ejecutar Subfinder.
    
    # 4. Ordenar, combinar y eliminar duplicados.
    
    # 5. Resolver las direcciones IPv4 con dig.
    
    # 6. Mostrar el número de subdominios e IP únicas.
    
    echo "[+] Proceso finalizado. Resultados guardados en: $SALIDA"

    Da permiso de ejecución:

    chmod +x script/atlas.sh

    Ejecútalo únicamente con el dominio autorizado:

    ./script/atlas.sh dominio-autorizado.example

    Validaciones que debe incorporar

    Como mínimo, comprueba la presencia de cada herramienta:

    if ! command -v amass >/dev/null 2>&1; then
      echo "Error: Amass no está instalado."
      exit 1
    fi

    Repite o adapta la validación para las demás herramientas.

    Pruebas obligatorias

    Documenta qué ocurre cuando:

    • Se ejecuta sin argumentos.
    • Se ejecuta con el dominio autorizado.
    • Falta una herramienta necesaria.
    • Una de las herramientas no devuelve resultados.

    Evidencia 6: código completo del script, capturas o salidas de las pruebas y explicación de su funcionamiento.


    12. Fase 7: análisis final

    Redacta una conclusión que responda a estas preguntas:

    1. ¿Cuál es la superficie externa observada?
    2. ¿Cuántos subdominios únicos se han identificado?
    3. ¿Cuántos resolvían en el momento del análisis?
    4. ¿Qué proveedores o redes parecen alojarlos?
    5. ¿Existen indicios de servicios de desarrollo, pruebas, API o correo?
    6. ¿Qué resultados tienen una confianza alta, media o baja?
    7. ¿Qué limitaciones ha tenido la investigación?
    8. ¿Se confirmaron las hipótesis iniciales?
    9. ¿Qué recomendarías revisar al responsable del dominio?

    Las recomendaciones deben ser defensivas. Por ejemplo:

    • Mantener un inventario de subdominios.
    • Eliminar registros DNS abandonados.
    • Revisar nombres que revelen información innecesaria.
    • Comprobar que los entornos de prueba no estén publicados accidentalmente.
    • Repetir periódicamente el inventario pasivo.

    No afirmes que existe una vulnerabilidad si no dispones de evidencia suficiente.


    13. Entrega

    Entrega un archivo ZIP con esta estructura:

    operacion-atlas/
    ├── README.md
    ├── capturas/
    │   ├── 01_herramientas.png
    │   ├── 02_amass.png
    │   ├── 03_subfinder.png
    │   └── ...
    ├── resultados/
    │   ├── amass.txt
    │   ├── subfinder.txt
    │   ├── coincidencias.txt
    │   ├── subdominios_finales.txt
    │   ├── resolucion_dns.txt
    │   └── ips.txt
    └── script/
        └── atlas.sh

    El archivo README.md será el informe principal y deberá contener:

    1. Portada e identificación del alumno o equipo.
    2. Objetivo y alcance autorizado.
    3. Entorno y herramientas.
    4. Hipótesis iniciales.
    5. Procedimiento reproducible.
    6. Evidencias seleccionadas.
    7. Tablas de resultados.
    8. Explicación del script.
    9. Conclusiones y recomendaciones.
    10. Limitaciones y fuentes consultadas.

    No se valorará mejor un informe por tener más capturas. Se valorará que cada evidencia sea legible, necesaria y esté interpretada.


    14. Rúbrica de evaluación

    CriterioPuntuación
    Preparación, alcance ético y organización1 punto
    Enumeración pasiva con Amass y Subfinder2 puntos
    Limpieza, comparación y combinación de resultados1,5 puntos
    Resolución DNS y análisis de IP1,5 puntos
    Script Bash, validaciones y pruebas2 puntos
    Interpretación, correlación y conclusiones1,5 puntos
    Calidad del README y evidencias0,5 puntos
    Total10 puntos

    Penalizaciones importantes

    • Uso de técnicas activas no autorizadas: la práctica podrá considerarse no superada.
    • Investigación de dominios fuera del alcance: la práctica podrá considerarse no superada.
    • Script que no se explica o no se prueba: no se considerará completamente válido.
    • Capturas sin interpretación: tendrán poco valor como evidencia.
    • Resultados o conclusiones inventados: penalización grave.

    15. Nivel avanzado opcional: inteligencia reproducible

    Quienes terminen antes pueden incorporar estas mejoras:

    Mejora A. Archivo CSV

    Genera un archivo con el formato:

    subdominio,ip
    www.dominio.example,203.0.113.10
    api.dominio.example,203.0.113.20

    Mejora B. Parámetros adicionales

    Permite utilizar:

    ./script/atlas.sh -d dominio-autorizado.example -o informe

    Mejora C. Registro de ejecución

    Guarda fecha, herramienta, versión y comando ejecutado en un archivo log.txt.

    Mejora D. Manejo de errores

    Haz que el script continúe de forma controlada si Amass o Subfinder falla, indicando qué fuente no estuvo disponible.

    Mejora E. Comparación temporal

    Ejecuta el análisis en dos momentos autorizados distintos y compara las listas:

    comm -13 resultado_anterior.txt resultado_actual.txt

    Explica qué nombres son nuevos, cuáles han desaparecido y por qué eso no basta para asegurar que se haya producido un cambio real en la infraestructura.


    16. Pregunta de cierre

    Si todas las herramientas utilizadas consultan fuentes públicas, ¿por qué sigue siendo necesario definir un alcance, aplicar límites y tratar los resultados con responsabilidad?

  • Auditoría pasiva con Google Dorks

    Auditoría pasiva con Google Dorks

    Situación

    La empresa ficticia Nébula Systems está preparando una revisión de seguridad. La dirección sospecha que algunos documentos, formularios, directorios o páginas antiguas pueden estar apareciendo en buscadores sin que el equipo técnico sea consciente de ello.

    Vuestro equipo ha sido contratado para realizar una auditoría OSINT pasiva. No debéis atacar servidores, probar contraseñas ni explotar vulnerabilidades. Vuestra misión consiste en utilizar operadores avanzados de búsqueda para descubrir qué información pública puede localizar un usuario externo y proponer cómo reducir esa exposición.

    El trabajo se basa en la documentación Google Hacking de La Aventura de Aprender:


    Objetivos de aprendizaje

    Al finalizar el reto deberéis ser capaces de:

    • Explicar qué son Google Hacking y Google Dorks.
    • Utilizar operadores avanzados de búsqueda de forma combinada.
    • Diferenciar un hallazgo real, un falso positivo y un resultado irrelevante.
    • Evaluar el riesgo de la información indexada.
    • Registrar evidencias sin recopilar datos personales ni información sensible.
    • Proponer medidas de mitigación adecuadas.
    • Elaborar un informe técnico reproducible en Markdown.

    Normas de seguridad y uso ético

    Este reto solo puede realizarse sobre uno de estos objetivos:

    1. Un dominio de laboratorio proporcionado por el profesor.
    2. Un dominio propio del centro o del alumno para el que exista autorización.
    3. Dominios de demostración indicados expresamente por el profesor.

    Está permitido

    • Realizar búsquedas en Google, Bing o DuckDuckGo.
    • Analizar únicamente la información que aparece en los resultados del buscador.
    • Visitar páginas públicas ordinarias cuando el profesor lo haya autorizado.
    • Registrar URL, título, descripción y tipo de información encontrada.
    • Consultar GHDB para aprender a construir consultas.

    Está prohibido

    • Buscar deliberadamente contraseñas, claves privadas, tokens, datos médicos o datos personales reales.
    • Descargar bases de datos, copias de seguridad, archivos de configuración o documentos sensibles.
    • Acceder a paneles de administración o intentar iniciar sesión.
    • Realizar escaneos, fuerza bruta, explotación de vulnerabilidades o evasión de controles.
    • Automatizar búsquedas masivas.
    • Compartir públicamente una exposición real.

    Si aparece accidentalmente información sensible, no la abráis, no la descarguéis y no la copiéis. Detened la investigación, anotad de forma genérica que se ha localizado un posible hallazgo y avisad al profesor.


    Organización

    • Modalidad: individual o parejas.
    • Duración recomendada: 2 sesiones de 90 minutos.
    • Producto final: un repositorio o archivo ZIP con un README.md y una carpeta img.
    • Nombre recomendado: reto-google-dorks-apellido1-apellido2.

    Desarrollo paso a paso

    Fase 0. Preparación del entorno

    1. Cread una carpeta con la siguiente estructura:
    reto-google-dorks/
    ├── README.md
    └── img/
    1. En el README.md, añadid:
    • Título del reto.
    • Nombre de los integrantes.
    • Fecha.
    • Dominio autorizado asignado.
    • Buscador utilizado.
    • Declaración ética: “La investigación se ha realizado mediante técnicas pasivas y sobre un objetivo autorizado”.
    1. Leed la documentación de referencia antes de realizar búsquedas.

    Evidencia requerida: captura de la estructura del proyecto o bloque de código que la represente.


    Fase 1. Comprender los operadores

    Explicad con vuestras propias palabras para qué sirven los siguientes operadores:

    Operador¿Qué debéis explicar?
    site:Cómo limita la búsqueda a un dominio
    filetype:Cómo filtra por tipo de documento
    inurl:Cómo busca términos dentro de la URL
    intitle:Cómo busca términos en el título
    intext:Cómo busca texto dentro de una página
    "frase exacta"Qué cambia al utilizar comillas
    -terminoCómo se excluyen resultados
    ORCómo se ofrecen alternativas

    Después, cread un ejemplo seguro y genérico de cada uno empleando example.com o el dominio autorizado.

    No copiéis únicamente las definiciones de la documentación. Debéis explicar qué utilidad tendría cada operador durante una auditoría.

    Evidencia requerida: tabla de operadores, explicación y ejemplo.


    Fase 2. Reconocimiento inicial del dominio

    Sustituid DOMINIO-AUTORIZADO por el objetivo asignado.

    1. Ejecutad una búsqueda general:
    site:DOMINIO-AUTORIZADO
    1. Observad las primeras páginas de resultados y anotad:
    • Número aproximado de resultados indicado por el buscador.
    • Tipos de páginas que aparecen.
    • Secciones o subdominios visibles.
    • Resultados antiguos, duplicados o inesperados.
    1. Repetid la consulta añadiendo al menos dos palabras relevantes para la organización, por ejemplo:
    site:DOMINIO-AUTORIZADO contacto
    site:DOMINIO-AUTORIZADO formación
    1. Comparad los resultados y explicad qué información básica podría obtener un tercero.

    El número de resultados del buscador es aproximado y puede variar. No debe tratarse como una medición exacta.

    Evidencia requerida: consultas empleadas, fecha, resumen de resultados y una captura sin datos personales.


    Fase 3. Localización de documentos públicos

    Buscad documentos que la organización publique de forma legítima. Realizad al menos cuatro consultas usando tipos diferentes:

    site:DOMINIO-AUTORIZADO filetype:pdf
    site:DOMINIO-AUTORIZADO filetype:docx
    site:DOMINIO-AUTORIZADO filetype:xlsx
    site:DOMINIO-AUTORIZADO filetype:pptx

    Si una extensión no ofrece resultados, registrad igualmente la consulta. Un resultado negativo también es una evidencia válida.

    Para cada consulta, indicad:

    • Qué pretendíais encontrar.
    • Qué habéis encontrado.
    • Si el resultado parece intencionadamente público.
    • Qué información revela el título o el fragmento mostrado por Google.
    • Riesgo inicial: informativo, bajo, medio o alto.

    No descarguéis documentos que parezcan internos, confidenciales o que contengan datos personales.

    Evidencia requerida: tabla comparativa de al menos cuatro búsquedas.


    Fase 4. Identificación de rutas y servicios visibles

    Realizad búsquedas orientadas a reconocer la estructura pública del sitio:

    site:DOMINIO-AUTORIZADO inurl:login
    site:DOMINIO-AUTORIZADO inurl:admin
    site:DOMINIO-AUTORIZADO inurl:portal
    site:DOMINIO-AUTORIZADO inurl:uploads
    site:DOMINIO-AUTORIZADO inurl:documentos

    Podéis adaptar las palabras al contexto del objetivo. No accedáis a paneles ni intentéis autenticaros.

    Responded:

    1. ¿La existencia pública de una página de inicio de sesión es por sí sola una vulnerabilidad?
    2. ¿Qué información puede revelar la estructura de una URL?
    3. ¿Qué resultados son normales y cuáles deberían revisarse?
    4. ¿Habéis detectado falsos positivos?

    Evidencia requerida: mínimo tres consultas comentadas y clasificación de sus resultados.


    Fase 5. Consultas combinadas

    Ahora debéis construir búsquedas más precisas combinando operadores. Cread y probad al menos cinco consultas propias.

    Ejemplos seguros:

    site:DOMINIO-AUTORIZADO filetype:pdf "manual"
    site:DOMINIO-AUTORIZADO (filetype:pdf OR filetype:docx) "curso"
    site:DOMINIO-AUTORIZADO inurl:uploads filetype:pdf
    site:DOMINIO-AUTORIZADO intitle:"contacto"
    site:DOMINIO-AUTORIZADO filetype:pdf -inurl:blog

    Cada consulta deberá incluir:

    • Hipótesis: qué creéis que puede localizar.
    • Dork utilizado.
    • Resultado obtenido.
    • Interpretación.
    • Modificación realizada para mejorar la precisión.

    Al menos una consulta debe usar OR, otra debe excluir un término con - y otra debe combinar tres operadores.

    Evidencia requerida: cinco fichas de consulta completas.


    Fase 6. Investigación en GHDB

    Consultad la Google Hacking Database enlazada en la documentación.

    1. Elegid dos categorías relacionadas con exposición de información.
    2. Seleccionad un ejemplo de consulta de cada categoría.
    3. Explicad qué intenta localizar, sin ejecutarlo sobre organizaciones reales.
    4. Transformadlo en una versión segura para el dominio de laboratorio.
    5. Indicad qué riesgo representaría un resultado positivo.

    No se valorará que el dork sea espectacular, sino que comprendáis su funcionamiento y sepáis adaptarlo de manera responsable.

    Evidencia requerida: dos análisis de dorks de GHDB, con referencia a su categoría y versión adaptada.


    Fase 7. Comparación entre buscadores

    Elegid dos consultas anteriores y repetidlas en otro buscador, como Bing o DuckDuckGo.

    Comparad:

    • Cantidad y relevancia de resultados.
    • Documentos que aparecen en uno y no en otro.
    • Diferencias en títulos y fragmentos.
    • Posibles causas de las diferencias.

    No es necesario que todos los buscadores admitan exactamente los mismos operadores. Si uno no funciona, documentadlo.

    Evidencia requerida: tabla comparativa de dos consultas en dos buscadores.


    Fase 8. Registro y clasificación de hallazgos

    Reunid los resultados relevantes en una tabla como esta:

    IDConsultaHallazgo resumidoEvidenciaProbabilidadImpactoRiesgo¿Falso positivo?
    H-01site:... filetype:pdfDocumento público antiguoURL y capturaMediaBajoBajoNo

    Utilizad esta escala:

    • Informativo: no existe un problema, pero el resultado ayuda a conocer la huella digital.
    • Bajo: información pública poco sensible o desactualizada.
    • Medio: información no prevista que facilita reconocimiento o ingeniería social.
    • Alto: posible exposición de información interna o sensible. No debe abrirse; se comunica al profesor.

    Para cada hallazgo relevante, explicad por qué le asignáis esa valoración. El nivel de riesgo no depende de que el resultado “parezca interesante”, sino de su impacto y probabilidad.

    Evidencia requerida: inventario de hallazgos. Puede haber hallazgos informativos o resultados negativos.


    Fase 9. Plan de mitigación

    Proponed al menos una medida concreta para cada hallazgo que necesite corrección. Podéis considerar:

    • Retirar documentos que ya no deban ser públicos.
    • Mover copias de seguridad fuera del directorio web.
    • Desactivar el listado de directorios.
    • Revisar permisos y reglas del servidor.
    • Proteger áreas privadas mediante autenticación y autorización.
    • Evitar publicar información sensible en nombres de archivo, títulos o metadatos.
    • Solicitar la retirada de resultados obsoletos del buscador.
    • Utilizar noindex cuando proceda.
    • Revisar robots.txt, entendiendo que no es un mecanismo de seguridad.

    Para cada medida indicad:

    • Hallazgo al que responde.
    • Acción propuesta.
    • Responsable recomendado.
    • Prioridad.
    • Cómo comprobaríais posteriormente que la corrección funciona.

    Evidencia requerida: plan de mitigación priorizado.


    Fase 10. Conclusiones

    Responded razonadamente:

    1. ¿Qué diferencia existe entre una búsqueda normal y un Google Dork?
    2. ¿Por qué una página indexada no es automáticamente una vulnerabilidad?
    3. ¿Cuál ha sido la combinación de operadores más útil?
    4. ¿Qué limitaciones tiene este tipo de auditoría?
    5. ¿Qué riesgo puede tener publicar documentos aparentemente inofensivos?
    6. ¿Qué debe hacer un auditor si encuentra información sensible de forma accidental?
    7. ¿Qué cambiaríais en la exposición pública del dominio analizado?

    Misión extra

    Quienes terminen el reto principal pueden realizar esta ampliación:

    1. Diseñad una matriz con tres objetivos: documentos, rutas y contenido textual.
    2. Cread tres consultas diferentes para cada objetivo, sin ejecutar búsquedas agresivas.
    3. Comparad los resultados actuales con una versión histórica pública del sitio mediante Wayback Machine, si el profesor lo autoriza.
    4. Seleccionad un documento público e indicad qué metadatos sería razonable revisar en un laboratorio, sin descargar material sensible.
    5. Diseñad una consulta periódica que la propia organización podría usar para vigilar su exposición.
    6. Proponed un procedimiento responsable de notificación de hallazgos.

    La ampliación debe centrarse en la metodología y la defensa. No se permite utilizar herramientas automáticas de escaneo.


    Estructura obligatoria del README.md

    # Operación Huella Digital
    
    ## 1. Datos del equipo
    ## 2. Objetivo y autorización
    ## 3. Declaración ética
    ## 4. Operadores estudiados
    ## 5. Reconocimiento inicial
    ## 6. Búsqueda de documentos
    ## 7. Rutas y servicios visibles
    ## 8. Consultas combinadas
    ## 9. Investigación en GHDB
    ## 10. Comparación de buscadores
    ## 11. Inventario de hallazgos
    ## 12. Plan de mitigación
    ## 13. Conclusiones
    ## 14. Bibliografía y recursos

    Las capturas deberán guardarse en img/ y enlazarse mediante rutas relativas:

    ![Resultado de una consulta autorizada](img/consulta-01.png)

    Antes de incluir una captura, ocultad nombres, correos, identificadores, cookies, cuentas abiertas y cualquier dato personal.


    Entrega

    La entrega debe contener:

    • README.md completo y bien estructurado.
    • Carpeta img con las evidencias necesarias.
    • Entre 10 y 15 consultas propias documentadas.
    • Al menos cinco consultas combinadas.
    • Comparación de dos buscadores.
    • Inventario de hallazgos.
    • Plan de mitigación.
    • Conclusiones personales.

    Aunque inicialmente se entregue como ZIP, el proyecto deberá estar preparado para subirse posteriormente a un repositorio Git.

    No incluyáis archivos obtenidos durante la investigación. Solo se entregarán el informe y capturas saneadas.


    Rúbrica de evaluación

    CriterioPeso
    Uso correcto y variado de operadores20 %
    Metodología paso a paso y reproducibilidad15 %
    Interpretación de resultados y falsos positivos15 %
    Clasificación razonada de riesgos15 %
    Medidas de mitigación15 %
    Calidad del README.md y de las evidencias10 %
    Ética, privacidad y cumplimiento de las normas10 %

    Penalizaciones

    • Ejecutar pruebas fuera de los objetivos autorizados: actividad no superada.
    • Incluir datos personales o información sensible en la entrega: actividad no superada hasta corregirla.
    • Presentar consultas sin explicar su finalidad y sus resultados: no se consideran realizadas.
    • Copiar definiciones sin interpretación propia: reducción de la puntuación correspondiente.

    Lista de comprobación final

    • He trabajado únicamente sobre un objetivo autorizado.
    • No he intentado iniciar sesión ni explotar ningún sistema.
    • He documentado las consultas aunque no ofrecieran resultados.
    • He diferenciado hallazgos, falsos positivos y resultados irrelevantes.
    • Las capturas no contienen datos personales.
    • No he descargado ni adjuntado información sensible.
    • Cada riesgo incluye una medida de mitigación.
    • El README.md puede entenderse sin explicaciones adicionales.
    • He citado la documentación utilizada.

    Resultado esperado

    El objetivo no es encontrar “secretos”, sino demostrar que sabéis formular preguntas precisas a un buscador, interpretar responsablemente las respuestas y convertir la información pública en recomendaciones defensivas útiles.

    Dominios recomendados para búsquedas inocuas

    En estos dominios limitaría la práctica a operadores como site:, filetype:, intitle:, inurl: y frases entre comillas, buscando exclusivamente información pública.

    DominioTemáticaEjemplos seguros
    boe.esLegislación españolasite:boe.es filetype:pdf ciberseguridad
    ine.esEstadísticas públicassite:ine.es filetype:xlsx población
    datos.gob.esDatos abiertossite:datos.gob.es filetype:csv transporte
    administracion.gob.esAdministración públicasite:administracion.gob.es filetype:pdf empleo
    europa.euUnión Europeasite:europa.eu filetype:pdf cybersecurity
    data.europa.euDatos abiertos europeossite:data.europa.eu \"open data\"
    who.intSalud pública internacionalsite:who.int filetype:pdf cybersecurity
    un.orgNaciones Unidassite:un.org filetype:pdf \"artificial intelligence\"
    nasa.govCiencia y espaciosite:nasa.gov filetype:pdf mars
    noaa.govMeteorología y océanossite:noaa.gov filetype:pdf climate
    mit.eduUniversidad e investigaciónsite:mit.edu filetype:pdf \"computer security\"
    stanford.eduInvestigación académicasite:stanford.edu filetype:pptx cybersecurity
    docs.python.orgDocumentación técnicasite:docs.python.org intitle:\"Python\" tutorial
    developer.mozilla.orgDesarrollo website:developer.mozilla.org \"HTTP authentication\"
    wikipedia.orgContenido enciclopédicosite:wikipedia.org intitle:OSINT
    archive.orgArchivo históricosite:archive.org filetype:pdf networking
  • OSINT – Investigación digital a partir de una fotografía

    OSINT – Investigación digital a partir de una fotografía

    Investigación digital a partir de una fotografía

    1. Introducción

    Una fotografía puede contener mucha más información de la que se aprecia a simple vista. Además de la propia imagen, el archivo puede guardar metadatos técnicos, fechas, coordenadas, información del dispositivo utilizado y otros datos.

    En esta práctica asumirás el papel de un analista OSINT (Open Source Intelligence). Tu misión será investigar una fotografía y obtener toda la información posible empleando únicamente fuentes abiertas, herramientas gratuitas y técnicas legales.

    No todas las fotografías contienen las mismas pistas. Por tanto, no es obligatorio completar con éxito todos los apartados. También se valorará que expliques correctamente:

    • Qué técnica has utilizado.
    • Qué resultado has obtenido.
    • Qué limitaciones has encontrado.
    • Qué información no has podido verificar.
    • Por qué consideras fiable o no una conclusión.

    2. Objetivos

    Al finalizar la práctica deberás ser capaz de:

    • Examinar técnicamente un archivo de imagen.
    • Extraer e interpretar sus metadatos.
    • Realizar búsquedas inversas de imágenes.
    • Analizar visualmente lugares, objetos, textos y personas sin identificarlas de forma invasiva.
    • Aplicar técnicas básicas de geolocalización.
    • Buscar información relacionada en fuentes abiertas.
    • Contrastar información utilizando varias fuentes.
    • Diferenciar entre evidencia, indicio, hipótesis y conclusión.
    • Documentar de forma ordenada una investigación OSINT.
    • Comprender los riesgos de privacidad asociados a las fotografías.

    3. Normas de la investigación

    La práctica se realizará únicamente con:

    • Fotografías proporcionadas por el profesor.
    • Fotografías propias.
    • Imágenes publicadas con una licencia adecuada.
    • Imágenes de lugares públicos o utilizadas expresamente con fines educativos.

    No está permitido:

    • Investigar a compañeros, profesores o particulares sin su consentimiento.
    • Intentar acceder a cuentas privadas.
    • Contactar con personas que aparezcan en la fotografía.
    • Publicar datos personales obtenidos durante la investigación.
    • Utilizar reconocimiento facial para identificar personas reales.
    • Acosar, seguir o localizar el domicilio de una persona.
    • Modificar o destruir el archivo original.
    • Presentar como segura una información que solamente es una suposición.

    4. Preparación del archivo

    Antes de empezar, crea una carpeta con la siguiente estructura:

    investigacion-osint/
    ├── imagen-original/
    ├── copias-trabajo/
    ├── capturas/
    ├── evidencias/
    └── README.md

    Guarda la fotografía original sin modificar dentro de imagen-original.

    Realiza todas las pruebas sobre una copia situada en copias-trabajo.

    Registro inicial

    Anota:

    • Nombre del archivo.
    • Formato.
    • Tamaño en bytes.
    • Dimensiones en píxeles.
    • Fecha y hora en la que recibiste el archivo.
    • Procedencia conocida de la fotografía.
    • Herramienta utilizada para obtener cada dato.

    Integridad del archivo

    Calcula al menos el hash SHA-256 de la fotografía.

    Ejemplo con Linux:

    sha256sum fotografia.jpg

    Ejemplo con PowerShell:

    Get-FileHash fotografia.jpg -Algorithm SHA256

    Explica para qué sirve un hash y por qué resulta útil conservarlo durante una investigación.


    5. Líneas posibles de investigación

    Deberás realizar todas las fases básicas y elegir varias investigaciones adicionales según las características de la fotografía.

    Fase 1. Inspección visual inicial

    Observa la imagen antes de utilizar buscadores o herramientas automáticas.

    Busca y registra elementos como:

    • Carteles.
    • Matrículas, que deberán ocultarse en la entrega.
    • Nombres de calles.
    • Nombres de comercios.
    • Logotipos.
    • Idiomas.
    • Señales de tráfico.
    • Banderas.
    • Edificios o monumentos.
    • Medios de transporte.
    • Uniformes.
    • Vegetación.
    • Tipo de carretera.
    • Arquitectura.
    • Mobiliario urbano.
    • Clima.
    • Relieve del terreno.
    • Posición del sol.
    • Sombras.
    • Cualquier elemento poco habitual.

    Crea una primera lista de hipótesis sin realizar todavía búsquedas.

    Ejemplo:

    ObservaciónPosible significadoGrado de confianza
    Señal triangular con borde rojoProbablemente EuropaMedio
    Texto aparentemente en portuguésPortugal o BrasilBajo
    Tranvía amarilloPodría ser LisboaBajo

    Las primeras hipótesis pueden ser incorrectas. Esto no se penalizará si posteriormente se contrastan.


    Fase 2. Análisis de metadatos

    Comprueba si la fotografía contiene metadatos EXIF, IPTC o XMP.

    Puedes utilizar herramientas como:

    • ExifTool.
    • Metadata2Go.
    • Jeffrey’s Image Metadata Viewer.
    • Exif.tools.
    • Propiedades del archivo del sistema operativo.

    Busca, si están disponibles, los siguientes campos:

    • Fabricante del dispositivo.
    • Modelo de cámara o teléfono.
    • Fecha y hora de captura.
    • Fecha de modificación.
    • Software utilizado.
    • Orientación.
    • Resolución.
    • Distancia focal.
    • Apertura.
    • Tiempo de exposición.
    • Sensibilidad ISO.
    • Uso del flash.
    • Coordenadas GPS.
    • Altitud.
    • Miniatura incrustada.
    • Autor o propietario.
    • Comentarios.
    • Copyright.

    Debes responder:

    1. ¿Qué metadatos conserva la fotografía?
    2. ¿Cuáles pueden ser útiles para la investigación?
    3. ¿Podrían haber sido modificados?
    4. ¿Existe alguna contradicción entre los metadatos y la imagen?
    5. ¿La fecha corresponde a la captura o a una modificación posterior?
    6. ¿Qué información privada podría revelar el archivo?

    Si aparecen coordenadas GPS, represéntalas en un mapa y compáralas con el contenido visible en la fotografía. No publiques coordenadas de domicilios particulares.


    Fase 3. Búsqueda inversa de imágenes

    Utiliza al menos dos servicios diferentes:

    • Google Lens.
    • Bing Visual Search.
    • TinEye.
    • Yandex Images.

    Compara los resultados obtenidos en cada buscador.

    Busca:

    • La misma fotografía.
    • Versiones recortadas.
    • Versiones con diferente resolución.
    • Publicaciones anteriores.
    • La posible fuente original.
    • Páginas donde se haya reutilizado.
    • Imágenes visualmente parecidas.
    • Posibles manipulaciones.

    Registra:

    BuscadorConsulta o imagen utilizadaResultado relevanteFecha del resultadoValoración

    Prueba también a realizar búsquedas con:

    • La imagen completa.
    • Un recorte de un edificio.
    • Un cartel o logotipo.
    • Un objeto singular.
    • El paisaje del fondo.
    • Una marca de agua.

    Indica cuál de los buscadores ha proporcionado mejores resultados y por qué.


    Fase 4. Extracción y análisis de texto

    Busca cualquier texto presente en la imagen:

    • Carteles.
    • Escaparates.
    • Camisetas.
    • Vehículos.
    • Señales.
    • Billetes.
    • Pantallas.
    • Documentos.
    • Nombres comerciales.

    Puedes utilizar herramientas OCR como:

    • Google Lens.
    • Microsoft Lens.
    • OCR.Space.
    • Tesseract.
    • Herramientas de OCR integradas en móviles u ordenadores.

    Después:

    1. Copia el texto detectado.
    2. Corrige posibles errores del OCR.
    3. Identifica el idioma.
    4. Traduce el texto si es necesario.
    5. Busca frases exactas entre comillas.
    6. Investiga nombres, dominios, teléfonos o establecimientos.
    7. Comprueba si el texto permite relacionar la fotografía con una ubicación o acontecimiento.

    No debes llamar a teléfonos, escribir a direcciones ni contactar con las personas encontradas.


    Fase 5. Geolocalización

    Intenta determinar:

    • País.
    • Región o provincia.
    • Ciudad.
    • Zona aproximada.
    • Punto concreto, únicamente si se trata de un lugar público.

    Puedes utilizar las siguientes pistas:

    Infraestructura

    • Forma y color de las señales.
    • Marcas de la carretera.
    • Semáforos.
    • Farolas.
    • Contenedores.
    • Bolardos.
    • Aceras.
    • Cableado.
    • Postes eléctricos.
    • Paradas de transporte.
    • Matrículas, sin publicar números completos.

    Entorno natural

    • Vegetación.
    • Tipo de suelo.
    • Montañas.
    • Costa.
    • Clima.
    • Estación del año.
    • Fauna visible.

    Entorno urbano

    • Arquitectura.
    • Materiales de construcción.
    • Numeración de edificios.
    • Comercios.
    • Monumentos.
    • Transporte público.
    • Logotipos municipales.

    Herramientas de apoyo

    • Google Maps.
    • Google Street View.
    • Google Earth.
    • OpenStreetMap.
    • Mapillary.
    • Wikimapia.
    • GeoHints.
    • Overpass Turbo, como opción avanzada.

    La ubicación debe justificarse comparando elementos visibles. No será suficiente escribir: “Google Lens dice que es Madrid”.


    Fase 6. Análisis de objetos y elementos

    Selecciona varios objetos relevantes y trata de identificarlos:

    • Modelo aproximado de vehículo.
    • Marca de un producto.
    • Tipo de uniforme.
    • Modelo de teléfono u ordenador.
    • Obra de arte.
    • Monumento.
    • Planta o animal.
    • Máquina o herramienta.
    • Cartel publicitario.
    • Logotipo.

    Para cada elemento indica:

    • Qué crees que es.
    • Cómo lo has buscado.
    • Qué fuentes has consultado.
    • Qué características coinciden.
    • Qué características no coinciden.
    • Nivel de confianza de la identificación.

    Fase 7. Análisis temporal o cronolocalización

    Intenta estimar cuándo fue tomada la fotografía.

    Puedes investigar:

    • Fecha incluida en los metadatos.
    • Carteles de eventos.
    • Publicidad temporal.
    • Obras en edificios.
    • Estado de la vegetación.
    • Ropa de las personas.
    • Meteorología.
    • Decoración navideña o festividades.
    • Modelos de vehículos.
    • Versiones de productos.
    • Posición del sol y dirección de las sombras.
    • Imágenes históricas de Street View.
    • Noticias o publicaciones relacionadas.

    Clasifica el resultado como:

    • Fecha exacta confirmada.
    • Intervalo temporal probable.
    • Estación del año estimada.
    • Fecha desconocida.

    Explica siempre qué evidencias apoyan la estimación.


    Fase 8. Análisis meteorológico

    Si has deducido una posible fecha y lugar, comprueba si el tiempo visible coincide con registros meteorológicos históricos.

    Observa:

    • Cielo despejado o cubierto.
    • Lluvia.
    • Nieve.
    • Suelo mojado.
    • Dirección aparente del viento.
    • Tipo de ropa.
    • Longitud de las sombras.
    • Estado de la vegetación.

    Este análisis no suele demostrar por sí solo una ubicación o fecha, pero puede servir para apoyar o descartar una hipótesis.


    Fase 9. Investigación del contexto

    Trata de averiguar por qué pudo tomarse la fotografía.

    Busca relaciones con:

    • Noticias.
    • Eventos.
    • Manifestaciones.
    • Conciertos.
    • Competiciones deportivas.
    • Ferias.
    • Inauguraciones.
    • Catástrofes naturales.
    • Obras públicas.
    • Publicaciones en páginas institucionales.
    • Bancos de imágenes.
    • Páginas turísticas.
    • Redes sociales públicas.

    No des por hecho que dos fotografías corresponden al mismo acontecimiento únicamente porque se parezcan.


    Fase 10. Comprobación de manipulación

    Analiza si la imagen presenta señales de edición o manipulación.

    Busca:

    • Sombras incoherentes.
    • Reflejos imposibles.
    • Diferencias de iluminación.
    • Bordes extraños.
    • Elementos repetidos.
    • Perspectiva incorrecta.
    • Texto deformado.
    • Zonas excesivamente borrosas.
    • Diferencias de compresión.
    • Metadatos de programas de edición.
    • Partes con distinta resolución.

    Puedes utilizar herramientas como:

    • Forensically.
    • FotoForensics.
    • ExifTool.
    • Ampliación y ajustes de contraste.
    • Búsqueda inversa de recortes.

    Las herramientas automáticas no proporcionan una prueba definitiva. Sus resultados deben interpretarse con prudencia.


    Fase 11. Esteganografía — ampliación avanzada

    Comprueba si la imagen podría contener información oculta.

    Posibles comprobaciones:

    • Archivos añadidos después del final de la imagen.
    • Texto incrustado.
    • Datos ocultos en los bits menos significativos.
    • Contenido comprimido dentro del archivo.
    • Información visible al separar canales de color.

    Herramientas posibles:

    • Binwalk.
    • Strings.
    • StegHide.
    • StegSeek.
    • Zsteg, para formatos compatibles.
    • Aperi’Solve.
    • CyberChef.

    Esta fase solamente debe realizarse sobre la imagen entregada para la práctica. No descargues ni ejecutes archivos desconocidos fuera del entorno controlado del laboratorio.


    6. Clasificación de los resultados

    Cada descubrimiento deberá etiquetarse de una de estas maneras:

    ClasificaciónSignificado
    Hecho confirmadoEstá demostrado mediante una evidencia fiable
    Muy probableExisten varias evidencias coincidentes
    PosibleHay algún indicio, pero no es suficiente
    HipótesisExplicación pendiente de comprobación
    DescartadoLas evidencias demuestran que no es correcto
    No determinadoNo se ha podido obtener información suficiente

    También asignarás un nivel de confianza:

    • Alto.
    • Medio.
    • Bajo.

    Ejemplo:

    La fotografía probablemente fue tomada en la Plaza Mayor de Salamanca. La arquitectura y el nombre visible de un comercio coinciden con Street View. Nivel de confianza: alto.


    7. Registro de evidencias

    Incluye una tabla general:

    IDDato investigadoHerramienta o fuenteResultadoClasificaciónConfianza
    E01Modelo del dispositivoExifTooliPhone 14Hecho confirmadoAlto
    E02CiudadStreet View y cartelValenciaMuy probableAlto
    E03FechaTipo de eventoMayo de 2024PosibleMedio

    Cada evidencia debe incluir:

    • Captura de pantalla.
    • Enlace a la fuente, cuando exista.
    • Fecha y hora de consulta.
    • Explicación del proceso.
    • Interpretación del resultado.

    Las capturas deben ocultar datos personales que no sean necesarios para la práctica.


    8. Informe final

    La entrega se realizará en un archivo README.md escrito en Markdown.

    Estructura obligatoria

    • Título de la investigación.
    • Nombre del alumno o equipo.
    • Curso.
    • Fecha.
    • Imagen reducida o censurada, si procede.

    2. Resumen ejecutivo

    Explicación breve de los principales descubrimientos.

    3. Descripción del archivo

    • Nombre.
    • Formato.
    • Tamaño.
    • Dimensiones.
    • Hash SHA-256.
    • Procedencia.

    4. Metodología

    Explicación de las fases realizadas y las herramientas empleadas.

    5. Análisis visual

    Observaciones iniciales e hipótesis.

    6. Análisis de metadatos

    Resultados obtenidos e interpretación.

    7. Búsqueda inversa

    Buscadores utilizados y resultados.

    8. Investigación del texto

    OCR, traducciones y búsquedas relacionadas.

    9. Geolocalización

    Proceso seguido para identificar el lugar.

    10. Análisis temporal

    Fecha o intervalo estimado.

    11. Otros análisis

    Objetos, contexto, meteorología, manipulación o esteganografía.

    12. Tabla de evidencias

    Listado completo de descubrimientos y nivel de confianza.

    13. Conclusiones

    Debes separar claramente:

    • Lo que has podido confirmar.
    • Lo que consideras probable.
    • Lo que no has podido determinar.
    • Las hipótesis descartadas.

    14. Reflexión sobre privacidad

    Responde:

    1. ¿Qué información sensible podría revelar una fotografía?
    2. ¿Qué datos eliminarías antes de publicarla?
    3. ¿Las redes sociales conservan siempre los metadatos?
    4. ¿Qué riesgos tiene publicar una imagen tomada en casa?
    5. ¿Cómo podría protegerse una persona antes de compartir fotografías?

    15. Fuentes consultadas

    Incluye todas las herramientas, páginas, mapas, artículos y documentos utilizados.


    9. Requisitos mínimos

    Para superar la práctica deberás realizar, como mínimo:

    • Inspección visual.
    • Cálculo del hash.
    • Análisis de metadatos.
    • Dos búsquedas inversas.
    • Extracción de texto, si existe.
    • Un intento razonado de geolocalización.
    • Análisis de al menos tres elementos visibles.
    • Tabla de evidencias.
    • Clasificación del nivel de confianza.
    • Reflexión sobre privacidad.
    • Documentación completa en Markdown.

    10. Opciones de ampliación

    Los alumnos que quieran profundizar podrán realizar una o varias de estas tareas:

    • Comparar los metadatos antes y después de enviar la fotografía por distintas plataformas.
    • Crear una copia sin metadatos y verificar su eliminación.
    • Analizar diferencias entre la imagen original y una versión publicada en una red social.
    • Utilizar Street View histórico.
    • Investigar la dirección de las sombras.
    • Comparar registros meteorológicos.
    • Buscar versiones anteriores de la fotografía.
    • Detectar posibles recortes o ediciones.
    • Utilizar herramientas de análisis forense.
    • Examinar si existe información oculta mediante esteganografía.
    • Elaborar una línea temporal de publicación.
    • Crear un mapa con los lugares candidatos.
    • Analizar cómo cambiarían los resultados si solamente se dispusiera de una captura de pantalla.

    11. Rúbrica orientativa

    ApartadoPorcentaje
    Organización, Markdown y presentación10 %
    Inspección visual y formulación de hipótesis10 %
    Análisis técnico y metadatos15 %
    Búsqueda inversa y localización de fuentes15 %
    OCR, objetos y pistas visuales10 %
    Geolocalización y análisis temporal15 %
    Evidencias, contraste y nivel de confianza15 %
    Conclusiones, privacidad y límites éticos10 %

    No se calificará únicamente la cantidad de información encontrada. Se valorará especialmente:

    • La calidad del razonamiento.
    • La capacidad de contrastar fuentes.
    • La documentación de los intentos fallidos.
    • La separación entre hechos e hipótesis.
    • El uso responsable de las herramientas.
    • La claridad de las conclusiones.

    12. Preguntas para la defensa

    El profesor podrá preguntar:

    • ¿Cuál ha sido la evidencia más importante?
    • ¿Qué dato parecía correcto inicialmente y luego descartaste?
    • ¿Qué herramienta te ha dado mejores resultados?
    • ¿Podrían estar manipulados los metadatos?
    • ¿Cómo has confirmado la ubicación?
    • ¿Qué grado de confianza asignas a tu conclusión?
    • ¿Qué otra explicación podría tener la evidencia?
    • ¿Qué dato no publicarías por motivos de privacidad?
    • ¿Podría otra persona reproducir tu investigación?
    • ¿Qué harías a continuación si dispusieras de más tiempo?

    13. Resultado esperado

    La investigación deberá finalizar con una conclusión prudente y verificable.

    No debes escribir:

    La foto fue tomada en Sevilla.

    Es preferible escribir:

    La fotografía fue tomada probablemente en Sevilla. El nombre del establecimiento visible coincide con un comercio situado en esa ciudad y la fachada puede verificarse en Street View. No se dispone de coordenadas GPS, por lo que la ubicación se clasifica como muy probable, con un nivel de confianza alto.

    En OSINT, reconocer que no existen pruebas suficientes también es un resultado válido.


    RETOS

    1. Plaza del Faro

    naliza el archivo reto_osint_plaza_del_faro.jpg y obtén toda la información posible sin consultar la solución del profesor.

    Debes estudiar:

    • Elementos visibles y posibles pistas engañosas.
    • Textos mediante OCR.
    • Lugar y momento aproximados.
    • Coherencia de luces y sombras.
    • Metadatos técnicos, EXIF, IPTC o XMP.
    • Posible contenido añadido u oculto en el archivo.
    • Diferencia entre hechos, indicios e hipótesis.

    2. Estación ferroviaria ficticia de montaña.

    Analiza reto_osint_estacion_valle_nevado.jpg sin consultar la soluciçon del profesor.

    Investiga los elementos visibles, los textos mediante OCR, la estación del año, la meteorología, la hora aproximada, los metadatos y cualquier contenido añadido al archivo.

    Debes diferenciar entre:

    • Evidencias confirmadas.
    • Indicios razonables.
    • Hipótesis pendientes.
    • Pistas engañosas.

    3. Bilbao

    Analiza el archivo reto_osint_avanzado_bilbao.png y reconstruye toda la cadena de evidencias.

    Objetivos

    • Geolocalizar la escena utilizando varias evidencias independientes.
    • Estimar fecha, hora, estación del año y condiciones meteorológicas.
    • Extraer textos mediante OCR y distinguir pistas válidas de señuelos.
    • Examinar la estructura interna del PNG y sus bloques de metadatos.
    • Detectar información codificada y explicar cómo se ha decodificado.
    • Comprobar si los canales de color contienen información oculta.
    • Detectar datos anexados después del final lógico de la imagen.
    • Construir y justificar la contraseña necesaria para recuperar la evidencia final.
    • Diferenciar entre indicio de edición y prueba de manipulación visual.

    Reglas

    No se proporciona una lista cerrada de herramientas. Cada decisión debe quedar documentada con comandos, capturas, resultados y nivel de confianza.

    El informe deberá incluir:

    1. Hash SHA-256 del archivo recibido.
    2. Análisis visual y OCR.
    3. Geolocalización razonada con al menos tres evidencias.
    4. Línea temporal y análisis de zona horaria.
    5. Inventario de bloques o chunks del PNG.
    6. Metadatos y cadenas encontradas.
    7. Análisis de esteganografía por canales y planos de bits.
    8. Búsqueda de firmas de archivos incrustados o anexados.
    9. Recuperación del código final.
    10. Separación entre hechos, hipótesis y pistas engañosas.

    No se considerará completa la práctica si únicamente se identifica la ciudad. El objetivo es reconstruir todas las capas del archivo.

  • Proyecto: Operación HAWKINS

    Proyecto: Operación HAWKINS

    Diseño de una infraestructura empresarial con VLSM y servicios de red

    1. Introducción

    Audio presentación

    El Centro de Investigación Avanzada de Hawkins es una organización ficticia inspirada en la serie Stranger Things. Tras varios incidentes en sus instalaciones, la dirección ha decidido sustituir su red improvisada por una infraestructura profesional, segmentada, documentada y preparada para crecer.

    El centro está formado por tres ubicaciones:

    • Sede Central de Hawkins: oficinas, laboratorios, seguridad, servidores y zona de visitantes.
    • Estación de Campo Starcourt: pequeño centro remoto de observación y comunicaciones.
    • Búnker NINA: instalación aislada en la que se realizan pruebas especialmente sensibles.

    Vuestro equipo ha sido contratado como consultora de sistemas y redes. Tendréis que analizar las necesidades de la organización, diseñar el direccionamiento mediante VLSM, construir una maqueta funcional y desplegar varios servicios de red.

    No se valorará únicamente que los equipos puedan comunicarse. La empresa exige una solución lógica, segura, ampliable, comprobada y correctamente documentada.


    2. Modalidad de trabajo

    • Trabajo individual o en parejas, según indique el profesor.
    • Herramienta principal recomendada: Cisco Packet Tracer.
    • Red IPv4 asignada a todo el proyecto: 172.20.0.0/16.
    • Todos los cálculos de subnetting deberán realizarse manualmente y explicarse además de mostrar las tablas completas.
    • En Packet Tracer no es necesario colocar físicamente todos los dispositivos indicados. Se representará cada red con un número reducido de equipos, pero el direccionamiento deberá admitir la cantidad real solicitada.
    • No es necesario realizar la configuración en los routers y switch, aunque si debe estar bien explicado en la documentación.

    3. Objetivos de aprendizaje

    Al terminar el proyecto, el alumnado deberá ser capaz de:

    1. Analizar las necesidades de una infraestructura con varias sedes.
    2. Crear subredes de distinto tamaño mediante VLSM.
    3. Calcular direcciones de red, broadcast, rangos utilizables y máscaras.
    4. Organizar departamentos mediante redes o VLAN independientes.
    5. Configurar direccionamiento estático y dinámico.
    6. Permitir la comunicación entre redes mediante routing.
    7. Aplicar reglas básicas de segmentación y control de acceso.
    8. Verificar el funcionamiento mediante pruebas reproducibles.
    9. Elaborar documentación técnica en Markdown.

    4. Historia del proyecto

    La infraestructura antigua utilizaba una única red para empleados, cámaras, servidores y visitantes. Esto ha provocado direcciones duplicadas, dificultad para localizar averías y acceso de usuarios no autorizados a recursos internos.

    La nueva red recibirá el nombre HAWKNET. Cada departamento deberá disponer de su propia subred. Las tres sedes estarán conectadas mediante enlaces WAN y compartirán determinados servicios alojados en la sede central.

    La dirección establece cuatro prioridades:

    • separar el tráfico de los departamentos;
    • garantizar que los nombres internos se resuelvan mediante DNS;
    • proporcionar configuración automática a los puestos de usuario;
    • proteger los laboratorios y la red de gestión frente a visitantes y dispositivos IoT.

    5. Topología general requerida

    La maqueta deberá contener, como mínimo:

    • un router o dispositivo de capa 3 en cada sede;
    • switches suficientes para representar la segmentación solicitada;
    • un switch principal en la sede central;
    • enlaces troncales cuando se utilicen VLAN;
    • un enlace entre la sede central y Starcourt;
    • un enlace entre la sede central y el búnker NINA;
    • servidores centralizados en Hawkins;
    • al menos un equipo cliente representativo en cada subred;
    • una nube o router ISP que represente Internet;
    • puntos de acceso inalámbricos para empleados y visitantes.

    El diseño exacto queda a criterio del equipo, pero todas las decisiones deberán justificarse.


    6. Necesidades de direccionamiento

    Se utilizará la red 172.20.0.0/16. A partir de ella debéis crear todas las subredes necesarias mediante VLSM.

    Las cantidades representan la capacidad que debe soportar cada red, no el número de dispositivos que hay que insertar en Packet Tracer.

    6.1. Sede Central de Hawkins

    Red o departamentoDispositivos actualesCrecimiento mínimo previsto
    Sensores, puertas y dispositivos IoT85020 %
    Wi-Fi de visitantes42020 %
    Personal administrativo19020 %
    Laboratorio de Energía11020 %
    Videovigilancia y seguridad física7520 %
    Investigadores6020 %
    Centro de Operaciones4220 %
    Servidores internos2620 %
    Telefonía IP2420 %
    Administración de red1220 %

    6.2. Estación de Campo Starcourt

    Red o departamentoDispositivos actualesCrecimiento mínimo previsto
    Personal de operaciones4820 %
    Sensores y cámaras3020 %
    Invitados1820 %
    Administración de red620 %

    6.3. Búnker NINA

    Red o departamentoDispositivos actualesCrecimiento mínimo previsto
    Laboratorio restringido2820 %
    Seguridad1420 %
    Servidores locales620 %
    Administración de red520 %

    6.4. Enlaces entre routers

    Debéis reservar una subred independiente para cada uno de estos enlaces:

    • Hawkins ↔ Starcourt.
    • Hawkins ↔ NINA.
    • Hawkins ↔ ISP.

    Cada enlace solo necesita las direcciones imprescindibles para sus dos extremos. Deberéis decidir si usar /30 o /31 y comprobar si la opción elegida es compatible con el simulador y los dispositivos utilizados.


    7. Normas para realizar el VLSM

    1. Calculad la capacidad necesaria sumando el crecimiento del 20 % y redondeando siempre hacia arriba.
    2. Recordad incluir las direcciones que vayan a consumir puertas de enlace, servidores u otros dispositivos de infraestructura.
    3. Ordenad las redes desde la que necesita más direcciones hasta la que necesita menos.
    4. Asignad a cada red el bloque más pequeño que cubra su necesidad.
    5. No pueden existir subredes solapadas.
    6. No debe desperdiciarse un bloque excesivamente grande sin una justificación técnica.
    7. La primera dirección utilizable de cada LAN se asignará, salvo justificación, a su puerta de enlace.
    8. Los servidores, routers, switches gestionables e impresoras usarán direcciones estáticas.
    9. Los clientes de usuario recibirán su configuración mediante DHCP.

    Para cada subred debéis mostrar el razonamiento utilizado. No será suficiente entregar una tabla generada automáticamente.


    8. Tabla obligatoria de direccionamiento

    La documentación incluirá una tabla como la siguiente, completada para todas las redes:

    SedeRed/VLANNecesidad con crecimientoPrefijoMáscara decimalDirección de redPrimer hostÚltimo hostBroadcastGateway
    HawkinsIoT

    También se añadirá una segunda tabla para los dispositivos configurados:

    DispositivoInterfazDirección IPMáscara/prefijoGatewayDNSAsignación
    SRV-DNS-01Fa0Estática

    9. VLAN y segmentación

    En la sede central cada departamento deberá estar separado mediante una VLAN o interfaz física diferente. Si se utilizan VLAN, debéis:

    • asignar un identificador y un nombre descriptivo a cada VLAN;
    • configurar los puertos de acceso;
    • utilizar una VLAN de gestión distinta de la VLAN nativa;
    • documentar qué puertos pertenecen a cada VLAN.

    Los identificadores de VLAN son libres, pero deben seguir un criterio coherente. Por ejemplo, se pueden agrupar por sede o por tipo de servicio.


    10. Routing entre sedes

    Todos los routers deberán conocer las redes remotas. El equipo elegirá una de estas opciones:

    El fallo de una ruta no podrá ocultarse añadiendo rutas innecesarias o utilizando una única red sin segmentación.


    11. Servicios obligatorios

    La red de servidores y las redes de administración no utilizarán DHCP para sus dispositivos principales.

    11.2. DNS

    El dominio interno será:

    hawkins.lab

    El DNS deberá contener, al menos, estos registros:

    11.3. Servidor web e intranet

    El servidor web mostrará una página sencilla con:

    • nombre y logotipo ficticio de la organización;
    • estado de las tres sedes;
    • mensaje de bienvenida;
    • nombre de los integrantes del equipo;
    • fecha de la última comprobación.

    La web pública de pruebas podrá ser accesible desde todas las redes. La intranet solo deberá ser accesible desde redes internas autorizadas.


    12. Requisitos básicos de seguridad

    La segmentación debe traducirse en reglas de acceso. Se configurarán ACL u otro mecanismo equivalente para cumplir, como mínimo, estas políticas:

    1. La red de visitantes solo puede acceder al DNS necesario, al portal web y a Internet.
    2. Los visitantes no pueden iniciar conexiones hacia las redes internas.
    3. La red IoT no puede acceder a Administración de red ni a los equipos de investigadores.
    4. Solo Administración de red puede gestionar routers y switches mediante SSH.
    5. Telnet deberá permanecer deshabilitado.
    6. El laboratorio NINA no será accesible desde redes de invitados.
    7. Seguridad podrá consultar las cámaras y sensores de las tres sedes.
    8. Los servidores DNS, DHCP y correo deberán ser accesibles únicamente desde las redes que necesiten cada servicio.

    Las reglas se colocarán lo más cerca posible del origen o destino y se documentará el motivo de cada una.


    13. Acceso a Internet y NAT

    La sede central se conectará a un router ISP. Debéis configurar:

    • una ruta por defecto hacia el ISP;
    • NAT/PAT para que las redes privadas autorizadas puedan salir a Internet;
    • un servidor externo de prueba, por ejemplo www.vecna-news.net, situado en una red que no pertenezca a 172.20.0.0/16;
    • bloqueo de salida para las redes que, según vuestra política, no deban acceder a Internet.

    No es necesario publicar servidores internos mediante NAT estático, aunque puede realizarse como ampliación.


    14. Nombres y configuración de dispositivos

    Los nombres deberán permitir identificar su ubicación y función. Ejemplos:

    RTR-HAW-01
    RTR-STAR-01
    RTR-NINA-01
    SW-HAW-CORE-01
    SW-HAW-LAB-01
    SRV-HAW-DNS-01
    PC-STAR-OPS-01

    15. Fases de realización

    Fase 1. Análisis

    1. Leed el caso completo.
    2. Identificad las sedes, departamentos, servidores y enlaces.
    3. Dibujad un primer esquema lógico.
    4. Decidid qué servicios serán centrales y cuáles serán locales.
    5. Anotad las restricciones de seguridad.

    Fase 2. Cálculo VLSM

    1. Calculad el número de hosts con crecimiento.
    2. Ordenad las redes de mayor a menor.
    3. Determinad el prefijo mínimo de cada una.
    4. Asignad los bloques dentro de 172.20.0.0/16.
    5. Calculad red, primer host, último host y broadcast.
    6. Comprobad que no existen solapamientos.
    7. Reservad espacio para futuras ampliaciones.

    Fase 3. Construcción de la topología

    1. Colocad routers, switches, servidores y clientes.
    2. Cablead correctamente los dispositivos.
    3. Asignad nombres a todos los equipos.
    4. Cread VLAN y configurad puertos.
    5. Configurad puertas de enlace.

    Fase 4. Direccionamiento y routing

    1. Configurad interfaces y subinterfaces.
    2. Asignad direcciones estáticas a infraestructura.
    3. Configurad rutas estáticas u OSPF.

    Fase 5. Pruebas y documentación

    1. Ejecutad el plan de pruebas.
    2. Corregid los fallos encontrados.
    3. Capturad evidencias relevantes.
    4. Completad el README.md.
    5. Revisad que otra persona pueda comprender y reproducir el proyecto.

    No se considerará demostrada una política si únicamente se prueba el caso permitido. Cuando corresponda, deberán probarse tanto el acceso correcto como su bloqueo.


    17. Entregables

    La entrega contendrá una carpeta comprimida con esta estructura orientativa:

    operacion-hawkins/
    ├── README.md
    ├── packet-tracer/
    │   └── hawknet.pkt
    ├── configuraciones/
    │   ├── RTR-HAW-01.txt
    │   ├── RTR-STAR-01.txt
    │   └── RTR-NINA-01.txt
    ├── diagramas/
    │   ├── topologia-logica.png
    │   └── topologia-fisica.png
    

    El archivo principal se llamará exactamente README.md y utilizará Markdown. Más adelante, cuando se haya trabajado Git, el mismo proyecto deberá poder incorporarse a un repositorio sin reorganizar toda la documentación.


    18. Contenido obligatorio del README.md

    1. Portada: título, integrantes, curso y fecha.
    2. Resumen ejecutivo del proyecto.
    3. Descripción de las tres sedes.
    4. Requisitos detectados.
    5. Diagrama lógico de red.
    6. Explicación paso a paso del cálculo VLSM.
    7. Tabla completa de direccionamiento.
    8. Tabla de VLAN.
    9. Inventario y función de los dispositivos.
    10. Explicación del routing seleccionado.
    11. Reglas de seguridad y ACL aplicadas.
    12. Configuración de NAT/PAT.
    13. Plan de pruebas y resultados.
    14. Problemas encontrados y soluciones.
    15. Conclusiones y posibles mejoras.
    16. Fuentes consultadas.

    Las capturas deben estar recortadas, ser legibles y llevar un pequeño texto explicativo. No se admitirán decenas de capturas sin contexto ni configuraciones pegadas sin explicación.


    19. Condiciones de aceptación

    El proyecto se considerará funcional cuando:

    • todas las subredes estén calculadas correctamente;
    • no haya direcciones duplicadas ni bloques solapados;
    • la comunicación entre sedes funcione;
    • los nombres internos se resuelvan mediante DNS;
    • los servicios obligatorios sean accesibles desde las redes autorizadas;
    • los accesos prohibidos sean realmente bloqueados;
    • el acceso exterior utilice NAT/PAT;
    • las pruebas estén documentadas;
    • el archivo de Packet Tracer se abra sin errores;
    • el README permita entender el trabajo sin una explicación oral adicional.

    Un proyecto en el que “todo puede comunicarse con todo” no cumplirá los requisitos de segmentación y seguridad.


    Las ampliaciones solo puntuarán si la parte obligatoria funciona y están correctamente explicadas.


    20. Penalizaciones importantes

    • Subredes solapadas o uso incorrecto de red/broadcast.
    • Archivo .pkt que no abre o que no coincide con la documentación.
    • Capturas de pantalla ajenas o configuraciones copiadas que el equipo no pueda explicar.
    • Uso de una sola red para evitar el trabajo de VLSM.

    21. Defensa del proyecto

    El profesor podrá seleccionar al azar cualquier dispositivo o prueba. El equipo tendrá que:

    Todos los integrantes deben conocer el proyecto completo. La división de tareas no exime de comprender el trabajo de la otra persona.


    23. Pregunta final de reflexión

    Incluid al final del README una respuesta razonada a estas cuestiones:

    • ¿Qué ventajas ofrece VLSM frente a utilizar la misma máscara en todas las redes?
    • ¿Qué ocurriría si empleados, servidores, cámaras y visitantes compartieran la misma red?
    • ¿Qué servicio causaría un impacto mayor si dejara de funcionar: DHCP, DNS o routing? Justificad la respuesta según vuestra infraestructura.
    • ¿Qué parte del diseño cambiaríais si la empresa duplicara su tamaño?

    Misión

    La red de Hawkins no debe limitarse a “tener pings”. Debe ser una infraestructura organizada, útil y defendible. Vuestro objetivo es demostrar que podéis convertir las necesidades de una organización en un diseño IP correcto, desplegar los servicios básicos y verificar que cada usuario accede únicamente a los recursos que necesita.