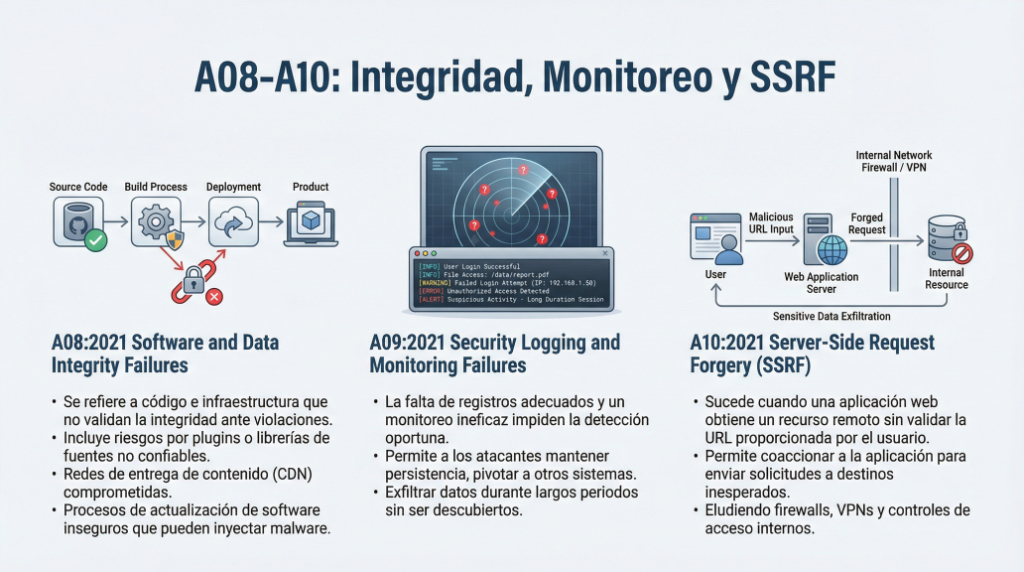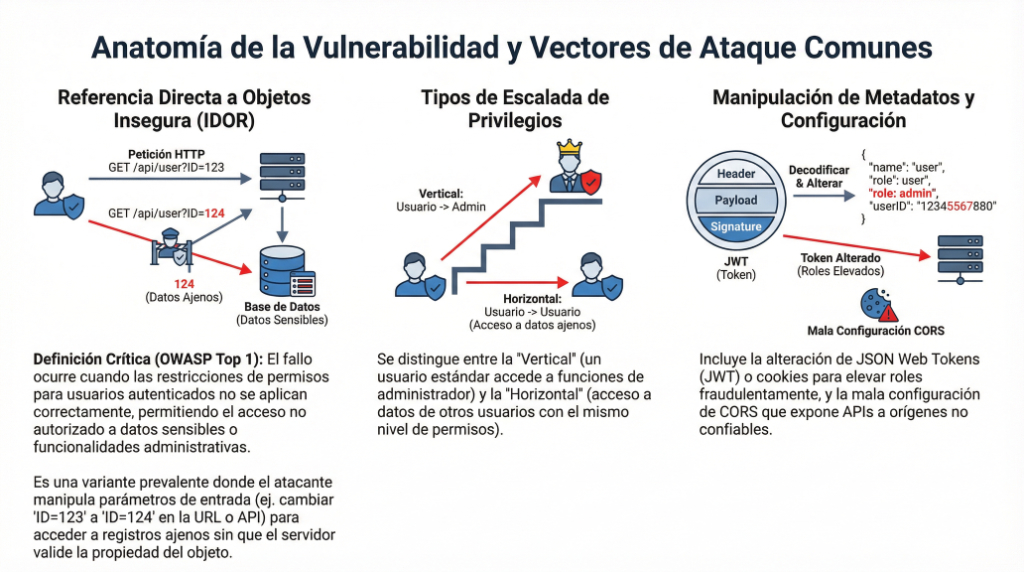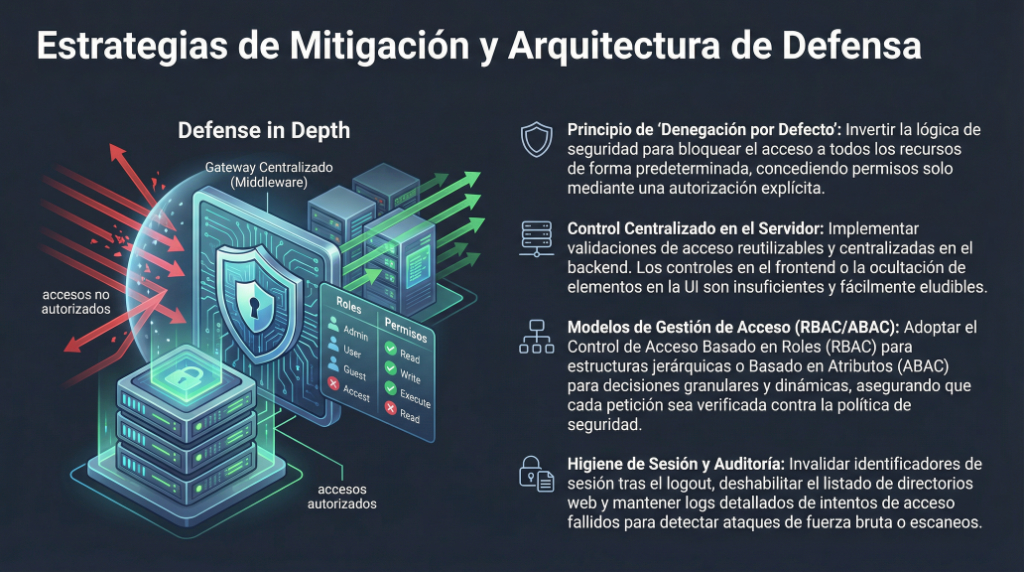
Autor: ciberkaos

  • 11. [Reto] Bash Incremental: Aprender Shell a Golpes de Ejemplos

    11. [Reto] Bash Incremental: Aprender Shell a Golpes de Ejemplos

    En esta práctica trabajarás con una colección de scripts en Bash orientados a tareas básicas de automatización y administración en Linux. El objetivo es que ejecutes y analices cada uno de los scripts en tu terminal para comprender su funcionamiento y el efecto que producen.

    Tareas a realizar

    1. Copia todos los scripts proporcionados en tu máquina Linux (física o virtual).
    2. Asegúrate de que cada script tenga permisos de ejecución usando: chmod +x nombre_script.sh
    3. Ejecuta cada script desde la terminal y observa el resultado.
    4. Modifica al menos 3 scripts para adaptarlos a una variante que tenga sentido. Por ejemplo:
      • Cambiar rutas
      • Cambiar comandos
      • Añadir opciones
      • Añadir colores o logs

    La línea del “shebang” (#!)

    #!/bin/bash
    #!/usr/bin/env bash

    La diferencia tiene que ver con flexibilidad vs. certeza.

    Cuando pones #!/bin/bash estás diciendo “usa Bash que está en /bin/bash”.
    Eso asume que la ruta es exactamente esa. En muchas distros Linux es verdad, en macOS a veces también, pero en otras no. Por ejemplo, en sistemas BSD, en instalaciones personalizadas, o si manejas múltiples versiones de Bash instaladas desde brew, nix, etc., /bin/bash puede no existir o no ser el Bash que quieres.

    La alternativa #!/usr/bin/env bash juega una carta distinta:
    env busca ejecutables en el PATH del usuario, encuentra dónde está bash y lo lanza.
    Es como decir: “búscame un Bash válido en la ruta del sistema y úsalo”.
    Eso lo vuelve más portátil y adaptable, sobre todo en entornos raros, macOS moderno, contenedores, virtual environments y setups educativos donde Bash no está donde uno espera.

    El resumen práctico:

    — #!/bin/bash = certero pero rígido. Si no existe esa ruta, falla.
    — #!/usr/bin/env bash = más portable y respetuoso del PATH, útil cuando no conoces el entorno.

    Ejemplo 1: “Hola, soy un script”
    Propósito: variables y echo.

    #!/usr/bin/env bash
    
    nombre="Antonio"
    echo "Hola, $nombre"
    echo "Estoy en el directorio: $(pwd)"
    

    Concepto nuevo: variables y comandos incrustados $(...).


    Ejemplo 2: “Si me pasas un nombre, lo uso”
    Propósito: argumentos $1.

    #!/usr/bin/env bash
    
    if [ -z "$1" ]; then
      echo "Uso: $0 <nombre>"
      exit 1
    fi
    
    echo "Hola, $1"
    

    Concepto nuevo: if mínimo, chequeo de argumentos y exit.


    Ejemplo 3: “Saludo a varios”
    Propósito: recorrer argumentos (for).

    #!/usr/bin/env bash
    
    if [ "$#" -eq 0 ]; then
      echo "Uso: $0 nombre1 nombre2 ..."
      exit 1
    fi
    
    for persona in "$@"; do
      echo "Hola, $persona"
    done
    

    Concepto nuevo: for y "$@" (todos los argumentos).


    Ejemplo 4: “Saludo según hora”
    Propósito: condicionales compuestos.

    #!/usr/bin/env bash
    
    hora=$(date +%H)
    
    if [ "$hora" -lt 12 ]; then
      saludo="Buenos días"
    elif [ "$hora" -lt 20 ]; then
      saludo="Buenas tardes"
    else
      saludo="Buenas noches"
    fi
    
    echo "$saludo, $(whoami)"
    

    Concepto nuevo: elif, comparaciones numéricas y uso de comandos para info del sistema.


    Pequeño ejemplo 5: “Función que loguea cosas”
    Propósito: funciones y reutilización.

    #!/usr/bin/env bash
    
    log(){
      echo "[$(date +%H:%M:%S)] $1"
    }
    
    log "Iniciando proceso"
    sleep 1
    log "Proceso terminado"
    

    Concepto nuevo: funciones y timestamps.


    Pequeño ejemplo 6: “Descargo URLs de una lista”
    Propósito: arrays, loops y llamar programas externos.

    Archivo urls.txt de ejemplo:

    https://example.org
    https://wikipedia.org
    

    Script:

    #!/usr/bin/env bash
    
    while read -r url; do
      [ -z "$url" ] && continue
      echo "Descargando $url"
      curl -s -O "$url"
    done < urls.txt
    

    Concepto nuevo: while read, redirección y pequeñas automatizaciones.


    Ejemplo 7: “Contador de líneas de código por extensión”
    Propósito: bucles, condicionales, comandos, pipes.

    #!/usr/bin/env bash
    
    if [ -z "$1" ]; then
      echo "Uso: $0 <directorio>"
      exit 1
    fi
    
    dir="$1"
    for ext in sh py js php; do
      total=$(find "$dir" -type f -name "*.$ext" -print0 | xargs -0 cat 2>/dev/null | wc -l)
      echo "$ext: $total líneas"
    done
    

    Concepto nuevo: usar herramientas externas y procesar resultados.


    Ejemplo 8: “Menú interactivo mínimo”
    Propósito: select y control básico de flujo.

    #!/usr/bin/env bash
    
    select opcion in Fecha Usuario Salir; do
      case "$opcion" in
        Fecha) date ;;
        Usuario) whoami ;;
        Salir) echo "Adiós"; break ;;
        *) echo "Opción no válida" ;;
      esac
    done
    

    Concepto nuevo: select + case.


    Pequeño ejemplo 9: “Backup comprimido con timestamp”
    Propósito: combinación de todo para algo útil.

    #!/usr/bin/env bash
    
    origen="$1"
    destino="$2"
    
    if [ -z "$origen" ] || [ -z "$destino" ]; then
      echo "Uso: $0 <directorio_origen> <directorio_destino>"
      exit 1
    fi
    
    fecha=$(date +%Y%m%d_%H%M%S)
    archivo="$destino/backup_$fecha.tar.gz"
    
    echo "Creando backup de $origen en $archivo..."
    tar -czf "$archivo" "$origen"
    echo "Backup creado."

    Ejemplo 10: Crear estructura de carpetas de proyecto

    Idea: Montar la estructura típica de un proyecto sin ir haciendo mkdir a mano.

    #!/usr/bin/env bash
    
    if [ -z "$1" ]; then
      echo "Uso: $0 <nombre_proyecto>"
      exit 1
    fi
    
    PROYECTO="$1"
    
    mkdir -p "$PROYECTO"/{src,bin,logs,tmp,docs}
    
    echo "Proyecto creado en: $PROYECTO"
    ls -R "$PROYECTO"
    

    Ejemplo 11: Buscar una palabra en todos los .log de un directorio

    Idea: Mini-grep para revisar logs del sistema o de una app.

    #!/usr/bin/env bash
    
    DIR="${1:-/var/log}"
    CADENA="$2"
    
    if [ -z "$CADENA" ]; then
      echo "Uso: $0 <directorio_logs> <cadena_a_buscar>"
      echo "Ejemplo: $0 /var/log error"
      exit 1
    fi
    
    echo "Buscando '$CADENA' en *.log de $DIR..."
    grep -Rni --include="*.log" "$CADENA" "$DIR"
    

    Ejemplo 12: Top 5 archivos más grandes de un directorio

    Idea: Visualizar qué archivos se están comiendo el disco.

    #!/usr/bin/env bash
    
    DIR="${1:-.}"
    
    echo "Top 5 archivos más grandes en: $DIR"
    du -ah "$DIR" 2>/dev/null | sort -h | tail -n 5
    

    Ejemplo 13: Aviso sencillo de uso de disco

    Idea: Script que comprueba / y avisa si pasa de cierto porcentaje.

    #!/usr/bin/env bash
    
    LIMITE=80  # porcentaje
    
    uso=$(df -h / | awk 'NR==2 {gsub("%","",$5); print $5}')
    
    echo "Uso actual de / : $uso%"
    
    if [ "$uso" -gt "$LIMITE" ]; then
      echo "⚠ Atención: uso de disco por encima de ${LIMITE}%"
    else
      echo "Todo OK, por debajo de ${LIMITE}%"
    fi
    

    Ejemplo 14: Copia rápida de syslog con timestamp

    Idea: Guardar copia de seguridad de un log del sistema en el HOME del usuario.

    #!/usr/bin/env bash
    
    ORIGEN="/var/log/syslog"
    DEST="$HOME"
    
    if [ ! -f "$ORIGEN" ]; then
      echo "No existe $ORIGEN (en algunas distros es /var/log/messages)"
      exit 1
    fi
    
    FECHA=$(date +%Y%m%d_%H%M%S)
    COPIA="$DEST/syslog_$FECHA.log"
    
    cp "$ORIGEN" "$COPIA"
    
    echo "Copia creada en: $COPIA"
    

    Ejemplo 15: Ping-monitor cutre pero efectivo

    Idea: Comprobar conectividad a un host cada pocos segundos.

    #!/usr/bin/env bash
    
    HOST="${1:-8.8.8.8}"
    
    echo "Monitoreando ping a $HOST (Ctrl+C para salir)"
    
    while true; do
      if ping -c 1 -W 1 "$HOST" >/dev/null 2>&1; then
        echo "[$(date +%H:%M:%S)] $HOST está accesible"
      else
        echo "[$(date +%H:%M:%S)] ⚠ $HOST NO responde"
      fi
      sleep 3
    done
    

    Ejemplo 16: Listar usuarios del sistema con su shell

    Idea: Leer /etc/passwd y mostrar usuario + shell. Tocado sistema pero muy didáctico.

    #!/usr/bin/env bash
    
    echo "Usuarios del sistema y su shell:"
    echo "--------------------------------"
    
    while IFS=: read -r user _ _ _ _ _ shell; do
      echo "$user -> $shell"
    done < /etc/passwd
    

    Ejemplo 17: Comprobar si un servicio está activo (systemd)

    Idea: Ver el estado de un servicio con systemctl.

    #!/usr/bin/env bash
    
    if [ -z "$1" ]; then
      echo "Uso: $0 <nombre_servicio>"
      echo "Ejemplo: $0 apache2"
      exit 1
    fi
    
    SERV="$1"
    
    estado=$(systemctl is-active "$SERV" 2>/dev/null)
    
    if [ "$estado" = "active" ]; then
      echo "✅ El servicio $SERV está ACTIVO"
    elif [ "$estado" = "inactive" ]; then
      echo "⏸ El servicio $SERV está INACTIVO"
    else
      echo "❓ El servicio $SERV no existe o no usa systemd (estado: $estado)"
    fi
    

    Ejemplo 18: Renombrar archivos añadiendo un prefijo

    Idea: Jugar con nombres de archivos y bucles. Muy útil para fotos, prácticas, etc.

    #!/usr/bin/env bash
    
    if [ "$#" -lt 2 ]; then
      echo "Uso: $0 <prefijo> <archivos...>"
      echo "Ejemplo: $0 practica1 *.txt"
      exit 1
    fi
    
    PREFIJO="$1"
    shift
    
    for fichero in "$@"; do
      if [ -f "$fichero" ]; then
        nuevo="${PREFIJO}_$fichero"
        mv "$fichero" "$nuevo"
        echo "$fichero -> $nuevo"
      else
        echo "Saltando $fichero (no es un archivo)"
      fi
    done
    

    Ejemplo 19: Menú para ver info básica del sistema

    Idea: Un menú simple que llame a varios comandos de sistema.

    #!/usr/bin/env bash
    
    mostrar_sistema() {
      echo "Sistema:"
      uname -a
    }
    
    mostrar_cpu() {
      echo "CPU:"
      lscpu | head -n 10
    }
    
    mostrar_mem() {
      echo "Memoria:"
      free -h
    }
    
    mostrar_disks() {
      echo "Discos:"
      df -h
    }
    
    PS3="Elige una opción (1-5): "
    
    select opcion in "Info sistema" "CPU" "Memoria" "Discos" "Salir"; do
      case "$REPLY" in
        1) mostrar_sistema ;;
        2) mostrar_cpu ;;
        3) mostrar_mem ;;
        4) mostrar_disks ;;
        5) echo "Adiós"; break ;;
        *) echo "Opción no válida" ;;
      esac
    done
    

  • Actividad – Completa Script de NMAP

    Actividad – Completa Script de NMAP

    Hacer un script de Bash que reúna los comandos y opciones más útiles de nmap, organizado en funciones y con un menú para que practiquen if/else, funciones, lectura de parámetros y buenas prácticas.y

    Completa el script, para ello se te propociona el menú y el conjunto de funciones utilizadas. Debes completarlo para que tenga un funcionamiento correcto

    # Menú principal
    main_menu() {
    
      while true; do
        clear
        echo "========================================"
        echo "       NMAP HELPER - MENÚ EDUCATIVO     "
        echo "========================================"
        echo "1) Ping scan (descubrir hosts vivos)"
        echo "2) TCP SYN top 100 (--top-ports 100 -sS)"
        echo "3) TCP connect scan y puertos personalizados (-sT -p)"
        echo "4) Detección de servicios y versiones (-sV -sC)"
        echo "5) Detección de SO (-O)"
        echo "6) Escaneo UDP (-sU)"
        echo "7) Escaneo agresivo (-A)"
        echo "8) NSE scripts (--script)"
        echo "9) Salida en formatos (-oN, -oX, -oG)"
        echo "10) Escaneo sin ping (-Pn)"
        echo "11) Crea tu propia opción para namp"
        echo "12) Salir"
        echo "========================================"
        read -p "Elige opción [1-12]: " opt

    En todas las opciones al final debe dar el mensaje de legalidad de uso.

    usage_note() {
      cat <<EOF
    
    IMPORTANTE (ÉTICA Y LEGAL):
    - Solo escanea equipos y redes que sean de tu propiedad o para los que tengas permiso explícito.
    - El escaneo puede ser detectado por IDS/IPS y puede tener consecuencias en redes de producción.
    - No uses estos comandos en redes públicas sin autorización.
    
    EOF
    }

  • Actividad – Script interactivo para gestión de red con Netplan

    Actividad – Script interactivo para gestión de red con Netplan


    En entornos Linux de servidor, la configuración de red es un elemento crítico. Un error puede dejar el sistema incomunicado, inaccesible por SSH o fuera de la red. En Ubuntu Server moderno, la gestión de red se realiza mediante Netplan, que utiliza archivos YAML para definir cómo se configuran las interfaces.

    En administraciones reales, cambiar entre IP dinámica (DHCP) y IP estática es una tarea habitual:

    • Laboratorios → DHCP automático
    • Servidores → IP fija y controlada
    • Máquinas virtuales → cambios frecuentes
    • Entornos de pruebas → configuraciones rápidas

    Automatizar esta tarea reduce errores humanos y permite aplicar buenas prácticas de administración.


    Se te pide desarrollar un script en Bash interactivo que permita:

    • Cambiar una interfaz de red entre DHCP y IP estática
    • Solicitar datos al usuario
    • Validar entradas básicas
    • Generar automáticamente el archivo de configuración Netplan
    • Aplicar los cambios con netplan apply
    • Crear copias de seguridad antes de modificar la configuración
    • Ofrecer un menú interactivo

    Requisitos técnicos

    El script debe:

    1. Ejecutarse únicamente como root
    2. Verificar que existe el archivo de Netplan
    3. Permitir elegir entre:
      • Configuración DHCP
      • Configuración IP estática
      • Salir
    4. En modo IP estática debe solicitar:
      • Dirección IP
      • Máscara en formato CIDR
      • Gateway
      • DNS
    5. Confirmar datos antes de aplicar cambios
    6. Crear copia de seguridad automática del archivo original
    7. Mostrar el archivo generado antes de aplicar
    8. Aplicar configuración con netplan apply
    9. Gestionar errores básicos

    Restricciones

    • El script debe estar escrito íntegramente en Bash
    • No se permite editar Netplan manualmente fuera del script
    • No se permite copiar directamente soluciones externas
    • Debe funcionar en Ubuntu Server con Netplan

    Análisis de solución

    Una vez terminado tu script puedes comparalo con el ejemplo de solución.

    Deberás:

    • Comparar tu solución con la propuesta
    • Detectar mejoras posibles
    • Identificar:
      • Validaciones adicionales
      • Buenas prácticas usadas
      • Manejo de errores
      • Estructura del código
      • Modularización en funciones

    El objetivo no es solo que funcione… sino entender cómo se escribe un script robusto de administración real.


    Ejemplo de solucion

    1. Idea general del script

    El script en Bash hará:

    1. Detectar qué archivo de Netplan estoy usando (normalmente algo como /etc/netplan/00-installer-config.yaml).
    2. Mostrar un menú en consola:
        1. Configurar IP estática
        1. Configurar IP dinámica (DHCP)
        1. Salir
    3. Según la opción:
      • Pedirá los datos necesarios (IP, máscara, gateway, DNS) si es estática.
      • Generará un archivo YAML de Netplan con esa configuración.
      • Ejecutará netplan apply para aplicar los cambios.

    IMPORTANTE:

    • Necesitaré ejecutarlo como root (sudo ./script.sh), porque va a escribir en /etc/netplan/.
    • Debo saber el nombre de la interfaz (por ejemplo enp0s3 o ens33). Lo puedo consultar mediante ip a o ifconfig

    2. Ejemplo de archivo Netplan (referencia rápida)

    Consulto mi archivo actual de Netplan mediante ls /etc/netplan primero y sudo cat /etc/netplan/50-cloud-init.yaml obteniendo las siguientes:

    DHCP (IP dinámica)

    network:
      version: 2
      ethernets:
        enp0s3:
          dhcp4: true

    «

    IP estática

    network:
      version: 2
      renderer: networkd
      ethernets:
        enp0s3:
          dhcp4: false
          addresses:
            - 192.168.1.50/24
          gateway4: 192.168.1.1
          nameservers:
            addresses:
              - 8.8.8.8
              - 1.1.1.1
    

    Nuestro script generará algo parecido según la opción que elijas.


    3. Script completo en Bash

    Mediante sudo nano script_cambiar_ip_netplan.sh,creo el script dentro de mi carpeta de scripts con ruta /home/mario/scripts. En su interior introduzco los siguientes parámetros de configuración:

    #!/usr/bin/env bash
    
    # ==========================================================
    # Script para cambiar entre IP estática y dinámica (DHCP)
    # en Ubuntu Server usando Netplan.
    #
    # Úsalo con:
    #   sudo ./cambiar_ip_netplan.sh
    # ==========================================================
    
    # ---------- CONFIGURACIÓN BÁSICA A EDITAR ----------
    # Nombre de la interfaz de red (ajústalo a tu caso: enp0s3, ens33, etc.)
    INTERFACE="enp0s3"
    
    # Archivo de Netplan a usar
    NETPLAN_FILE="/etc/netplan/50-cloud-init.yaml"
    # Si tu sistema usa otro, cámbialo aquí, por ejemplo:
    # NETPLAN_FILE="/etc/netplan/50-cloud-init.yaml"
    # ---------------------------------------------------
    
    # Comprueba que se ejecuta como root
    if [[ "$EUID" -ne 0 ]]; then
      echo "Este script debe ejecutarse como root. Usa: sudo $0"
      exit 1
    fi
    
    # Comprueba que existe el archivo de Netplan
    if [[ ! -f "$NETPLAN_FILE" ]]; then
      echo "ERROR: No se encuentra el archivo de Netplan: $NETPLAN_FILE"
      echo "Revísalo y edita el script para apuntar al archivo correcto."
      exit 1
    fi
    
    # Función para pausar
    pausa() {
      echo
      read -rp "Pulsa Enter para continuar..." _;
    }
    
    # Función para configurar DHCP
    configurar_dhcp() {
      echo "Configurando interfaz $INTERFACE con IP dinámica (DHCP)..."
    
      # Hacemos copia de seguridad
      cp "$NETPLAN_FILE" "${NETPLAN_FILE}.backup_$(date +%Y%m%d_%H%M%S)"
    
      cat > "$NETPLAN_FILE" <<EOF
    network:
      version: 2
      renderer: networkd
      ethernets:
        $INTERFACE:
          dhcp4: true
    EOF
    
      echo "Archivo Netplan generado:"
      echo "----------------------------------------"
      cat "$NETPLAN_FILE"
      echo "----------------------------------------"
    
      echo "Aplicando cambios con netplan apply..."
      netplan apply
    
      if [[ $? -eq 0 ]]; then
        echo "Configuración DHCP aplicada correctamente."
      else
        echo "Hubo un error al aplicar la configuración. Revisa el archivo YAML."
      fi
    
      pausa
    }
    
    # Función para configurar IP estática
    configurar_estatica() {
      echo "Configuración de IP estática para la interfaz: $INTERFACE"
      echo
    
      read -rp "Introduce la IP (ej: 192.168.1.50): " IP
      read -rp "Introduce la máscara en CIDR (ej: 24 para 255.255.255.0): " CIDR
      read -rp "Introduce la puerta de enlace (gateway) (ej: 192.168.1.1): " GATEWAY
      read -rp "Introduce DNS (separados por espacio, ej: 8.8.8.8 1.1.1.1): " DNS_ENTRIES
    
      # Validaciones básicas (muy simples)
      if [[ -z "$IP" || -z "$CIDR" || -z "$GATEWAY" || -z "$DNS_ENTRIES" ]]; then
        echo "Algún campo está vacío. Cancelando configuración."
        pausa
        return
      fi
    
      echo
      echo "Resumen de la configuración estática:"
      echo "  IP:           $IP/$CIDR"
      echo "  Gateway:      $GATEWAY"
      echo "  DNS:          $DNS_ENTRIES"
      echo
    
      read -rp "¿Es correcto? (s/n): " CONFIRM
      if [[ "$CONFIRM" != "s" && "$CONFIRM" != "S" ]]; then
        echo "Configuración cancelada."
        pausa
        return
      fi
    
      # Creamos una copia de seguridad del archivo actual
      cp "$NETPLAN_FILE" "${NETPLAN_FILE}.backup_$(date +%Y%m%d_%H%M%S)"
    
      # Generamos lista YAML de DNS
      DNS_YAML=""
      for dns in $DNS_ENTRIES; do
        DNS_YAML+="          - $dns"$'\n'
      done
    
      # Escribimos nueva configuración en el archivo Netplan
      cat > "$NETPLAN_FILE" <<EOF
    network:
      version: 2
      renderer: networkd
      ethernets:
        $INTERFACE:
          dhcp4: false
          addresses:
            - $IP/$CIDR
          gateway4: $GATEWAY
          nameservers:
            addresses:
    $(echo -n "$DNS_YAML")
    EOF
    
      echo "Archivo Netplan generado:"
      echo "----------------------------------------"
      cat "$NETPLAN_FILE"
      echo "----------------------------------------"
    
      echo "Aplicando cambios con netplan apply..."
      netplan apply
    
      if [[ $? -eq 0 ]]; then
        echo "Configuración estática aplicada correctamente."
      else
        echo "Hubo un error al aplicar la configuración. Revisa el archivo YAML."
      fi
    
      pausa
    }
    
    # Menú principal
    while true; do
      clear
      echo "=============================================="
      echo "   Cambiar configuración de red (Netplan)"
      echo "   Interfaz actual: $INTERFACE"
      echo "   Archivo Netplan: $NETPLAN_FILE"
      echo "=============================================="
      echo "1) Usar IP dinámica (DHCP)"
      echo "2) Usar IP estática"
      echo "3) Salir"
      echo "----------------------------------------------"
      read -rp "Elige una opción [1-3]: " OPCION
    
      case "$OPCION" in
        1)
          configurar_dhcp
          ;;
        2)
          configurar_estatica
          ;;
        3)
          echo "Saliendo..."
          exit 0
          ;;
        *)
          echo "Opción no válida."
          pausa
          ;;
      esac
    done
    

    4. Cómo usarlo paso a paso

    1. Crear el archivo del script: sudo nano script_cambiar_ip_netplan.sh Pega el contenido anterior, guarda y cierra (Ctrl+O, Enter, Ctrl+X).
    2. Dar permisos de ejecución: sudo chmod +x script_cambiar_ip_netplan.sh
    3. Editar variables según tu caso:
      • Abre el script y cambia: INTERFACE="enp0s3" NETPLAN_FILE="/etc/netplan/50-cloud-init.yaml" Pon el nombre de la interfaz que tengas y el archivo real de Netplan.
    4. Ejecutar el script como root: sudo ./script_cambiar_ip_netplan.sh
    5. Elegir opción del menú:
      • Si eliges estática, introduce:
        • IP (ej. 192.168.0.50)
        • CIDR (ej. 24)
        • Gateway (ej. 192.168.0.1)
        • DNS (ej. 8.8.8.8 1.1.1.1)

    5. Recomendaciones para no quedarte “sin red”

    • Haz pruebas estando en consola local (no por SSH), para que si te quedas sin red aún tengas acceso.
    • El script crea copias de seguridad del YAML original con nombre tipo:
      • /etc/netplan/00-installer-config.yaml.backup_20251206_153055
    • Si algo sale mal, puedes restaurar: sudo cp /etc/netplan/00-installer-config.yaml.backup_YYYYMMDD_HHMMSS /etc/netplan/00-installer-config.yaml sudo netplan applyM

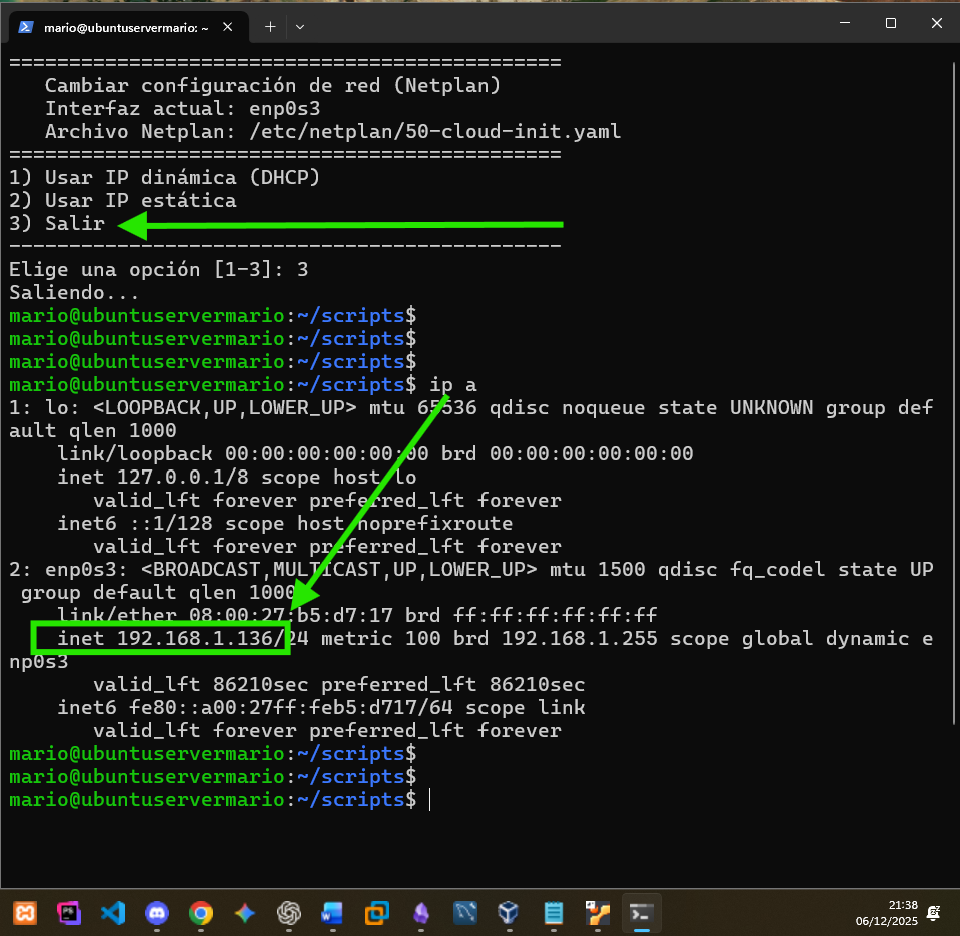
    6. Evidencias de funcionamiento del Script en mi UbuntuServer.

    • A continuación adjunto distintas capturas de pantallas de mi UbuntuServer en las que puedo seleccionar las distintas opciones (yo no asignaré IP fija en este momento, ya que quiero seguir trabajando con mi server mediante DHCP)

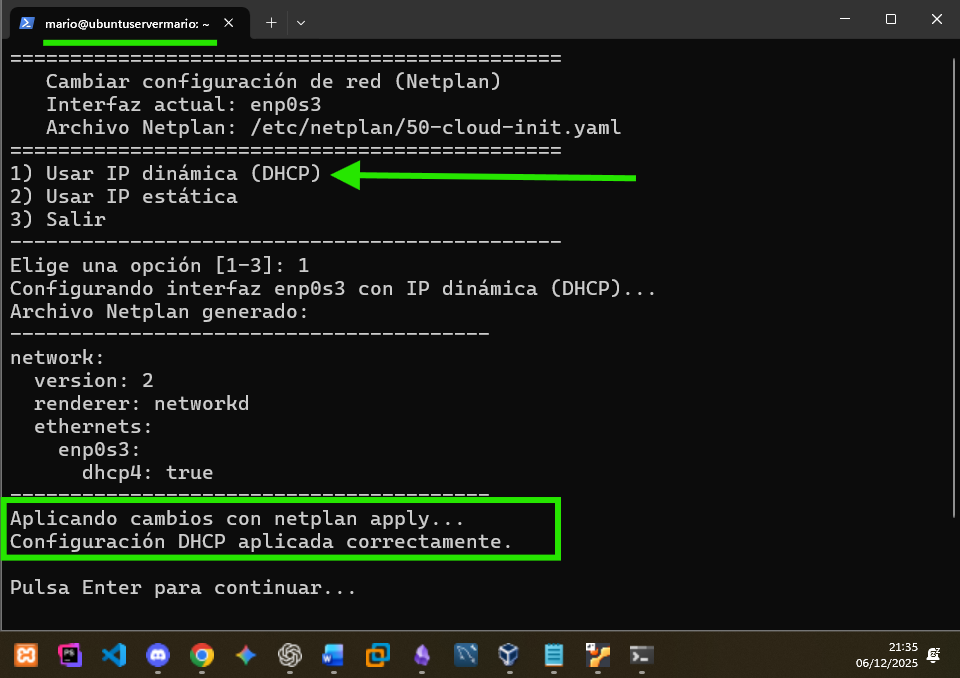
    Arrancamos el script seleccionado la config por DHCP:

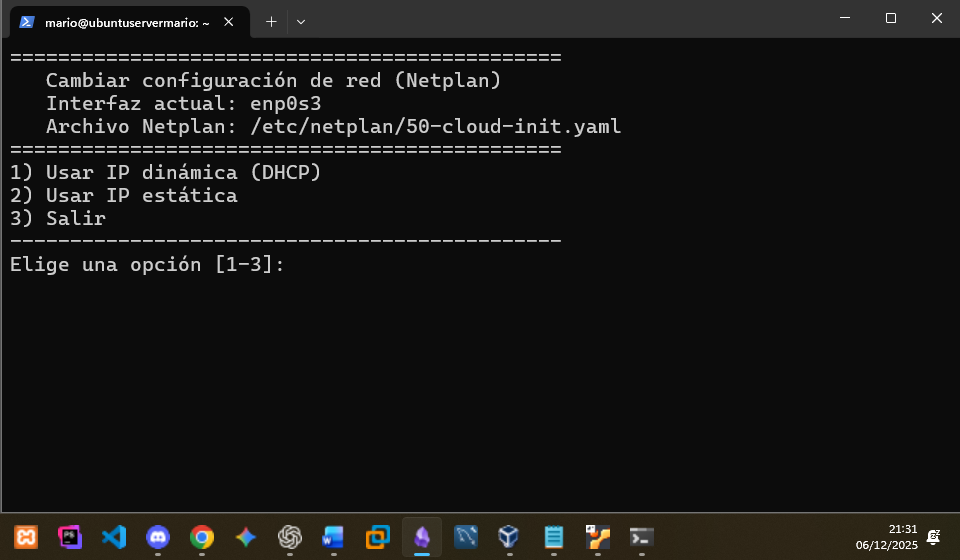
    Aquí vemos las opciones que nos ofrece, sin seleccionar ninguna:

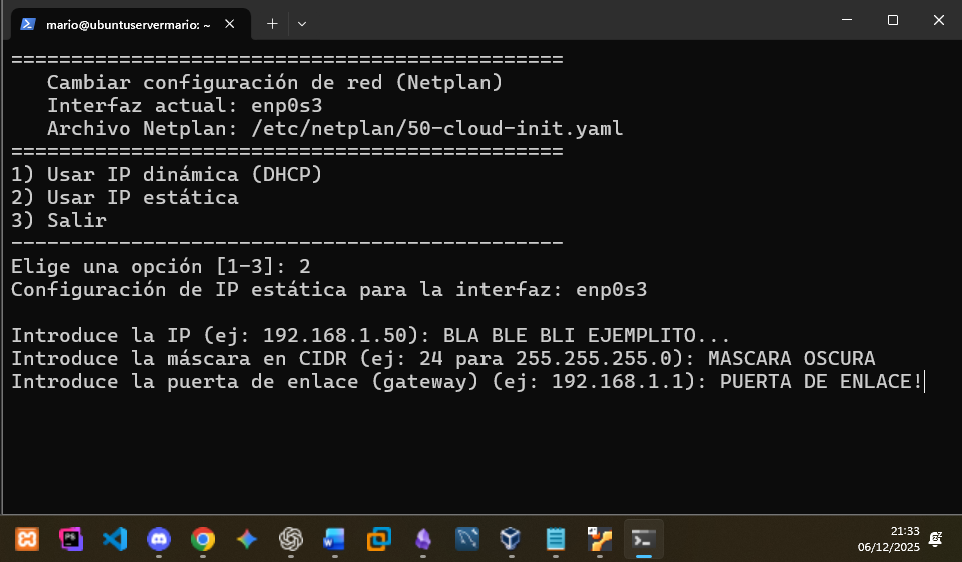
    En esta simulamos introducir los parámetros para configurar IP estática:

    Y en esta última seleccionamos la opción de salir, y hacemos un ip a donde evidencia la asignación de IP por DHCP:

  • OWASP Top 10

    OWASP Top 10

    La seguridad en aplicaciones web se ha convertido en uno de los pilares fundamentales de la tecnología moderna. Desde los primeros años de Internet hasta las complejas arquitecturas distribuidas actuales, la superficie de ataque no ha dejado de crecer. Las organizaciones, instituciones educativas, empresas y desarrolladores individuales dependen a diario de servicios expuestos en la web: sistemas de comercio electrónico, portales de administración pública, aplicaciones financieras, APIs móviles, servicios en la nube y plataformas de datos.
    En este ecosistema hiperconectado, la seguridad ya no es opcional, y comprender cómo se diseñan, evalúan y protegen las aplicaciones es una competencia esencial.

    En este contexto nace OWASP, siglas de Open Web Application Security Project, un proyecto abierto creado en 2001 con un objetivo claro: mejorar la seguridad del software de manera global, accesible y colaborativa. OWASP no pertenece a ninguna empresa ni responde a intereses comerciales; es una comunidad independiente formada por miles de profesionales, investigadores, empresas, voluntarios y académicos que comparten herramientas, documentación, buenas prácticas y estándares destinados a reducir el riesgo en aplicaciones web.

    A lo largo de más de dos décadas, OWASP ha evolucionado de un pequeño repositorio comunitario a convertirse en la referencia internacional en materia de seguridad de aplicaciones. Sus proyectos son utilizados por desarrolladores, auditores, equipos de ciberseguridad, gobiernos y universidades. La calidad y madurez de sus aportaciones ha hecho que muchas de sus metodologías formen hoy parte de marcos oficiales, certificaciones internacionales e incluso procesos internos de desarrollo en grandes corporaciones.

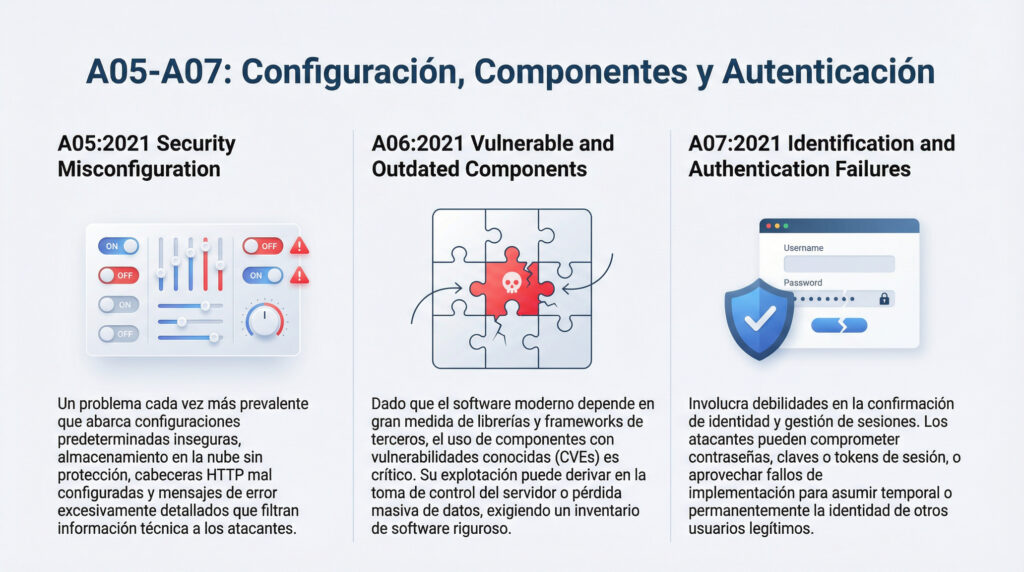
    OWASP Top Ten 2021:

    El OWASP Top Ten: un estándar, no una lista

    Entre todos los proyectos que mantiene OWASP, el más conocido es el OWASP Top Ten, una clasificación periódica que identifica las diez categorías de riesgos más críticos en aplicaciones web.
    Es importante subrayar que no se trata de un listado arbitrario, sino de un estándar de seguridad utilizado para:

    • Establecer requisitos mínimos en auditorías.
    • Formar a desarrolladores y equipos técnicos.
    • Definir políticas de desarrollo seguro.
    • Cumplir normativas o marcos de compliance.
    • Priorizar esfuerzos de corrección en aplicaciones reales.

    El Top Ten se elabora a partir de datos aportados por empresas de seguridad, análisis de millones de aplicaciones, estadísticas de ataques y consensos de la comunidad. De esta forma se consigue una visión realista y basada en datos sobre qué riesgos son realmente explotados por atacantes y qué errores aparecen con mayor frecuencia en el software moderno.

    La edición vigente a día de hoy, OWASP Top 10 – 2021, supuso un cambio importante respecto a sus predecesores. No solo reorganizó las categorías tradicionales, sino que introdujo nuevos conceptos como Insecure Design y amplió la visión hacia la causa raíz de los fallos, no solo sus síntomas. Al mismo tiempo, OWASP continúa evolucionando y, en 2025, ya existe un Top Ten 2025 Release Candidate, en fase de revisión, que refuerza áreas como la cadena de suministro (software supply chain), la gestión de configuraciones y el manejo de errores críticos. Aunque aún no sustituye oficialmente a la versión de 2021, nos ofrece una visión clara de hacia dónde se dirige la seguridad web en los próximos años.

    La relevancia de OWASP en el panorama actual

    La importancia de OWASP no reside únicamente en su famoso Top Ten. Su comunidad mantiene numerosos proyectos fundamentales en ciberseguridad, entre ellos:

    • OWASP Testing Guide, para pruebas de seguridad sistemáticas.
    • OWASP ASVS, un estándar completo para verificar aplicaciones.
    • OWASP MASVS, equivalente para seguridad móvil.
    • OWASP Cheat Sheets, una colección esencial de guías rápidas prácticas.
    • OWASP ZAP, una herramienta gratuita utilizada mundialmente para pentesting web.

    Estos recursos permiten comprender, evaluar y corregir la seguridad desde múltiples perspectivas: desarrollo seguro, auditoría, análisis forense, arquitectura de software o gestión de riesgos.

    El valor de OWASP es especialmente relevante hoy porque:

    1. La mayoría de ataques exitosos explotan fallos básicos que OWASP describe y enseña a prevenir.
    2. El software moderno es más complejo que nunca: microservicios, contenedores, APIs, nubes híbridas, y automatización continua.
    3. Las brechas de seguridad tienen impactos empresariales enormes: pérdidas económicas, daños reputacionales, sanciones legales y robo masivo de datos.
    4. La industria necesita profesionales formados y actualizados, capaces de analizar código, revisar configuraciones, identificar vulnerabilidades y aplicar mitigaciones reales.

    Por ello, estudiar OWASP no significa memorizar diez riesgos, sino aprender a pensar como un desarrollador seguro, un auditor y un atacante ético simultáneamente. Es un enfoque integral que forma parte de la cultura DevSecOps moderna.

    Comprender OWASP es comprender cómo funciona realmente la seguridad en el desarrollo web en 2025. Y, sobre todo, significa adquirir la capacidad de construir aplicaciones más robustas, detectar fallos antes de que lo hagan los atacantes, y aplicar una mentalidad de seguridad continua que acompañe al software durante todo su ciclo de vida.

    Historia resumida de OWASP

    2001 – Fundación de OWASP

    Creada por Mark Curphey para compartir buenas prácticas de seguridad en aplicaciones web.

    2003 – Primer OWASP Top Ten

    Primera clasificación pública de los riesgos más graves de seguridad web.

    2007–2013 – Consolidación

    OWASP se convierte en referencia internacional. Se publican guías clave:

    • OWASP Testing Guide
    • OWASP Code Review Guide
    • ESAPI

    2017 – Edición crítica

    Se añaden nuevas categorías como XXE y Deserialización insegura.

    2021 – OWASP Top 10 moderno

    Reorganiza las vulnerabilidades por causa raíz, añade Insecure Design y Supply Chain.

    2025 – Release Candidate (no final todavía)

    Refina los riesgos modernos:

    • Aquí tienes las 10 categorías del OWASP Top Ten 2025 para aplicaciones web:
    • A01:2025 – Broken Access Control
      Fallos en el control de acceso que permiten a atacantes eludir restricciones y acceder a datos o funcionalidades no autorizadas. [owasp.org], [cybersecur…tynews.com]
    • A02:2025 – Security Misconfiguration
      Configuraciones inseguras por defecto, servicios expuestos o controles inconsistentes que amplían la superficie de ataque. [owasp.org], [cybersecur…tynews.com]
    • A03:2025 – Software Supply Chain Failures
      Vulnerabilidades en dependencias, sistemas de construcción, CD/CI y la infraestructura de distribución. [owasp.org], [cybersecur…tynews.com]
    • A04:2025 – Cryptographic Failures
      Fallos en encriptación por uso de algoritmos débiles, claves cortas o implementación incorrecta, exponiendo datos sensibles. [owasp.org], [cybersecur…tynews.com]
    • A05:2025 – Injection
      Inyección de código (SQL, OS, LDAP, etc.) por no sanitizar entradas del usuario, lo que permite ejecutar comandos maliciosos. [owasp.org], [cybersecur…tynews.com]
    • A06:2025 – Insecure Design
      Falta de diseño seguro desde etapas tempranas, abordando seguridad solo como parche, no de forma integral. [owasp.org], [cybersecur…tynews.com]
    • A07:2025 – Authentication Failures
      Deficiencias en mecanismos de autenticación como inicio de sesión o recuperación de cuentas, que facilitan suplantación. [owasp.org], [cybersecur…tynews.com]
    • A08:2025 – Software or Data Integrity Failures
      Fallos que permiten modificar el software o datos sin detección, comprometiendo su integridad. [owasp.org], [cybersecur…tynews.com]
    • A09:2025 – Security Logging & Alerting Failures
      Registro y alertas de seguridad insuficientes, que dificultan detectar ataques y responder adecuadamente. [owasp.org], [cybersecur…tynews.com]
    • A10:2025 – Mishandling of Exceptional Conditions
      Manejo deficiente de errores y condiciones excepcionales, que puede exponer datos sensibles o permitir DoS. [cybersecur…tynews.com], [cyberpress.org]

    Estas diez categorías representan los riesgos más críticos para la seguridad de las aplicaciones web según la edición 2025 del OWASP Top Ten, publicada oficialmente el 6 de noviembre de 2025.
    (Sigue vigente oficialmente 2021, pero 2025 ya marca la tendencia del futuro.)

    Tabla comparativa OWASP Top 10 (2021 vs 2025)

    Puesto 2021Categoría 2021Puesto 2025Categoría 2025Cambio principal
    1Broken Access Control1Broken Access ControlSe mantiene #1; SSRF (A10:2021) se consolida dentro de esta categoría. [owasp.org]
    2Cryptographic Failures4Cryptographic FailuresBaja de #2 a #4. [owasp.org]
    3Injection5InjectionBaja de #3 a #5. [owasp.org]
    4Insecure Design6Insecure DesignBaja de #4 a #6. [owasp.org]
    5Security Misconfiguration2Security MisconfigurationSube de #5 a #2 por mayor prevalencia de configuraciones complejas. [owasp.org]
    6Vulnerable and Outdated Components3Software Supply Chain FailuresExpandida al enfoque de cadena de suministro (dependencias, build, distribución). [owasp.org]
    7Identification and Authentication Failures7Authentication FailuresRenombrada para mayor precisión; posición similar. [owasp.org]
    8Software and Data Integrity Failures8Software or Data Integrity FailuresLigerísimo ajuste de nombre; categoría equivalente. [owasp.org]
    9Security Logging and Monitoring Failures9Security Logging & Alerting FailuresRenombrada enfatizando alertas accionables además del logging. [owasp.org]
    10Server-Side Request Forgery (SSRF)——Eliminada como categoría independiente; integrada en A01: Broken Access Control. [owasp.org]
    ——10Mishandling of Exceptional ConditionsNueva en 2025: manejo inadecuado de errores/condiciones excepcionales (fallar “open”, fugas, DoS). [owasp.org], [cyberpress.org]

    Observaciones rápidas

    • Grandes movimientos: Security Misconfiguration sube con fuerza (#5 → #2); Cryptographic, Injection e Insecure Design descienden dos puestos. [owasp.org]
    • Evolución de componentes: Vulnerable and Outdated Components se amplía a Software Supply Chain Failures, reflejando el peso de ataques a la cadena de suministro (dependencias, CI/CD, repos, distribución). [owasp.org], [cybersecur…tynews.com]
    • Nuevas prioridades: Entra Mishandling of Exceptional Conditions (#10), centrada en errores y estados anómalos mal gestionados (excepciones, “fail-open”, fugas de información). [owasp.org], [cyberpress.org]
    • Consolidación: SSRF deja de ser categoría y se integra en Broken Access Control. [owasp.org]
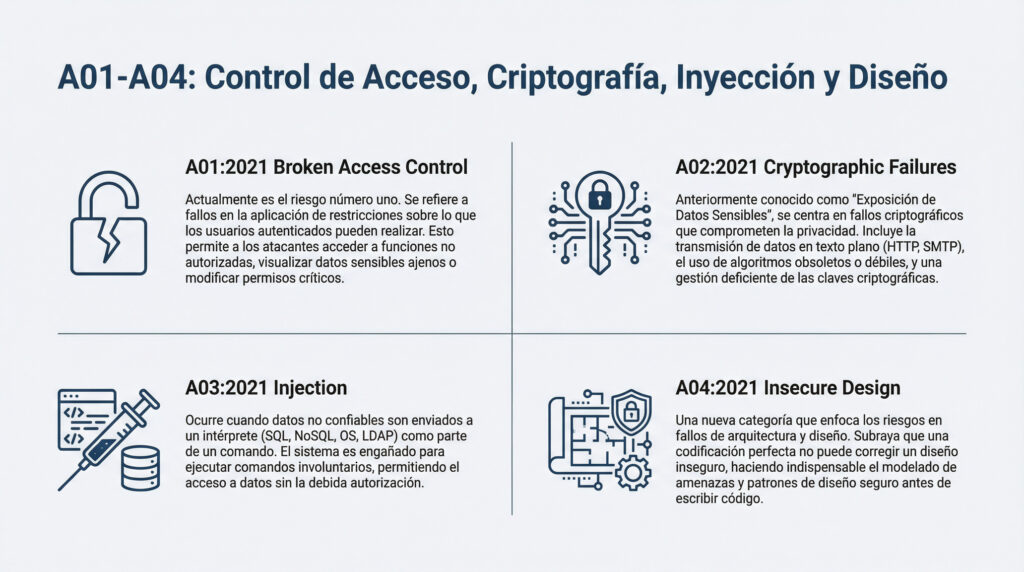
  • 1.1 – A01:2021 Broken Access Control (Pérdida de control de acceso)

    1.1 – A01:2021 Broken Access Control (Pérdida de control de acceso)

    La frase suena como el título de un episodio donde los guardianes de las puertas se echan la siesta y cualquier polizón digital puede colarse hasta la sala de máquinas. Broken Access Control —o “cuando lo que no debería pasar… pasa”— es justo eso: el desorden silencioso que aparece cuando un sistema no comprueba bien quién puede hacer qué.

    Si lo miras con ojos de ingeniería, el acceso es un filtro. Dejas pasar a quien debe pasar, bloqueas lo que debe bloquearse. Cuando ese filtro está roto, las cosas se vuelven raras: usuarios normales que pueden ver datos de admins, URLs ocultas accesibles por curiosidad, APIs que se creen cualquier identidad que les envías, o sesiones que no se invalidan cuando deberían.

    En la jerga de seguridad, hablamos de:

    • IDOR (Insecure Direct Object Reference): accedes a /factura/1234 y cambias el número por 1235… y te muestra otra factura que no es tuya. Como si giraras la manivela de una taquilla y todas se abrieran igual.
    • Saltos de rol (Privilege Escalation): el usuario «profesor» se hace pasar por «director» porque la aplicación solo comprueba el rol en el cliente o confía en un parámetro no verificado.
    • Rutas ocultas accesibles por URL: páginas “solo para admins” que no comprueban si lo eres de verdad, solo si intentas llegar.
    • Faltas en el control de sesión: tokens que deberían expirar y no lo hacen, o sesiones que no se invalidan tras un logout.

    OWASP en 2025 sigue catalogándola como una vulnerabilidad extremadamente común y de gran impacto. Tiene una cualidad casi poética: no requiere magia negra. A menudo no necesitas explotar buffers ni inventarte payloads complejos. Solo necesitas probar cosas que un usuario jamás debería poder hacer y ver si el sistema se molesta en decir que no.

    La defensa siempre gira alrededor del mismo mantra sobrio:

    • La validación de permisos se hace en el servidor, nunca confiando en el cliente.
    • Se decide “¿puede este usuario acceder a este recurso?” en cada petición, no solo al inicio.
    • Se evitan identificadores predecibles.
    • Y se audita la lógica como si intentaras entrar en un museo fingiendo que solo buscas el baño.

    En esencia, un sistema vulnerable permite que un usuario realice acciones o acceda a recursos que no le corresponden. Es como si un becario pudiera abrir la caja fuerte porque nadie se ha molestado en comprobar la llave.

    1. Qué es realmente Broken Access Control

    El sistema debería preguntar:
    “¿Quién eres?” (autenticación)
    “¿Qué puedes hacer?” (autorización)

    Broken Access Control ocurre cuando se responde correctamente a la primera pregunta, pero se olvida la segunda. Es una pérdida de disciplina, un despiste en la mecánica de comprobar permisos en cada petición.

    A efectos prácticos, se traduce así:
    Un usuario X puede alcanzar recursos destinados a usuarios Y, o incluso a administradores.

    Los atacantes adoran esto porque no requiere técnicas oscuras. Solo curiosidad, persistencia y un poco de mala idea.

    2. Tipos más frecuentes de fallos

    Aquí está el zoológico de problemas que suelen aparecer:

    • IDOR (Insecure Direct Object Reference)
      Petición: /api/user/42
      El atacante prueba: /api/user/43
      La aplicación entrega datos ajenos. No hay magia, solo falta de control interno.
    • Escalada de privilegios
      Un usuario sin privilegios consigue actuar como otro más poderoso. A veces basta con modificar un parámetro como role=admin en una petición mal diseñada.
    • Acceso a rutas “ocultas”
      Hay páginas que se confían en el “nadie sabrá que existe esta URL”. Pero si la aplicación no verifica permisos, cualquiera que la visite entra como si nada.
    • Métodos HTTP insuficientemente protegidos
      Se bloquea GET, pero no DELETE. El atacante descubre que puede borrar recursos jugando con el verbo adecuado.
    • Controles en el cliente en vez del servidor
      JavaScript que “esconde” botones de administración, esperando que el usuario no los active manualmente. La ilusión del “seguridad por CSS”.
    • Sesiones mal invalidadas o tokens sin expiración
      El atacante reutiliza sesiones antiguas que todavía funcionan.

    3. Por qué es tan común

    Porque es un problema invisible. Los desarrolladores suelen centrarse en las funcionalidades visibles: botones, bases de datos, lógica de negocio. La autorización es más sutil. Si la aplicación funciona bien para los usuarios legítimos, se da por buena… y se olvida comprobar qué pasa si un usuario prueba lo que “no debería”.

    Además, en sistemas con microservicios, APIs REST, contenedores y autenticación distribuida, mantener un control consistente en todos los puntos del sistema se convierte en un rompecabezas.

    4. Impacto

    El impacto es directo y contundente:

    • Filtración de datos privados
    • Modificación o borrado de información sensible
    • Toma de control parcial o total de cuentas
    • Acceso a funciones administrativas
    • Compromiso completo del sistema

    No es una molestia menor: es una brecha.

    5. Cómo detectar Broken Access Control

    Las técnicas habituales recuerdan al trabajo detectivesco, probando caminos prohibidos:

    • Manipular parámetros: IDs, nombres, UUIDs.
    • Probar diferentes métodos HTTP.
    • Fuerza bruta sobre rutas en el servidor.
    • En APIs, repetir peticiones cambiando el “subject” del recurso.
    • Comprobar respuestas diferentes según roles.
    • Revisar la lógica interna buscando decisiones basadas en el cliente.

    Aquí tus alumnos juegan casi a ser arqueólogos digitales, buscando grietas en la lógica.

    6. Cómo prevenirlo

    Los principios de defensa son sobrios pero muy efectivos:

    Control de acceso en el servidor, siempre.
    El cliente nunca es una fuente de verdad. Puedes ocultar botones, pero la validación real debe hacerse en el backend.

    Comprobación de permisos en cada petición.
    Cada vez que un usuario pide un recurso: “¿Puede este usuario acceder a este recurso concreto?”.

    IDs no predecibles.
    Si no pueden adivinar el identificador, es más difícil explotar IDOR. Aunque no es una defensa completa, ayuda.

    Tokens con expiración y revocación real.
    Una sesión debe morir cuando se cierra sesión.

    Segregación de funciones.
    Accesos administrativos separados y auditados. No mezclar roles como si fuesen cromos repetidos.

    Registros y auditorías.
    Si algo falla, debe quedar rastro. Los sistemas sin logs son como cajas negras sin grabadora.

    Pruebas de control de acceso automatizadas.
    Integrarlas en el pipeline evita que años después aparezca el clásico “¿cómo que cualquier usuario puede borrar pedidos?”.

    7. Ejemplo narrado

    Imagina que gestionas una tienda online. Un usuario autenticado visita:

    GET /pedidos/1287

    La aplicación entrega su pedido correctamente. Pero el atacante cambia el número:

    GET /pedidos/1288

    Si aparece otro pedido, hay un IDOR. La aplicación ha dado por hecho que si conoces el número, eres su dueño.

    Ahora imagina otra escena. En el panel interno, un usuario intenta acceder a:

    /admin/usuarios/listado

    La página carga sin comprobar su rol. Ese es el acceso directo a funciones críticas: falta de verificación de roles.

    En el tercer acto, un token de sesión sigue funcionando horas después del logout. Resultado: sesión no invalidada, un regalo para cualquiera que haya interceptado ese token.

    9. Relación con APIs modernas

    En sistemas basados en tokens (JWT, OAuth2), microservicios y Kubernetes, el control de acceso ya no es un único portero, sino un equipo entero. Cada servicio debe validar el token, verificar permisos y, sobre todo, no confiar en nada que venga del exterior.

    Los fallos en estos entornos suelen ser:

    • Servicios internos que no verifican el scope del token.
    • Roles definidos en el cliente, no en el backend.
    • Comunicaciones entre microservicios sin autenticación mutua.

    Las APIs son un campo fértil para este tipo de errores.

  • 1.2 – [Herramientas] – Postman

    1.2 – [Herramientas] – Postman

    En el mundo real —y en el mundo OWASP— el fallo más común no suele ser una inyección digna de Hollywood, sino algo mucho más mundano: el control de acceso mal aplicado. El punto 1 del OWASP Top 10, conocido como A01: Broken Access Control, lleva años liderando el ranking porque rompe la promesa básica de cualquier sistema: cada usuario solo puede hacer lo que le toca.

    Aquí es donde entra Postman, una herramienta que, usada con mentalidad de auditor, se convierte en una lupa perfecta para detectar accesos indebidos, IDORs y permisos mal definidos… sin necesidad de levantar un laboratorio complejo.

    Para en Windows, Mac y Linux. Puedes descargarlo aquí:

    https://www.postman.com/downloads


    Para OWASP A01 en una frase clara

    Broken Access Control ocurre cuando una aplicación no verifica correctamente quién eres y qué puedes hacer, permitiendo acciones como:

    • Acceder a recursos de otros usuarios.
    • Ejecutar funciones administrativas sin ser admin.
    • Modificar datos que deberían ser de solo lectura.
    • Saltarse flujos lógicos del backend.

    No es magia negra. Es lógica mal aplicada.


    Por qué Postman es ideal para auditar A01

    Postman no es solo “un cliente para hacer peticiones”. Es una consola de pruebas controladas donde puedes:

    • Repetir peticiones exactas.
    • Cambiar headers, tokens y parámetros a voluntad.
    • Simular distintos usuarios sin cambiar de sesión real.
    • Comparar respuestas del backend sin pasar por el frontend.

    En seguridad, quitar el frontend es quitar el maquillaje. Lo que queda es la verdad del backend.


    Caso práctico mental: el backend desnudo

    Imagina una API típica:

    GET /api/pedidos/123
    Authorization: Bearer TOKEN_USUARIO
    

    Con Postman puedes:

    • Cambiar el 123 por otro ID.
    • Reutilizar el mismo token.
    • Ver si el servidor comprueba la propiedad del recurso o solo confía en el ID.

    Si responde con datos que no son tuyos, no hay debate: A01 confirmado.


    Qué pruebas de Broken Access Control se hacen con Postman

    1. IDOR (Insecure Direct Object Reference)

    Cambias identificadores (id, user_id, order_id) y observas:

    • ¿Devuelve datos?
    • ¿Devuelve error 403?
    • ¿Devuelve “no encontrado” solo cuando conviene?

    Un backend sano no distingue entre “no existe” y “no es tuyo”.


    2. Escalada horizontal

    Mismo rol, distinto usuario.

    Ejemplo:

    • Usuario A accede a /api/profile/45
    • Usuario B prueba /api/profile/45

    Si ambos ven lo mismo, el sistema cree que “autenticado” es suficiente. Spoiler: no lo es.


    3. Escalada vertical

    Pruebas endpoints de administrador con un token normal:

    POST /api/admin/users
    

    Si la respuesta no es un 403 inmediato, hay un problema estructural, no un bug puntual.


    4. Métodos HTTP olvidados

    Con Postman puedes cambiar el verbo en segundos:

    • GET → PUT
    • PUT → DELETE

    Muchos sistemas protegen la vista, pero no la acción. El backend acepta lo que el frontend jamás envía.


    5. Falta de control en acciones lógicas

    No todo es CRUD. Prueba acciones como:

    • “cerrar pedido”
    • “aprobar solicitud”
    • “finalizar reserva”

    Si el backend no valida el estado previo y el rol, Postman lo descubre rápido.


    Postman como herramienta docente (y no solo ofensiva)

    Aquí viene la parte elegante: Postman no solo sirve para atacar, sino para enseñar a pensar bien.

    En clase o laboratorio, permite que el alumnado:

    • Vea la diferencia entre autenticación y autorización.
    • Entienda por qué el control debe estar en el backend.
    • Aprenda a documentar evidencias claras (request + response).
    • Desarrolle mentalidad de auditor: observar, probar, registrar.

    La seguridad no va de romper cosas, va de demostrar por qué se rompen.


    Buenas prácticas que Postman ayuda a verificar

    Un backend bien diseñado debería:

    • Validar permisos en cada endpoint, no en el frontend.
    • No confiar en IDs enviados por el cliente.
    • Aplicar roles y ownership en lógica de servidor.
    • Responder con errores coherentes (403 > 401 > 404).

    Postman no arregla estos problemas, pero los deja al descubierto con brutal honestidad.


    Conclusión: el bisturí del A01

    Postman es a Broken Access Control lo que un bisturí es a la anatomía:
    no grita, no hace ruido, pero corta justo donde duele.

    Usado con ética y método, es una de las mejores herramientas para entender por qué A01 sigue siendo el rey del OWASP Top 10 y por qué el control de acceso no es una opción, sino la base de todo sistema seguro.


    Proyecto guiado: “Postman vs. OWASP A01 – Auditoría de Control de Acceso en un CRUD con sesión”

    Usar Postman para auditar un CRUD con autenticación (sesión) y detectar fallos típicos de Broken Access Control:

    • IDOR: acceder/modificar recursos de otros.
    • Escalada horizontal: mismo rol, otro usuario.
    • Escalada vertical: endpoints “admin” accesibles sin serlo.
    • Métodos HTTP y acciones no previstas por el frontend.
    • Validación de ownership (propiedad del recurso) en el backend.

    Resultados

    1. Colección de Postman con:
    • requests organizadas por carpetas,
    • variables de entorno,
    • tests automáticos básicos.
    1. Informe de auditoría (capturas + evidencias):
    • Request y response (código, body relevante),
    • Resultado esperado vs. real,
    • Conclusión: “OK” o “Vulnerable” + impacto.

    Requisitos

    • Una con un CRUD funcionando en Apache.
    • Dos usuarios reales en la app:
      • userA (normal)
      • userB (normal)
      • Opcional: admin (si existe rol)
    • Cada usuario debe tener al menos 2 registros creados en el CRUD (por ejemplo “posts”, “productos”, “reservas”, etc.).

    Reglas de seguridad (muy importante)

    • Solo probar contra el entorno del aula/lab, no producción.
    • No borrar datos de otros equipos/grupos.
    • Si se detecta un fallo, se documenta: no se explota.

    1) Instalar y preparar Postman

    1. Instala Postman (desktop).
    2. Crea un Workspace: OWASP-A01-Auditoria-CRUD.
    3. Crea un Environment: LAB-CRUD.
    4. Añade estas variables:
    • baseUrl = http://IP_O_DOMINIO_DEL_SERVIDOR
    • usernameA = userA
    • passwordA = ...
    • usernameB = userB
    • passwordB = ...
    • cookieA = (vacío)
    • cookieB = (vacío)
    • idA_1 = (vacío)
    • idB_1 = (vacío)

    Nota: vamos a guardar cookies de sesión para simular usuarios distintos.


    2) Descubrir endpoints reales (sin adivinar)

    Aquí no inventamos rutas: las sacamos del propio sistema.

    2.1 Identificar la request de login

    1. En el navegador, abre DevTools → Network.
    2. Inicia sesión como userA.
    3. Busca la request de login y apunta:
      • Método (POST/GET)
      • URL exacta
      • Tipo de datos (form-data, x-www-form-urlencoded, JSON)
      • Respuesta (¿redirige? ¿devuelve JSON? ¿set-cookie?)

    Ejemplo típico (orientativo):

    • POST /login.php
    • body: username=...&password=...
    • response: Set-Cookie: PHPSESSID=...

    2.2 Identificar endpoints del CRUD

    Repite en Network mientras haces:

    • listar
    • ver detalle
    • crear
    • editar
    • borrar

    Apunta URLs y parámetros.


    Vamos a hacer dos flujos de login (usuario A y usuario B) y guardar sus cookies.

    3.1 Carpeta “Auth”

    Crea una colección: A01 - CRUD Audit.
    Dentro crea carpeta 01_AUTH.

    Request: Login - UserA

    • Método/URL: el del sistema (ej: POST {{baseUrl}}/login.php)
    • Body: los campos reales

    En Tests, añade:

    // Guarda cookie de sesión (si el backend usa cookies)
    const cookie = pm.response.headers.get('Set-Cookie');
    if (cookie) {
      pm.environment.set('cookieA', cookie.split(';')[0]); // PHPSESSID=...
    }
    pm.test("Login UserA devuelve 200/302", function () {
      pm.expect([200,302]).to.include(pm.response.code);
    });
    

    Request: Login - UserB

    Igual, pero guardando cookieB:

    const cookie = pm.response.headers.get('Set-Cookie');
    if (cookie) {
      pm.environment.set('cookieB', cookie.split(';')[0]);
    }
    pm.test("Login UserB devuelve 200/302", function () {
      pm.expect([200,302]).to.include(pm.response.code);
    });
    

    Si tu app no devuelve Set-Cookie en login porque ya lo setea antes, Postman igual puede mantener cookies con su “Cookie Jar”. Pero para enseñar A01, guardar cookie en variable hace que el alumno entienda qué está pasando.


    4) Preparar “headers por usuario” (simular identidad)

    En cada request del CRUD, pon el header:

    • Para simular UserA:
      • Cookie: {{cookieA}}
    • Para simular UserB:
      • Cookie: {{cookieB}}

    Crea dos carpetas:

    • 02_CRUD_UserA
    • 03_CRUD_UserB

    Y duplica requests para cada usuario (sí, duplicar aquí ayuda a aprender).


    5) Paso clave: obtener IDs reales de cada usuario

    Necesitamos un ID de un recurso de A y otro de B para probar IDOR.

    5.1 Listar recursos como UserA

    Request: List - UserA

    • GET {{baseUrl}}/ruta_listado (la real)

    En Tests, intenta extraer un id del JSON/HTML.

    • Si la API devuelve JSON (ideal):
    const data = pm.response.json();
    pm.environment.set("idA_1", data[0].id);
    pm.test("Tengo idA_1", () => pm.expect(pm.environment.get("idA_1")).to.not.be.undefined);
    
    • Si devuelve HTML, el alumno puede copiar el ID manualmente del listado o detalle y ponerlo en idA_1.

    5.2 Repetir con UserB

    Request: List - UserB y guardar/copiar idB_1.


    6) Pruebas OWASP A01 con Postman (con ejemplos)

    Ahora viene el núcleo. Cada prueba tiene:

    • Qué se prueba
    • Cómo hacerlo en Postman
    • Qué sería correcto
    • Qué sería vulnerable

    6.1 IDOR de lectura (Broken Access Control)

    Prueba

    UserA intenta ver el recurso de UserB.

    Request (como UserA):

    GET {{baseUrl}}/recurso/{{idB_1}}
    Header:

    • Cookie: {{cookieA}}

    Resultado correcto

    • 403 Forbidden o un error equivalente (o 404 “no existe”).
    • Nunca debería devolver el contenido del recurso de B.

    Vulnerable

    • Devuelve 200 y muestra el recurso de B.

    📌 Evidencia en informe:

    • URL + cookieA + response.

    6.2 IDOR de modificación (PUT/POST/EDIT)

    Prueba

    UserA intenta editar el recurso de B.

    Ejemplo (orientativo):

    • POST {{baseUrl}}/recurso/edit.php?id={{idB_1}}
      o
    • PUT {{baseUrl}}/api/recurso/{{idB_1}}

    Body: cambia un campo (ej. title=HACKED_BY_A).

    Resultado correcto

    • 403 / error.
    • El recurso no cambia.

    Vulnerable

    • 200 / “ok” y el recurso de B aparece modificado.

    📌 Extra didáctico:

    • Tras editar, hacer GET del recurso y comprobar si cambió.

    6.3 IDOR de borrado (DELETE)

    Prueba

    UserA intenta borrar el recurso de B.

    Ejemplo:

    • DELETE {{baseUrl}}/api/recurso/{{idB_1}}
      o
    • POST {{baseUrl}}/recurso/delete.php?id={{idB_1}}

    Resultado correcto

    • 403 / no permitido.

    Vulnerable

    • Recurso eliminado.

    ⚠️ En clase:

    • Hazlo en un “registro señuelo” para no romper trabajos.

    6.4 Escalada vertical (usuario normal llama a admin)

    Si existe panel admin:

    • GET {{baseUrl}}/admin/users
    • POST {{baseUrl}}/admin/create-user

    Como UserA (cookieA).

    Correcto: 403.
    Vulnerable: 200.

    Si no existe admin en su app, crea un endpoint “solo admin” ficticio en el enunciado como extensión (pero aquí trabajamos con lo real).


    6.5 Fallo por confiar en parámetros (user_id)

    Muchos CRUD hacen esto:

    • POST /recurso/create con user_id=...

    Prueba

    UserA crea un recurso pero forzando user_id={{idDeB}} o similar.

    Correcto:

    • El backend ignora ese user_id y asigna el de la sesión.
      Vulnerable:
    • Se puede crear contenido “a nombre de otro”.

    7) Tests automáticos en Postman (mini “cinturón de seguridad”)

    En cada request de prueba A01 añade tests como:

    pm.test("No debería permitir acceso indebido", function () {
      pm.expect([401,403,404]).to.include(pm.response.code);
    });
    

    Y en las que sean “normales” (acceso legítimo):

    pm.test("Acceso legítimo OK", function () {
      pm.expect(pm.response.code).to.eql(200);
    });
    

    Esto enseña a pensar como QA + seguridad: expectativas claras.


    8) Estructura de la colección (lista final)

    Colección A01 - CRUD Audit:

    • 01_AUTH
      • Login UserA
      • Login UserB
    • 02_CRUD_UserA
      • List A
      • View A (idA_1)
      • View B (idB_1) IDOR read test
      • Edit B (idB_1) IDOR write test
      • Delete B (idB_1) IDOR delete test
    • 03_CRUD_UserB
      • (equivalentes)
    • 04_A01_REPORT_EVIDENCES
      • Requests “limpios” que sirvan de referencia para el informe

    9) Guion de un informe

    Cada hallazgo debe tener:

    • Título: “IDOR lectura en /recurso/{id}”
    • Usuario atacante: UserA
    • Recurso víctima: idB_1
    • Pasos (Postman): request exacta + headers
    • Resultado esperado: 403/404
    • Resultado real: 200 con datos
    • Impacto: acceso a datos de terceros / modificación / borrado
    • Recomendación:
      • Verificar ownership en backend
      • Reglas RBAC/ABAC
      • No confiar en IDs del cliente
      • Tests de autorización por endpoint
  • 1.3 – [Herramientas] – Qué es curl

    1.3 – [Herramientas] – Qué es curl

    curl es un cliente de línea de comandos para hacer peticiones a URLs (HTTP/HTTPS y más). En ciberseguridad sirve para:

    • Reproducir una request exacta (sin navegador, sin JS, sin “magia”).
    • Cambiar headers, cookies, método (GET/POST/PUT/DELETE…), body, redirects, TLS, etc.
    • Guardar evidencias: headers, cuerpo, tiempos, códigos, trazas.
    • Automatizar pruebas: loops, wordlists, comparación de respuestas.

    En OWASP A01, curl es ideal para comprobar:

    “¿Puedo acceder a algo que no debería si cambio un ID, un rol, un método, una ruta o un header?”


    1) Base rápida: anatomía de una request con curl

    1.1 GET simple

    curl https://ejemplo.com/
    

    1.2 Ver solo headers (respuesta)

    curl -I https://ejemplo.com/
    

    1.3 Ver request + response (debug)

    • -v muestra el intercambio HTTP (ideal para auditoría).
    curl -v https://ejemplo.com/
    

    1.4 Seguir redirecciones

    Muchas apps redirigen a /login.

    curl -L https://ejemplo.com/zona-privada
    

    2) Opciones clave (las que usarás todo el rato)

    Salida y verbosidad

    • -i incluye headers de respuesta en la salida
    • -I hace HEAD (solo headers)
    • -v verbose (request/response)
    • -s silent (menos ruido)
    • -S muestra errores aunque uses -s
    • -D <file> guarda headers de respuesta en un fichero
    • -o <file> guarda el cuerpo en fichero
    • -w "<fmt>" imprime métricas (código, tiempos, etc.)

    Ejemplo “limpio pero con datos útiles”:

    curl -sS -D headers.txt -o body.html -w "STATUS=%{http_code}\nTIME=%{time_total}\n" https://ejemplo.com/
    

    Método HTTP

    • -X GET|POST|PUT|DELETE|PATCH|OPTIONS|HEAD

    Ojo nerd: curl elige método según uses -d (si usas -d, por defecto es POST). A veces conviene ser explícito con -X.

    Headers y autenticación

    • -H "Header: valor" añade header(s)
    • -u user:pass Basic Auth
    • -b "cookie=valor" envía cookies
    • -c cookies.txt guarda cookies en “cookie jar”
    • -b cookies.txt reutiliza cookies guardadas

    Datos (body)

    • -d "a=1&b=2" envía body tipo form-url-encoded
    • --data-urlencode codifica bien caracteres especiales
    • -H "Content-Type: application/json" -d '{"x":1}' JSON
    • -F "f=@archivo" multipart/form-data (subidas)

    TLS y certificados (útil en auditoría)

    • --tlsv1.2 fuerza versión TLS
    • --ciphers ... fuerza cifrados (avanzado)
    • --cert, --key (mTLS)
    • -k ignora validación del certificado (solo pruebas controladas, jamás en producción como “solución”)

    3) Plantilla de trabajo “A01-ready” (para evidencias)

    Esto te deja una salida reproducible, guardando pruebas:

    curl -sS -i -L \
      -w "\n\n---\nSTATUS=%{http_code}\nSIZE=%{size_download}\nTIME=%{time_total}\nIP=%{remote_ip}\nURL=%{url_effective}\n" \
      https://objetivo.tld/ruta
    

    Para separar headers y body en ficheros:

    curl -sS -D evidencias_headers.txt -o evidencias_body.txt \
      -w "STATUS=%{http_code}\nTIME=%{time_total}\n" \
      https://objetivo.tld/ruta
    

    4) OWASP A01: qué probar con curl (y cómo)

    4.1 IDOR (Insecure Direct Object Reference) — cambiar el ID

    Caso típico: /api/users/123 te devuelve tu usuario. ¿Qué pasa con /api/users/124?

    curl -sS -i https://victima.tld/api/users/123
    curl -sS -i https://victima.tld/api/users/124
    

    Qué buscar:

    • Si cambia el contenido y sigue devolviendo 200 OK, mala pinta.
    • Si debería ser 403 Forbidden (autorización) o 404 (no revelar existencia), depende del diseño, pero 200 para todo suele ser alarma.

    4.2 Bypass por método HTTP (GET vs PUT/DELETE)

    Muchas apps protegen el “ver” pero se olvidan del “modificar”.

    # ver
    curl -sS -i https://victima.tld/api/orders/55
    
    # intentar modificar
    curl -sS -i -X PUT -H "Content-Type: application/json" \
      -d '{"status":"CANCELLED"}' \
      https://victima.tld/api/orders/55
    
    # intentar borrar
    curl -sS -i -X DELETE https://victima.tld/api/orders/55
    

    Señal A01: endpoints sensibles aceptan métodos peligrosos sin chequear rol/propiedad.

    4.3 Acceso a rutas “admin” sin ser admin

    curl -sS -i https://victima.tld/admin
    curl -sS -i https://victima.tld/api/admin/users
    

    4.4 Cambiar rol en el cliente (cabeceras “de pega”)

    Si una app confía en algo como X-Role: admin (error grave), lo detectas así:

    curl -sS -i -H "X-Role: admin" https://victima.tld/api/me
    

    Nota: Esto no debería funcionar jamás si el backend está bien (el rol debe venir de sesión/token firmado).

    Primero sin login:

    curl -sS -i https://victima.tld/api/profile
    ~~`
    
    Luego con cookie de sesión (simulando usuario normal):
    
    1) Logueas una vez y guardas cookies:
    ~~~bash
    curl -sS -c cookies.txt -d "user=alumno&pass=1234" https://victima.tld/login
    
    1. Accedes con cookie:
    curl -sS -b cookies.txt -i https://victima.tld/api/profile
    
    1. Intentas un endpoint que debería ser solo admin:
    curl -sS -b cookies.txt -i https://victima.tld/api/admin/dashboard
    

    A01 clásico: usuario normal consigue 200 donde debería ser 403.

    4.6 Tokens Bearer (JWT / API tokens)

    curl -sS -i \
      -H "Authorization: Bearer TU_TOKEN" \
      https://victima.tld/api/orders
    

    Pruebas A01 típicas:

    • Usar token de usuario A para pedir recursos de usuario B (IDOR).
    • Ver si el backend solo valida “token válido” pero no valida “dueño del recurso”.

    4.7 Enumeración y filtrado: parámetros peligrosos

    Algunos endpoints aceptan filtros como ?userId=...:

    curl -sS -i "https://victima.tld/api/invoices?userId=10"
    curl -sS -i "https://victima.tld/api/invoices?userId=11"
    

    4.8 CORS mal configurado (pista de exposición)

    CORS no es “A01 puro”, pero a veces se mezcla con acceso indebido desde otros orígenes.

    curl -sS -i \
      -H "Origin: https://malicioso.tld" \
      https://victima.tld/api/profile
    ~~`
    
    Busca en respuesta:
    - `Access-Control-Allow-Origin: *` o refleja el Origin sin control
    - `Access-Control-Allow-Credentials: true` combinado con cosas raras
    
    ### 4.9 OPTIONS y descubrimiento de métodos permitidos
    ~~~bash
    curl -sS -i -X OPTIONS https://victima.tld/api/orders/55
    

    Mira Allow: o los headers CORS.


    5) Autenticación práctica con curl (cookies, sesiones, CSRF)

    5.1 Mantener sesión con cookies

    # login
    curl -sS -c cookies.txt -d "username=alumno&password=1234" https://victima.tld/login
    
    # usar sesión
    curl -sS -b cookies.txt -i https://victima.tld/mi-cuenta
    

    5.2 CSRF token (patrón general)

    Muchas apps: primero GET a formulario para obtener token, luego POST con token + cookie.
    Ejemplo conceptual (depende del sitio):

    # 1) cargar formulario y guardar cookies
    curl -sS -c cookies.txt https://victima.tld/form > form.html
    
    # 2) extraer token (si está en HTML; esto es un ejemplo típico)
    grep -oP 'name="csrf"\s+value="\K[^"]+' form.html > token.txt
    
    # 3) enviar POST con token + cookie
    curl -sS -b cookies.txt -d "csrf=$(cat token.txt)&campo=valor" https://victima.tld/submit
    

    En A01, CSRF no es el centro, pero aparece en flujos reales al automatizar.


    6) Subidas de archivo y pruebas de acceso (muy común en A01)

    6.1 Subir con multipart

    curl -sS -i \
      -b cookies.txt \
      -F "file=@prueba.txt" \
      https://victima.tld/upload
    

    6.2 Acceder al archivo de otro usuario

    Si el sistema guarda en /uploads/ID/archivo, prueba el ID (solo en entorno controlado):

    curl -sS -i https://victima.tld/uploads/10/prueba.txt
    curl -sS -i https://victima.tld/uploads/11/prueba.txt
    

    7) Reporting: sacar “pruebas bonitas” para un informe

    7.1 Guardar todo + métricas

    curl -sS -i -L \
      -o respuesta.txt \
      -w "\nSTATUS=%{http_code}\nTIME=%{time_total}\nSIZE=%{size_download}\n" \
      https://victima.tld/api/orders/55
    

    7.2 Solo el código HTTP (útil para scripts)

    curl -s -o /dev/null -w "%{http_code}\n" https://victima.tld/admin
    

    7.3 Comparar respuestas rápidamente (cambia ID y mira tamaño)

    curl -s -o /dev/null -w "ID=55 CODE=%{http_code} SIZE=%{size_download}\n" https://victima.tld/api/orders/55
    curl -s -o /dev/null -w "ID=56 CODE=%{http_code} SIZE=%{size_download}\n" https://victima.tld/api/orders/56
    

    Si los tamaños cambian de forma consistente… probablemente estás viendo datos distintos.


    8) Performance y timing (cuando el comportamiento cambia)

    • --max-time 10 corta si tarda más de 10s
    • --connect-timeout 3 timeout de conexión
    • --retry 3 --retry-all-errors reintentos (ojo en auditorías para no “machacar”)
    curl -sS --connect-timeout 3 --max-time 10 https://victima.tld/
    

    9) “Modo alumno”: 10 comandos que deberían saberse sí o sí

    curl -v https://host/ruta
    
    curl -I https://host/
    
    curl -L https://host/ruta
    
    curl -i https://host/api/recurso
    
    curl -H "Authorization: Bearer TOKEN" https://host/api
    
    curl -c cookies.txt -d "u=a&p=b" https://host/login
    
    curl -b cookies.txt https://host/privado
    
    curl -X PUT -H "Content-Type: application/json" -d '{"x":1}' https://host/api/x/1
    
    curl -X DELETE https://host/api/x/1
    
    curl -s -o /dev/null -w "%{http_code}\n" https://host/admin
    

    10) Errores típicos (y cómo no volverte loco)

    • 403 vs 401
      • 401 Unauthorized: no autenticado (falta login/token).
      • 403 Forbidden: autenticado pero sin permiso.
      • A01 suele ser “debería ser 403 y me dan 200”.
    • curl “no hace lo mismo que el navegador”
      • El navegador añade cookies, headers, y sigue redirects.
      • Usa -L, y si necesitas replicar, usa -v y añade -H y -b.
    • El endpoint requiere JSON
      • Añade -H "Content-Type: application/json".
    • El servidor redirige a login
      • Mira Location: con -i o sigue con -L.

    11) Tratamiento de sesiones.

    Si una web usa sesión, curl solo verá la respuesta correcta si:

    • primero creas la sesión (login)
    • luego reenvías la cookie de sesión en las peticiones siguientes

    El navegador lo hace solo. curl, no.


    Qué es realmente una sesión (visión backend)

    Cuando haces login:

    1. El servidor valida usuario/contraseña
    2. Crea una sesión en servidor
    3. Envía una cookie al cliente, por ejemplo:
    Set-Cookie: PHPSESSID=abc123; Path=/; HttpOnly
    

    A partir de ahí:

    • la cookie es tu identidad
    • sin cookie → eres un desconocido

    Paso 1️⃣ – Login y guardar la sesión

    Usamos -c para guardar cookies.

    curl -i \
      -c cookies.txt \
      -d "username=usuario1&password=1234" \
      http://servidor/login.php
    

    Comprueba el fichero:

    cat cookies.txt
    

    Verás algo tipo:

    PHPSESSID    abc123
    

    Eso es tu sesión.


    Paso 2️⃣ – Reutilizar la sesión para ver la respuesta real

    Usamos -b para enviar la cookie.

    curl -i \
      -b cookies.txt \
      http://servidor/api/profile.php
    

    Ahora verás:

    • la respuesta real
    • no el redirect al login
    • no el “no autorizado”

    📌 Sin -b cookies.txt, curl siempre será anónimo.


    Flujo completo (plantilla mental)

    Siempre que una web use sesión:

    1. curl -c cookies.txt → crear sesión
    2. curl -b cookies.txt → usar sesión
    3. Repetir paso 2 para cada endpoint protegido

    Ver exactamente qué devuelve el servidor

    Para auditoría, conviene ver headers + body:

    curl -i -b cookies.txt http://servidor/api/orders.php
    

    Si quieres guardar evidencias:

    curl -b cookies.txt \
      -D headers.txt \
      -o body.txt \
      -w "STATUS=%{http_code}\n" \
      http://servidor/api/orders.php
    

    Caso real típico: “me redirige al login”

    Si haces esto:

    curl http://servidor/api/profile.php
    

    y ves:

    HTTP/1.1 302 Found
    Location: /login.php
    

    No es que curl “no funcione”:
    es que no llevas la sesión.

    Solución:

    curl -L -b cookies.txt http://servidor/api/profile.php
    

    ¿Y si el login es JSON (API REST)?

    Muy común en APIs modernas.

    Login:

    curl -c cookies.txt \
      -H "Content-Type: application/json" \
      -d '{"user":"usuario1","pass":"1234"}' \
      http://servidor/api/login
    

    Acceso protegido:

    curl -b cookies.txt \
      http://servidor/api/orders
    

    Alternativa: tokens (Bearer)

    Si en vez de sesión usa token:

    curl -H "Authorization: Bearer TOKEN_AQUI" \
      http://servidor/api/orders
    

    Aquí no hay cookie, el token es la identidad.


    curl no tiene memoria
    si no le pasas la sesión, no eres nadie


    CASO PRACTICO

    Vamos un caso clásico:

    login en PHP con session_start() + usuario y contraseña.
    Sin suposiciones raras, sin frameworks, sin magia.

    Voy a explicarlo como piensa el servidor PHP, que es la clave para que curl tenga sentido.


    Qué hace PHP cuando haces login (lo importante)

    En un login típico en PHP ocurre esto:

    1. session_start();
    2. PHP crea (o reanuda) una sesión
    3. Si el usuario es correcto: $_SESSION['user_id'] = 3; $_SESSION['role'] = 'user';
    4. PHP envía al navegador: Set-Cookie: PHPSESSID=abc123

    📌 Ese PHPSESSID es la identidad real del usuario
    No el usuario, no la contraseña: la cookie.


    Cómo reproducir eso con curl (paso a paso real)


    Hacer login con curl y guardar la sesión

    Supongamos:

    • Login: /login.php
    • Campos POST: username y password

    Comando correcto

    curl -i \
      -c cookies.txt \
      -d "username=usuario1&password=1234" \
      http://servidor/login.php
    

    Qué hace cada cosa

    • -d → envía el POST (login)
    • -c cookies.txt → guarda la cookie PHPSESSID
    • -i → ves headers (para comprobar que hay Set-Cookie)

    Si todo va bien, verás algo como:

    Set-Cookie: PHPSESSID=abc123; path=/; HttpOnly
    

    📌 Eso significa: sesión creada correctamente


    cat cookies.txt
    

    Contenido típico:

    # Netscape HTTP Cookie File
    servidor   FALSE   /   FALSE   0   PHPSESSID   abc123
    

    Esto es la sesión PHP.


    Acceder a una página protegida usando la sesión

    Ahora reenvías la cookie:

    curl -i \
      -b cookies.txt \
      http://servidor/privado.php
    

    Si el login fue correcto:

    • verás el contenido real
    • no redirige a /login.php
    • no dice “no autorizado”

    Cada vez que vean PHP + sesión:

    1. curl -c cookies.txt → crear sesión
    2. curl -b cookies.txt → usar sesión
    3. Repetir paso 2 tantas veces como haga falta

    CASO REAL: “me redirige al login”

    Si haces:

    curl http://servidor/privado.php
    

    y ves:

    HTTP/1.1 302 Found
    Location: login.php
    

    👉 No es un error
    👉 Es que no llevas la sesión

    Solución:

    curl -L -b cookies.txt http://servidor/privado.php
    

    SIMULAR DOS USUARIOS DISTINTOS (muy A01)

    Usuario normal

    curl -c cookies_user.txt \
      -d "username=user&password=1234" \
      http://servidor/login.php
    

    Admin

    curl -c cookies_admin.txt \
      -d "username=admin&password=admin123" \
      http://servidor/login.php
    

    Comparar accesos

    curl -b cookies_user.txt  http://servidor/admin.php
    curl -b cookies_admin.txt http://servidor/admin.php
    

    📌 Si ambos ven lo mismo → Broken Access Control


    PROBAR IDOR CON SESIÓN REAL

    curl -b cookies_user.txt \
      "http://servidor/order.php?id=1"
    
    curl -b cookies_user.txt \
      "http://servidor/order.php?id=2"
    

    Si cambia el contenido → IDOR confirmado


    GUARDAR EVIDENCIA (modo auditor)

    curl -b cookies_user.txt \
      -D headers.txt \
      -o body.txt \
      -w "STATUS=%{http_code}\n" \
      http://servidor/order.php?id=2
    

    Eso es evidencia técnica válida.


  • 1.3.1 [Reto]  – curl como herramienta de auditoría

    1.3.1 [Reto] – curl como herramienta de auditoría

    Tu equipo ha sido contratado para auditar el control de acceso de una aplicación web interna.
    La aplicación funciona correctamente “a simple vista”, pero la empresa sospecha que usuarios autenticados podrían acceder a recursos que no les pertenecen.

    Tu misión no es romper nada, sino demostrar con evidencias técnicas si los controles de acceso están bien implementados… o no.


    Objetivos del proyecto

    Al finalizar la práctica, el alumno será capaz de:

    • Comprender OWASP Top 10 – A01: Broken Access Control
    • Usar curl como herramienta de auditoría (no como navegador)
    • Simular usuarios, sesiones y roles
    • Detectar fallos de:
      • IDOR
      • Falta de autorización
      • Bypass por método HTTP
      • Acceso a rutas protegidas
    • Generar evidencias reproducibles para un informe técnico

    Escenario

    Infraestructura

    • Servidor: Apache + PHP (o similar)
    • Base de datos: MySQL / MariaDB
    • Aplicación web con:
      • Login y sesión
      • CRUD de “Pedidos” o “Reservas”
      • Dos roles:
        • usuario
        • admin

    Endpoints de ejemplo

    (ajústalos a tu app con otros nombres)

    FunciónEndpoint
    Login/login.php
    Perfil usuario/api/profile.php
    Listar pedidos/api/orders.php
    Ver pedido/api/order.php?id=ID
    Modificar pedido/api/order.php?id=ID (PUT)
    Borrar pedido/api/order.php?id=ID (DELETE)
    Panel admin/admin/dashboard.php

    Preparación del entorno

    Comprobar curl

    curl --version
    

    Crear carpeta de trabajo

    mkdir auditoria_a01
    cd auditoria_a01
    

    Reconocimiento pasivo (sin login)

    Acceso a recursos protegidos sin autenticar

    curl -i http://servidor/api/orders.php
    

    Anota:

    • Código HTTP
    • ¿Redirige a login?
    • ¿Devuelve datos?

    📌 Si devuelve datos → indicio crítico de A01.


    Intento directo a panel admin

    curl -i http://servidor/admin/dashboard.php
    

    Resultado esperado:

    • 401 o redirección a login
      Resultado peligroso:
    • 200 OK

    Autenticación y gestión de sesión

    Login como usuario normal

    curl -c cookies_user.txt \
         -d "username=usuario1&password=1234" \
         http://servidor/login.php
    

    Comprueba que se crea cookies_user.txt.


    Acceso autenticado

    curl -b cookies_user.txt -i http://servidor/api/profile.php
    

    OWASP A01 en acción (Broken Access Control)


    IDOR – Acceso a pedidos de otros usuarios

    Pedido propio

    curl -b cookies_user.txt -i \
    "http://servidor/api/order.php?id=1"
    

    Pedido ajeno

    curl -b cookies_user.txt -i \
    "http://servidor/api/order.php?id=2"
    

    Vulnerabilidad A01 si:

    • Ambos devuelven 200 OK
    • Se muestran datos de otro usuario

    Enumeración automática de IDs

    for i in 1 2 3 4 5; do
      curl -s -o /dev/null \
      -w "ID=$i STATUS=%{http_code} SIZE=%{size_download}\n" \
      -b cookies_user.txt \
      "http://servidor/api/order.php?id=$i"
    done
    

    Patrón típico A01:

    • Todos los IDs responden con 200
    • Tamaños distintos → datos distintos

    Bypass por método HTTP (PUT / DELETE)

    Intento de modificación

    curl -X PUT \
      -H "Content-Type: application/json" \
      -d '{"status":"CANCELLED"}' \
      -b cookies_user.txt \
      -i \
      "http://servidor/api/order.php?id=2"
    

    Intento de borrado

    curl -X DELETE \
      -b cookies_user.txt \
      -i \
      "http://servidor/api/order.php?id=2"
    

    📌 A01 crítico si:

    • Usuario normal puede modificar/borrar pedidos ajenos

    Acceso a funciones admin con usuario normal

    curl -b cookies_user.txt -i \
    http://servidor/admin/dashboard.php
    

    Resultado correcto:

    • 403 Forbidden
      Resultado vulnerable:
    • 200 OK

    Headers manipulables (prueba de confianza indebida)

    curl -b cookies_user.txt \
      -H "X-Role: admin" \
      -i \
      http://servidor/api/profile.php
    

    📌 Si el rol cambia → fallo grave de diseño.


    Evidencias para informe

    Guardar headers y cuerpo

    curl -b cookies_user.txt \
      -D evidencia_headers.txt \
      -o evidencia_body.txt \
      -w "STATUS=%{http_code}\nTIME=%{time_total}\n" \
      "http://servidor/api/order.php?id=2"
    

    Evidencia mínima reproducible

    curl -s -o /dev/null \
      -w "STATUS=%{http_code}\n" \
      -b cookies_user.txt \
      "http://servidor/api/order.php?id=2"
    

    Esto es oro puro para un informe técnico.

  • 1.4 – Ética, legalidad y límites reales en ciberseguridad

    1.4 – Ética, legalidad y límites reales en ciberseguridad

    En ciberseguridad existe una tentación muy común cuando se empieza:

    “Solo voy a probar un poco, no voy a romper nada”.

    Herramientas como curl, Postman, Burp o simples peticiones HTTP hacen que testear una web parezca trivial. Sin embargo, aquí aparece una de las lecciones más importantes de toda la profesión:

    👉 Que algo sea técnicamente posible no significa que sea legal.


    La regla de oro de la ciberseguridad

    Nunca pruebes la seguridad de un sistema que no es tuyo sin autorización explícita.

    No importa:

    • que sea “solo por aprender”
    • que no haya daño
    • que no se roben datos
    • que el fallo sea evidente
    • que la petición sea un simple GET

    📌 La legalidad no depende de la herramienta ni de la intención, depende del permiso.


    No es legal que un estudiante (ni un profesional) pruebe vulnerabilidades en:

    • Páginas web “random” de Internet
    • APIs públicas que no son suyas
    • Paneles /admin, /api/users, /orders?id=2 de terceros
    • Aplicaciones reales sin consentimiento del propietario

    Aunque:

    • solo se cambie un ID
    • solo se mire la respuesta
    • no se modifique nada
    • no se guarde información

    📌 Acceder a recursos que no te corresponden ya es un problema legal, aunque el servidor “te deje”.


    El error mental más común

    “Pero solo hice una petición HTTP…”

    Un error muy habitual es pensar que:

    • GET = legal
    • POST / PUT / DELETE = ilegal

    Esto es falso.

    La ley no distingue métodos HTTP, distingue:

    • quién es el dueño del sistema
    • si tienes autorización
    • si accedes a información o funciones fuera de tu rol

    Un solo GET a un recurso privado puede ser ilegal.
    Un DELETE en un entorno autorizado puede ser perfectamente legal.


    ¿Qué dice la ley?

    En España y la Unión Europea, probar sistemas ajenos sin permiso puede encajar en:

    • Acceso no autorizado a sistemas informáticos
    • Interferencia en sistemas de información
    • Tratamiento ilícito de datos personales (si hay datos reales)

    Esto se aplica aunque no haya daño, porque el delito no es “romper”, es acceder sin derecho.


    Hay escenarios completamente válidos y profesionales:

    ✔️ Sistemas propios

    • Servidores propios
    • Máquinas virtuales
    • Docker
    • Laboratorios locales
    • Infraestructura del centro educativo


    ✔️ Laboratorios diseñados para ser atacados

    Plataformas educativas y entornos vulnerables creados expresamente para practicar.

    Aquí hay algo clave:
    consentimiento explícito.


    ✔️ Bug Bounty (con reglas muy claras)

    Algunas empresas permiten pruebas, pero:

    • solo ciertos dominios
    • solo ciertos tipos de ataques
    • con límites muy estrictos

    No es recomendable como punto de partida para estudiantes.


    ✔️ Autorización escrita

    Un correo, contrato o documento que indique:

    • qué se puede probar
    • hasta dónde
    • en qué condiciones

    Esto es lo que separa a un auditor profesional de un aficionado imprudente.


    La ciberseguridad no va de ser más listo que el sistema, va de ser responsable con el conocimiento.

    Un buen profesional no es quien encuentra más vulnerabilidades,
    sino quien sabe cuándo tiene derecho a buscarlas.

    La ética no es “relleno académico”:
    es una competencia técnica tan importante como saber usar una herramienta.

  • 2.1 – A02: Cryptographic Failures: cuando la criptografía falla, todo falla

    2.1 – A02: Cryptographic Failures: cuando la criptografía falla, todo falla

    En seguridad informática hay una idea peligrosa que aparece una y otra vez: “uso HTTPS, así que mis datos están seguros”. Esta frase, tan común como incorrecta, es la puerta de entrada perfecta al OWASP Top 10 – A02: Cryptographic Failures.

    Este punto no habla de ataques sofisticados ni de hackers con sudaderas negras. Habla de algo mucho más cotidiano —y mucho más grave—: usar mal la criptografía o no usarla cuando es necesaria.


    De “exposición de datos” a “fallos criptográficos”

    En ediciones anteriores del OWASP Top 10, este riesgo se conocía como Sensitive Data Exposure. El cambio de nombre a Cryptographic Failures no es un simple ajuste semántico. Es una declaración de intenciones.

    El problema real no es que los datos se expongan “por accidente”, sino que:

    • Se almacenan sin protección
    • Se cifran con algoritmos obsoletos
    • Se gestionan claves de forma negligente
    • Se confía en mecanismos que no ofrecen seguridad real

    Cuando la criptografía falla, la aplicación puede funcionar perfectamente… mientras los datos quedan totalmente expuestos.


    Qué es realmente un fallo criptográfico

    Un fallo criptográfico no significa que el algoritmo sea débil. En la mayoría de los casos, los algoritmos funcionan exactamente como fueron diseñados. El problema está en cómo los usamos.

    Algunos ejemplos habituales:

    • Guardar contraseñas en texto plano
    • Cifrar contraseñas en lugar de hashearlas
    • Usar MD5 o SHA-1 porque “siempre se ha hecho así”
    • Reutilizar claves en distintos sistemas
    • Incluir secretos directamente en el código fuente
    • Pensar que Base64 es cifrado

    La criptografía no perdona errores conceptuales. Si se aplica mal, la seguridad es una ilusión.


    Cifrado, hashing y codificación: la confusión clásica

    Uno de los orígenes más comunes de A02 es no distinguir correctamente entre tres conceptos fundamentales:

    Cifrado Es un proceso reversible. Sirve para proteger datos que más adelante deben recuperarse, como información personal o datos almacenados.

    Hashing Es un proceso irreversible. Está pensado para verificar, no para recuperar. Por eso es la técnica correcta para almacenar contraseñas.

    Codificación No es un mecanismo de seguridad. Base64, por ejemplo, solo transforma datos para facilitar su transporte. Cualquiera puede revertirlo.

    Cuando una aplicación mezcla estos conceptos, el resultado suele ser desastroso.


    Contraseñas: el punto más frágil del sistema

    Las contraseñas merecen un capítulo propio dentro de A02. No porque sean un mecanismo perfecto, sino porque siguen siendo el más usado.

    Errores críticos que todavía se ven en producción:

    • Contraseñas almacenadas en texto plano
    • Contraseñas cifradas con clave reversible
    • Hashes rápidos sin salt

    La práctica correcta implica:

    • Algoritmos diseñados específicamente para contraseñas
    • Uso de salt único por usuario
    • Coste computacional suficiente para frenar ataques de fuerza bruta

    Aquí no hay atajos. Si las contraseñas se gestionan mal, todo el sistema cae detrás.


    HTTPS no lo soluciona todo

    HTTPS protege los datos en tránsito, pero no garantiza que:

    • Se usen versiones seguras de TLS
    • Las cookies estén correctamente configuradas
    • No haya contenido mixto
    • Los datos se almacenen de forma segura en el servidor

    Es posible tener un candado verde en el navegador y, aun así, estar filtrando información sensible sin darse cuenta.

    HTTPS es una condición necesaria, pero nunca suficiente.


    Tokens, sesiones y APIs modernas

    Las aplicaciones actuales dependen cada vez más de APIs y tokens de autenticación. Y aquí aparecen nuevos fallos criptográficos:

    • Tokens predecibles
    • JWT sin firma o mal configurados
    • Tokens expuestos en URLs
    • Almacenamiento inseguro en el cliente

    Muchos de estos errores no rompen la funcionalidad, pero sí la seguridad. El sistema “funciona”, hasta que alguien decide mirarlo con mentalidad de auditor.


    Datos sensibles: no todo vale lo mismo

    Uno de los errores de diseño más comunes es no clasificar los datos.

    No toda la información requiere el mismo nivel de protección, pero hay datos que nunca deberían almacenarse sin medidas criptográficas adecuadas, como:

    • Credenciales
    • Identificadores personales
    • Tokens de acceso
    • Información financiera

    A esto se suman los grandes olvidados: backups, logs y ficheros temporales, que a menudo contienen más información sensible que la propia base de datos principal.


    Pensar como auditor: detectar A02

    Detectar fallos criptográficos no siempre requiere herramientas avanzadas. Muchas veces basta con observar:

    • Cómo se gestionan las contraseñas
    • Qué información aparece en cookies y cabeceras
    • Qué algoritmos se usan realmente
    • Dónde se almacenan los secretos

    La automatización ayuda, pero el criterio humano es insustituible. Un escáner puede avisar; un profesional entiende el impacto.


    Buenas prácticas: menos magia, más criterio

    La criptografía segura no consiste en usar lo último, sino en usar lo adecuado:

    • Algoritmos actuales y bien mantenidos
    • Gestión centralizada de secretos
    • Separación de responsabilidades
    • Decisiones documentadas

    La seguridad madura no se basa en trucos, sino en disciplina técnica.


    Conclusión

    OWASP A02 no trata de romper sistemas. Trata de recordar algo esencial: los datos tienen valor, y protegerlos es una responsabilidad técnica y ética.

    La mayoría de los fallos criptográficos no ocurren por falta de herramientas, sino por falta de comprensión. Por eso este punto es clave en cualquier formación técnica: obliga a pensar, a cuestionar y a asumir que la seguridad no es un añadido, sino parte del diseño.

    Cuando la criptografía falla, no hay parche que lo arregle después. Solo queda aprender… y hacerlo mejor la próxima vez.